Modèles frontier open-weight vs API fermées : l’arbitrage de souveraineté
Open-weight vs API fermées : souveraineté, coût, conformité et quand un lab ou une entreprise doit vraiment héberger ses poids.
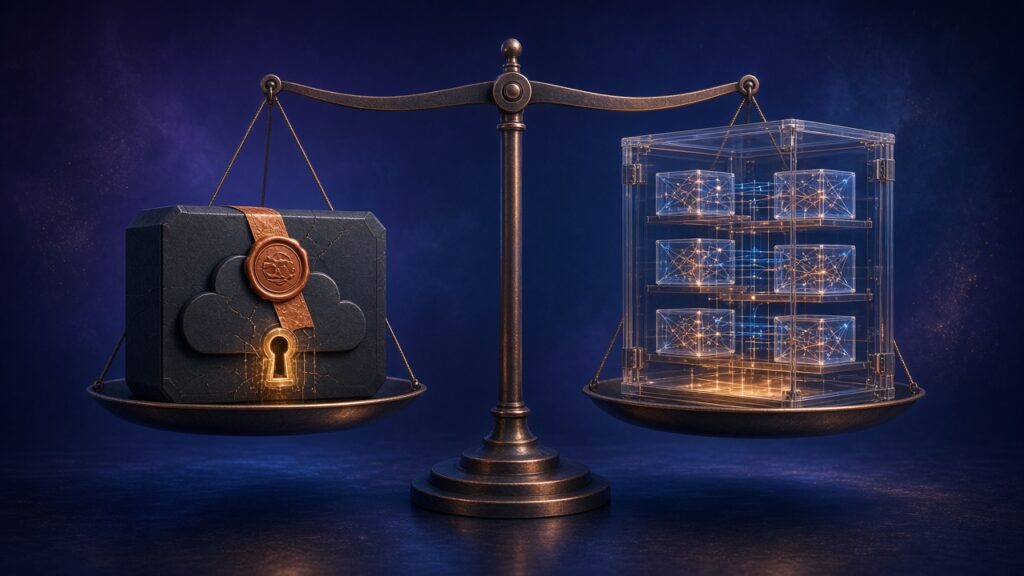
Choisir entre des modèles open-weight que l’on peut héberger et des API frontier fermées n’est pas un concours de beauté : c’est une décision de souveraineté, de coût et de contrôle.
Les équipes IA d’entreprise ne sont plus réduites au dilemme « utiliser GPT ou ne rien bâtir ». Des sorties LLM open weight de plusieurs labs suivent la frontière fermée de quelques mois seulement sur les indices de capacité agrégés, tandis que les plateformes développeurs routent des dizaines de milliers de milliards de tokens via des endpoints open en self-serve. Dans le même temps, les dollars LLM d’entreprise restent concentrés sur les API fermées. La vraie question de 2026 n’est pas quel camp « gagne », mais quel mix de modèles IA auto-hébergés, d’inférence open-weight hébergée et d’API fermées correspond à vos contraintes de souveraineté IA, de conformité et d’économie unitaire.
Cet article cartographie l’arbitrage avec des preuves publiques : à quel point les open weights sont proches en capacité, où vont réellement tokens et dollars, ce que « ouvert » signifie sous les règles européennes, et quels critères de décision survivent au contact des GPU, du silicium edge et des auditeurs.
Ce que « ouvert » signifie réellement en 2026
« Open weight » n’est pas synonyme d’open source. Les poids peuvent être téléchargeables sous licences style Apache ou MIT, sous licences communautaires sur mesure avec plafonds d’usage, ou sous des termes qui interdisent certains usages commerciaux. Les cartes d’architecture, les recettes d’entraînement et les inventaires de datasets forment un autre axe. La Open Source AI Definition de l’Open Source Initiative reste une barre plus stricte que « des poids sur un hub », et nombre de sorties populaires ne la franchissent pas — même lorsqu’elles sont très utilisables en production.
Le droit produit européen force désormais le vocabulaire. Sous la voie de l’article 53(2) de l’AI Act de l’UE pour les modèles d’IA à usage général, les fournisseurs qui publient un modèle sous licence libre et open source — avec paramètres incluant poids, architecture et informations d’usage publiquement disponibles — peuvent être exemptés de certaines obligations documentaires envers les autorités et les fournisseurs en aval, et de la désignation d’un représentant autorisé pour les fournisseurs hors UE. Ces exemptions ne s’appliquent pas aux modèles classés GPAI à risque systémique. Même lorsque les exemptions documentaires s’appliquent, une politique de conformité au droit d’auteur et un résumé suffisamment détaillé du contenu d’entraînement restent requis. Pour les acheteurs, la leçon pratique est nette : traitez « ouvert » comme une checklist de conformité, pas comme un adjectif marketing.
Le texte de licence compte toujours, même quand les poids sont publics. Les grants Apache-2.0 et style MIT passent proprement la plupart des revues juridiques d’entreprise. Les licences communautaires sur mesure — fréquentes chez les grandes familles Llama et certaines lignes Mistral — peuvent restreindre l’usage par des fournisseurs de modèles concurrents, imposer des politiques d’usage acceptable, ou changer l’histoire de redistribution des produits que vous livrez. Traitez le fichier de licence comme un artefact de premier rang à côté du shard GGUF ou safetensors : si le juridique ne peut pas le valider pour votre bande de MAU ou votre géographie, le modèle n’est pas « disponible » pour la production, quelle que soit la force du graphique d’éval.
L’auto-hébergement ajoute une couche. Faire tourner des poids dans votre VPC, on-prem ou en environnement air-gapped achète résidence des données et inspectabilité qu’une API frontier multi-tenant ne peut égaler. Héberger les mêmes open weights via une API d’inférence tierce achète commodité et élasticité — mais réintroduit une frontière fournisseur. La conception de portefeuille doit nommer laquelle de ces trois surfaces chaque charge utilise : API frontier fermée, API open-weight hébergée, ou auto-hébergé / sur appareil.
Capacité : un retard durable, pas un gouffre
Le suivi Epoch Capabilities Index (ECI) d’Epoch AI montre que, depuis janvier 2026, les modèles open-weight les plus capables ont accusé un retard moyen d’environ quatre mois sur les modèles fermés de pointe, avec un écart ECI moyen d’environ huit points — de l’ordre de l’écart qu’Epoch associe à des sorties fermées successives telles que GPT-5 versus GPT-5.5. C’est un chiffre de planification, pas une condamnation. Quatre mois, c’est assez court pour que fine-tuning, retrieval, tool use et routage en cascade referment souvent l’écart produit sur des tâches définies, et assez long pour que les équipes chassant le raisonnement frontier absolu, la profondeur multimodale ou de toutes nouvelles fonctions d’agent préfèrent encore les API fermées pour la pointe de la pile.
La recherche Mixture-of-Agents illustre l’autre face du bilan : une collaboration en couches entre modèles ouverts peut dépasser une baseline fermée forte sur des benchmarks de préférence. Dans l’article MoA Together / académique de 2024, un Mixture-of-Agents uniquement open a atteint 65,1 % de win rate contrôlé en longueur sur AlpacaEval 2.0 contre 57,5 % pour GPT-4 Omni dans cette comparaison — preuve que l’orchestration, pas seulement le nombre de paramètres, déplace la frontière de Pareto. Les cascades coupent l’autre voie sur le coût : FrugalGPT (2023) a montré qu’un routage de requêtes à travers des API LLM hétérogènes peut égaler la précision d’un modèle individuel de tête avec jusqu’à environ 98 % de réduction de coût sur la tâche finance HEADLINES de cette étude (environ 73 % sur OVERRULING et environ 59 % sur COQA), ou améliorer la précision à dépense égale. Ces articles précèdent les model cards d’aujourd’hui, mais la leçon architecturale est pérenne : routez, ne idolâtrez pas un seul endpoint.
Tokens versus dollars : deux marchés différents
La télémétrie d’usage et les dépenses d’entreprise racontent des histoires différentes — et les deux comptent pour planifier la souveraineté.
Fin 2025, l’étude State of AI d’OpenRouter — bâtie sur environ 100 000 milliards de tokens de trafic plateforme sur cette fenêtre — trouve les modèles open-weight à environ un tiers du volume de tokens en fin de période, les familles open chinoises (DeepSeek, Qwen et pairs) contribuant largement à cette tranche open après les vagues de sorties de mi-2025. Roleplay et programmation dominent le mix de catégories open-weight sur cette plateforme ; les modèles propriétaires portent encore une grande part du coding et du travail de connaissance à plus fort enjeu. La structure duale est durable : les systèmes fermés définissent le plafond de fiabilité que beaucoup d’entreprises achètent ; les systèmes ouverts absorbent le volume sensible au coût et à la personnalisation.
La part dollar entreprise paraît plus conservatrice. Selon le State of Generative AI in the Enterprise 2025 de Menlo Ventures, les dépenses d’IA générative s’élèvent à environ 37 milliards de dollars, dont environ 12,5 milliards sur les API de modèles de fondation. Les modèles open-source / open-weight représentent environ 11 % de l’usage API LLM d’entreprise dans ce cadre d’enquête — en baisse depuis environ 19 % l’année précédente — tandis qu’Anthropic, OpenAI et Google prennent ensemble la vaste majorité de la part API entreprise payante. Les modèles open chinois restent une mince tranche des dollars API entreprise même s’ils bondissent chez les développeurs. La mise à jour mi-2025 de Menlo situait de même les modèles fermés derrière la grande majorité des charges d’entreprise et décrivait la performance open comme accusant un retard d’environ neuf à douze mois sur la frontière fermée dans cette fenêtre.
Ces chiffres de retard ne sont pas tant contradictoires qu’incomparables. L’écart ECI ~quatre mois / ~huit points d’Epoch est une mesure continue et agrégée d’indice de capacité couvrant les sorties open versus fermées depuis janvier 2026. L’estimation neuf à douze mois de Menlo est un cadrage plus ancien, enquête et marché, de la performance open pertinente pour l’entreprise versus la pointe fermée à mi-2025. Horloges différentes, méthodes différentes, même histoire directionnelle : les open weights suivent la frontière fermée, et l’écart se mesure en mois — pas en années.
Lus ensemble : les modèles IA auto-hébergés et les API open gagnent l’esprit et la part de tokens là où prix, personnalisation et expérimentation dominent ; les API fermées gagnent encore là où achats, SLA de support et qualité de pointe dominent. Les programmes de souveraineté qui ne regardent qu’un de ces graphiques sous-dimensionneront la pile.
Coût, contrôle et conformité
Le coût n’est pas « prix API × tokens »
Les API fermées convertissent les tokens marginaux en opex presque sans planification de capacité. L’auto-hébergement convertit le même travail en amortissement GPU, énergie, réseau, temps SRE, harnais d’évaluation et patchs de sécurité. Les API open-weight hébergées se situent entre les deux : vous payez la courbe d’utilisation de quelqu’un d’autre mais gardez le choix du modèle. Cascades et petits modèles spécialistes (y compris des open weights mid-size quantifiés) battent souvent « toujours appeler la frontière » sur le coût par résultat réussi — la métrique vers laquelle FrugalGPT et MoA poussent tous deux les équipes.
Les effets à la Jevons s’appliquent encore. À mesure que l’inférence open et fermée devient moins chère, la demande totale de tokens monte. Le commentaire 2025 de Menlo attendait déjà que les dépenses nettes d’IA générative continuent de grimper même si les coûts unitaires d’inférence baissent. La souveraineté ne signifie pas automatiquement « moins cher » ; elle peut signifier « prévisible », « auditable » ou « air-gappable ».
Une métrique interne utile est le coût par résultat accepté : résolution de ticket réussie, extraction correcte ou brouillon approuvé par un humain — pas les dollars bruts par million de tokens. Des appels frontier fermés qui terminent un cas dur en un coup peuvent battre une cascade open économe qui réessaie cinq fois et escalade quand même vers un humain. Inversement, router quatre-vingt-dix pour cent du trafic facile vers un modèle open mid-size quantifié peut financer les dix pour cent qui ont réellement besoin de la pointe fermée. Mesurez les deux jambes avant de déclarer un vainqueur.
Contrôle et inspectabilité
Les poids que vous détenez peuvent être hachés, épinglés en version, red-teamés offline, fine-tunés sur des corpus réglementés, et exécutés sans envoyer de prompts vers un pays tiers. Les API fermées donnent des contrôles contractuels, des endpoints régionaux et des options zéro rétention — mais pas l’inspectabilité bit à bit du modèle que vous avez appelé hier. Pour les environnements à haute assurance, cette distinction est le cœur de la souveraineté IA : qui peut changer le modèle, qui peut voir les prompts, et qui peut prouver quel artefact a produit une décision.
La conformité est scopée à la charge
L’inférence air-gapped aide pour la résidence des données ; elle n’efface ni les questions de provenance des données d’entraînement, ni les devoirs de politique copyright pour les fournisseurs GPAI, ni les règles sectorielles sur les décisions automatisées. Les exemptions open source de l’AI Act de l’UE réduisent certaines charges documentaires GPAI ; elles ne créent pas de laissez-passer pour les modèles à risque systémique ni pour les déployeurs de systèmes d’IA à haut risque. Le langage d’achat devrait exiger : compatibilité de licence pour votre cas d’usage, une model card et une suite d’évaluation nommées, journalisation des IDs de modèle et des prompts dans votre plan de contrôle, et un repli documenté si un fournisseur fermé change de termes ou de régions.
Matériel : la porte silencieuse de l’auto-hébergement
Les fantasmes de souveraineté meurent sur la bande passante mémoire et la capacité de KV-cache. Les specs d’accélérateur primaire fixent le plafond : le H200 de NVIDIA, par exemple, embarque 141 Go de HBM3e et 4,8 To/s de bande passante mémoire — près du double de la capacité H100 et environ 1,4× sa bande passante — et NVIDIA cite jusqu’à environ 2× d’inférence Llama-2 plus rapide versus H100 sur des notes de charge publiées. Les checkpoints MoE open de classe frontier veulent encore des nœuds multi-GPU, une interconnexion rapide et une ingénierie d’inférence sérieuse. Le logiciel de serving compte autant que le silicium : la lignée vLLM / PagedAttention a montré des gains de débit 2–4× versus des systèmes antérieurs à latence comparable en paginant le KV-cache et en permettant le continuous batching — exactement le type d’utilisation dont vous avez besoin avant que l’auto-hébergement ne tienne la route.
Les modèles open mid-size dans la bande approximative 15B–70B — la cohorte « medium is the new small » d’OpenRouter fin 2025 — sont là où beaucoup d’entreprises trouvent une qualité déployable sur un seul accélérateur à haute mémoire ou un petit cluster. Les variantes sub-15B et fortement quantifiées poussent plus loin vers les workstations et les appareils edge quand latence, fonctionnement offline ou coût par requête dominent.
C’est pourquoi les badges IA en périphérie et Accélérateurs IA & puces appartiennent à ce sujet. L’inférence on-device et near-edge rétrécit la frontière de confiance : les prompts ne quittent jamais les locaux, et le choix de silicium (GPU, NPU, accélérateur sur mesure) devient partie du produit. Les enquêtes entreprise de Menlo signalaient déjà des modèles qui migrent vers l’edge pour la confidentialité, la latence et un coût API marginal nul. L’arbitrage est la marge de capacité : le silicium edge héberge rarement la frontière absolue. Les designs hybrides gardent un enseignant fermé ou open large dans le cloud pour les cas durs et un étudiant local pour le chemin courant.
Critères de décision pour 2026 (checklist pérenne)
Utilisez les tests suivants par charge, pas par slogan d’entreprise :
- Frontière des données. Les prompts et embeddings doivent-ils rester dans une juridiction nommée ou un air gap ? Si oui, préférez auto-hébergé ou endpoints privés strictement régionaux ; traitez les API multi-tenant publiques comme dernier recours.
- Plafond de capacité. La tâche a-t-elle besoin de la frontière fermée actuelle (nouveaux outils d’agent, raisonnement le plus dur, cas limites multimodaux) ? Si oui, achetez l’API fermée pour cette tranche et gardez les open weights pour la longue traîne.
- Forme du volume. La charge est-elle haut QPS, répétitive et évaluable ? Cascades, modèles open mid-size et caches gagnent en général l’économie unitaire.
- Contrôle du changement. Faut-il geler les poids pour validation (médical, industriel, cas de sécurité) ? Des open weights que vous épinglez battent des révisions API hebdomadaires opaques.
- Licence et ajustement Act. Confirmez que la licence autorise votre MAU, géographie et histoire de redistribution ; cartographiez les devoirs GPAI si vous redistribuez ou modifiez substantiellement.
- Maturité ops. Avez-vous SRE GPU, régression d’éval et réponse à incident pour le serving de modèles ? Sinon, les API open-weight hébergées sont une marche — pas un échec.
- Option de sortie. Pouvez-vous changer de fournisseur en une semaine ? Abstrayez derrière un routeur interne tôt ; l’habitude multi-modèles style OpenRouter est un motif de résilience, pas seulement une astuce de prix.
Un défaut sobre pour beaucoup d’entreprises régulées en 2026 : API fermées pour la qualité de pointe et le travail de connaissance indifférencié, open weights auto-hébergés ou en VPC pour les chemins sensibles et à fort volume, et modèles edge pour les fonctions offline / ultra faible latence — avec une cascade interne qui ne promeut que lorsque les paliers moins chers échouent à une porte qualité automatisée.
En résumé
L’arbitrage de souveraineté n’est pas « open bon, fermé mauvais ». Le retard ECI ~quatre mois / ~huit points d’Epoch (depuis janvier 2026) dit que les open weights sont assez proches pour compter. La part de tokens open ~un tiers d’OpenRouter fin 2025 dit que les développeurs votent déjà avec le trafic. La part open ~11 % de l’usage LLM d’entreprise de Menlo dans son enquête 2025 dit que l’argent et les comités risque penchent encore fermé. L’article 53(2) de l’AI Act de l’UE dit que « ouvert » est un statut juridique avec des devoirs résiduels, pas une ambiance.
Les équipes qui gagnent traitent le choix de LLM open weight comme une construction de portefeuille : mesurer la capacité sur vos évals, tarifer le succès pas les tokens, placer le silicium là où la résidence l’exige, et garder une sortie contractuelle de chaque dépendance fermée. La souveraineté IA, c’est la capacité de prouver où l’inférence a tourné, quel artefact a décidé, et comment vous continueriez si un fournisseur ou une frontière fermait demain.
Lectures associées
- Les agents computer-use entrent en production : ce qui fonctionne réellement en entreprise
- Dans le marché des accélérateurs IA : GPU, ASIC sur mesure et qui gagne l’inférence
- Navigateur, IDE et OS : les trois champs de bataille des interfaces IA
Références
- Open models lag state-of-the-art closed models by 4 months | Epoch AI — Edwards & Emberson ; retard ~4 mois et écart ECI moyen ~8 points depuis janvier 2026.
- State of AI (OpenRouter / a16z) — Aubakirova et al., déc. 2025 ; étude ~100T tokens ; part open-weight ~1/3 des tokens en fin de période.
- 2025: The State of Generative AI in the Enterprise | Menlo Ventures — enquête entreprise 2025 : ~37 Md$ genAI ; ~12,5 Md$ API fondation ; modèles open ~11 % de l’usage LLM entreprise (depuis ~19 %).
- 2025 Mid-Year LLM Market Update | Menlo Ventures — mise à jour mi-2025 : dominance closed-source ; open en retard ~9–12 mois (cadrage enquête/marché).
- How does the AI Act apply to general-purpose AI models released as open-source? | AI Act Service Desk — exemptions art. 53(2), carve-out risque systémique, devoirs résiduels.
- Mixture-of-Agents Enhances Large Language Model Capabilities (arXiv:2406.04692) — Wang et al., 2024 ; MoA open 65,1 % vs GPT-4o 57,5 % LC win rate sur AlpacaEval 2.0.
- FrugalGPT (arXiv:2305.05176) — Chen, Zaharia & Zou, 2023 ; routage cascade ~98 % réduction coût sur HEADLINES, ~73 % OVERRULING, ~59 % COQA.
- NVIDIA H200 GPU — 141 Go HBM3e, 4,8 To/s ; jusqu’à ~2× inférence Llama-2 vs H100.
- Efficient Memory Management for Large Language Model Serving with PagedAttention (arXiv:2309.06180) — Kwon et al. (vLLM) ; débit 2–4× via KV-cache paginé.
Images : illustrations originales créées pour AndBeyond.Tech ; aucun logo ni aucune personne réelle n’y figurent.