L’IA embarquée en 2026 : NPU, modèles locaux et ce qui exige encore le cloud
L’IA embarquée en 2026 : NPU de Qualcomm, Apple, Intel, AMD et MediaTek, LLM locaux, limites de la confidentialité et ce qui exige encore le cloud.
Ouverture : smartphones et PC embarquent désormais du silicium neuronal dédié pour une inférence privée et à faible latence.
Pendant l’essentiel du boom de l’IA générative, « intelligent » voulait dire « connecté ». Une requête quittait votre téléphone, traversait un data center et revenait sous forme de texte ou d’image. En 2026, ce schéma n’est plus la règle pour les assistants du quotidien. L’IA embarquée — l’inférence exécutée sur le téléphone ou le PC lui-même — est devenue une catégorie de produits à part entière, avec son propre silicium, ses propres familles de modèles et son propre argument de confidentialité.
Ce basculement n’a pas fait disparaître le cloud. Les modèles multimodaux de pointe, les agents de recherche à long contexte et l’entraînement lourd restent dans les data centers. Ce qui a changé, c’est la répartition : une part croissante du résumé, de la reformulation, de la traduction, des effets photo et des agents personnels tourne désormais en local sur du matériel NPU IA, souvent avec un petit LLM local comme cerveau. Cet article dresse la carte de ce paysage : ce que promettent réellement les NPU des puces actuelles de Qualcomm, Apple, Intel, AMD et MediaTek ; quelles charges conviennent à un modèle local ; et ce qui exige encore le cloud.
Pourquoi l’IA embarquée a percé
Trois pressions ont poussé les fabricants dans la même direction.
Latence et fiabilité. Les fonctions qui doivent paraître instantanées — sous-titres en direct, filtres caméra permanents, traduction hors ligne — ne peuvent pas dépendre de la qualité du réseau. Un NPU (Neural Processing Unit) est un bloc spécialisé dans les calculs matriciels et tensoriels. Associé à un modèle quantifié qui tient dans la mémoire de l’appareil, il peut répondre sans aller-retour vers un serveur.
Confidentialité et réglementation. Particuliers comme entreprises préfèrent de plus en plus que brouillons, photos, contexte d’agenda et audio du micro restent sur l’appareil. Les éditeurs de plateformes en font désormais un argument explicite : les recommandations de Microsoft pour les PC Copilot+ placent un NPU haute performance au centre des fonctions d’IA de Windows ; la pile Apple Intelligence d’Apple s’appuie sur le Neural Engine et des accélérateurs associés pour ses outils embarqués.
Consommation. Traiter chaque requête dans le cloud sollicite la radio et vide la batterie. Un NPU que les fabricants annoncent à quelques dizaines de TOPS (milliers de milliards d’opérations par seconde) peut maintenir l’inférence interactive dans l’enveloppe énergétique d’un téléphone ou d’un portable — à condition que le modèle soit assez petit et quantifié de façon assez agressive.
Les TOPS de crête sont des chiffres marketing, pas une expérience utilisateur. L’industrie s’est néanmoins accordée sur un seuil pratique pour Windows : Microsoft définit les PC Copilot+ comme des machines Windows 11 dotées d’un NPU de plus de 40 TOPS, avec les minimums habituels de mémoire et de stockage pour les fonctions d’IA locale avancées.
La carte du silicium en 2026
Qualcomm : le NPU Hexagon au cœur des smartphones
La gamme phare Snapdragon de Qualcomm fait du NPU Hexagon le centre de l’IA agentique mobile. Dans la fiche produit officielle du Snapdragon 8 Elite Gen 5, Qualcomm annonce un NPU Hexagon 37 % plus rapide que celui du Snapdragon 8 Elite précédent, avec des performances IA par watt améliorées de 16 %. La fiche détaille aussi une large prise en charge numérique — de l’INT2 au FP16, précision mixte comprise — et un Sensing Hub doté de deux micro-NPU pour les graphes audio, vocaux et capteurs toujours actifs, qui alimentent une base de connaissances personnelle stockée sur l’appareil.
Ces gains relatifs comptent davantage qu’un chiffre de TOPS mis en avant. Les fabricants de téléphones s’intéressent au nombre de tokens par seconde soutenu pour un LLM local de 3 à 8 milliards de paramètres, à la cohabitation avec les traitements photo, et à la capacité d’un agent à continuer de travailler radio coupée. Le discours de Qualcomm autour de la Gen 5 cible explicitement des assistants agentiques qui agissent à partir du contexte local, au lieu de simplement répondre à des requêtes de chat.
Fin 2026, la documentation du Snapdragon 8 Elite Gen 6 qui lui succède met en avant une mémoire partagée du NPU plus importante sur la puce et un Hexagon Element Accelerator dédié aux calculs des transformers — preuve, une fois de plus, que c’est la localité mémoire, et pas seulement le nombre d’opérations de crête, qui limite l’IA générative locale.
Apple : Neural Engine et Neural Accelerators dans le GPU
Apple a été parmi les premiers à livrer un Neural Engine dédié et n’a cessé d’étoffer l’architecture IA qui l’entoure.
- Le Neural Engine de la puce M4 est annoncé par Apple à 38 000 milliards d’opérations par seconde, les accélérateurs ML du CPU et le GPU formant avec lui un chemin d’IA embarquée combiné.
- La M5 (annoncée en octobre 2025) conserve un Neural Engine à 16 cœurs et ajoute un Neural Accelerator dans chaque cœur GPU ; Apple revendique une puissance de calcul GPU de crête pour l’IA multipliée par plus de 4 par rapport à la M4 et une bande passante de mémoire unifiée de 153 Go/s (environ 30 % de plus que la M4). Apple présente cette bande passante comme ce qui permet de garder des modèles plus grands entièrement sur l’appareil, sur MacBook Pro, iPad Pro et Vision Pro.
- Sur iPhone, les articles consacrés à la génération A18 / A18 Pro évoquaient un Neural Engine à 16 cœurs de l’ordre de 35 TOPS pour les tâches d’Apple Intelligence ; la communication d’Apple sur Apple Intelligence continue d’insister sur une conception hybride — traitement sensible sur l’appareil, et Private Cloud Compute lorsqu’un modèle plus grand est nécessaire.
La leçon d’Apple pour 2026 est architecturale : le NPU IA est nécessaire, mais pas suffisant. Ce sont la bande passante mémoire et les chemins tensoriels du GPU qui déterminent si un modèle de diffusion local ou un LLM local de taille moyenne est réellement utilisable.
Intel : Lunar Lake franchit la barre, Arrow Lake souvent pas
Sur les PC Windows, l’exigence de Microsoft d’un NPU de plus de 40 TOPS a tracé une ligne de partage nette.
D’après des articles fondés sur la documentation d’Intel, le NPU des Core Ultra 200V (Lunar Lake) atteint environ 48 TOPS, assez pour la certification Copilot+. À l’inverse, de nombreuses puces Arrow Lake Core Ultra 200H / 200HX étaient documentées à environ 13 TOPS côté NPU (autour de 11 TOPS sur certaines références 200U) — sous le plancher NPU de Copilot+ —, même lorsqu’Intel mettait en avant des « TOPS plateforme » cumulés CPU, GPU et NPU proches de 99.
Ce clivage est la preuve la plus visible pour le grand public que l’IA embarquée ne se résume pas à un autocollant « AI PC ». Les acheteurs qui veulent Windows Studio Effects, des fonctions de type Recall et d’autres expériences réservées aux NPU doivent vérifier la puissance du NPU, et pas seulement la marque Core Ultra.
AMD : XDNA 2 et la classe des 50 TOPS
La série Ryzen AI 300 d’AMD, présentée au Computex 2024 et largement présente dans les portables de 2025-2026, embarque un NPU XDNA 2 allant jusqu’à 50 TOPS (les puces HX haut de gamme comme le AI 9 HX 375 étant annoncées par AMD à 55 TOPS). AMD a explicitement présenté cette gamme comme prête pour Copilot+ et fait de l’IA locale un argument de confidentialité et de réactivité pour les portables Windows.
Pour notre propos, AMD montre qu’une fois le seuil chiffré fixé par Microsoft, les fabricants x86 se sont empressés de le franchir avec du silicium NPU dédié plutôt qu’en comptant sur le seul iGPU.
MediaTek : la logique du double NPU sur les Android haut de gamme
Le Dimensity 9500 de MediaTek (annoncé en septembre 2025) pousse un discours à double NPU : un NPU 990 haute performance avec le Generative AI Engine 2.0, et un Super Efficient NPU à calcul en mémoire pour les modèles légers toujours actifs. Selon les communiqués de MediaTek, la plateforme double la puissance de calcul par rapport à la génération précédente, introduit le traitement de grands modèles BitNet 1,58 bit avec jusqu’à 33 % de consommation en moins sur ce chemin, une génération deux fois plus rapide pour un LLM de 3 milliards de paramètres par rapport à la génération précédente et le traitement de textes longs jusqu’à 128K tokens, en plus de la génération d’images 4K sur l’appareil. Les analystes (Counterpoint, par exemple) situent le débit IA de crête de la classe 9500 aux alentours de 100 TOPS — un repère utile, mais secondaire par rapport aux chiffres relatifs de MediaTek.
L’orientation est claire : le silicium Android haut de gamme suppose désormais à la fois des modèles de perception toujours actifs et des rafales de travail génératif sur un LLM local.
LLM locaux : ce qui tient réellement sur un téléphone ou un PC
Le matériel ne compte que si la pile logicielle peut y installer un modèle utile. En 2026, un « LLM local » désigne généralement un modèle d’environ 1 à 8 milliards de paramètres (parfois plus sur les PC bien dotés en RAM), quantifié en 4 bits ou moins et exporté via ONNX, ExecuTorch, Core ML, MLX ou les hubs IA des fabricants.
Rôles typiques sur l’appareil :
- Reformuler, résumer et rédiger des documents courts ou des fils de mails.
- Réponses augmentées par recherche (RAG) dans les notes, messages ou un index personnel stockés sur l’appareil.
- Assistants multimodaux qui légendent une photo ou en extraient le texte sans l’envoyer en ligne.
- Ossature d’agent qui planifie les appels d’outils en local, puis bascule éventuellement vers le cloud.
Le chemin Windows ML / ONNX Runtime de Microsoft, les packs Qualcomm AI Hub, le framework Foundation Models d’Apple et les déploiements locaux de classe Gemini Nano sur Android poursuivent la même idée : livrer un petit modèle quantifié que le NPU peut faire tourner à un débit de tokens interactif.
Là où les modèles locaux peinent encore — soyons honnêtes —, c’est sur la profondeur de raisonnement de pointe, les connaissances à jour sur le monde et les contextes multimodaux très longs. Un LLM local de 3 à 7 milliards de paramètres peut être excellent pour la productivité personnelle tout en restant battu par un modèle cloud de pointe sur des examens difficiles, une recherche à plusieurs étapes ou de la génération vidéo de qualité studio. C’est une caractéristique du partage edge/cloud, pas un échec du NPU IA.
Confidentialité : le vrai produit, avec des réserves
Les fabricants vendent l’IA embarquée comme une confidentialité par défaut. L’argument est en partie vrai, en partie marketing.
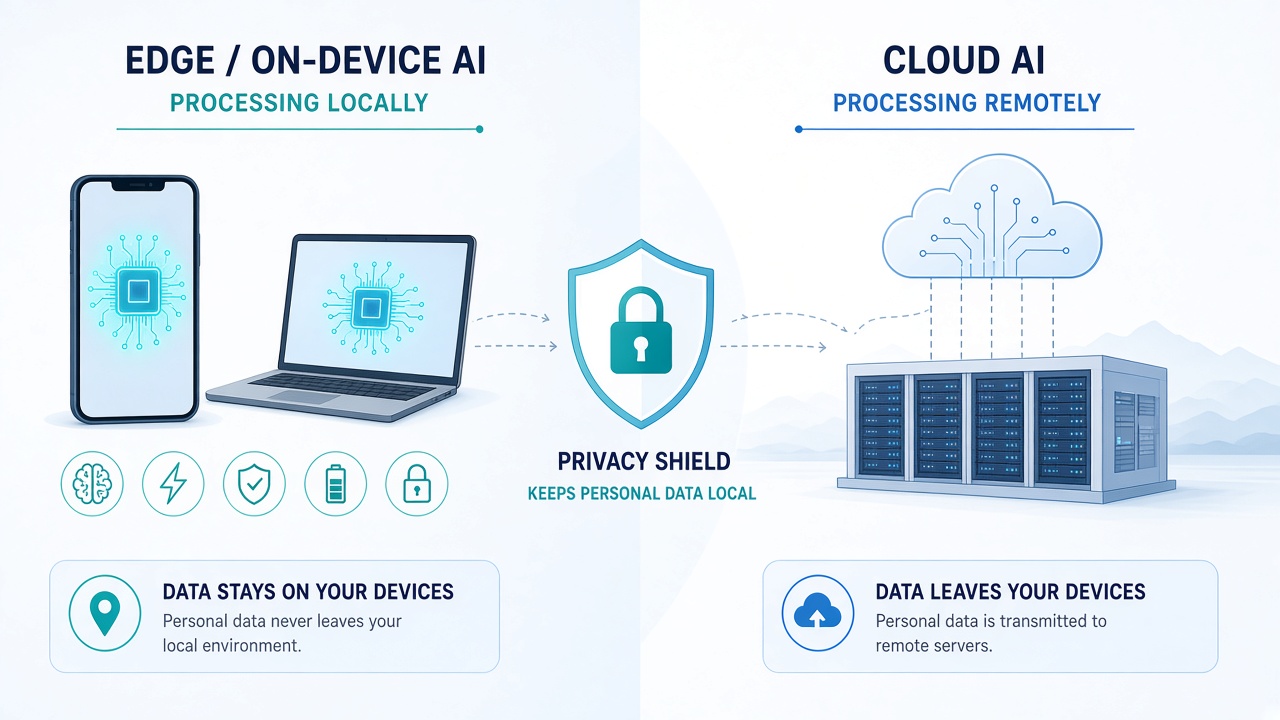
Ce qui est vrai : si l’inférence ne quitte jamais le SoC, la requête brute et le flux des capteurs n’ont pas à passer par un cluster GPU tiers. Des fonctions comme les outils Apple Intelligence exécutés sur l’appareil, ou les fonctions Windows que Microsoft documente comme locales au NPU, réduisent la surface d’attaque du « tout en clair sur la baie de quelqu’un d’autre ».
Les réserves :
- Hybride par conception. Apple, Google, Microsoft et les fabricants de téléphones continuent d’envoyer les tâches difficiles vers des modèles cloud. Private Cloud Compute et les architectures similaires cherchent à restreindre la confiance nécessaire, mais ce n’est pas la même chose qu’une inférence purement hors ligne.
- Télémétrie et comptes. L’inférence locale ne fait pas disparaître les SDK d’analyse, la synchronisation des sauvegardes ni les fonctions liées au compte.
- Local ne veut pas dire inviolable. Un téléphone compromis peut toujours lire la fenêtre de contexte d’un modèle local. Le chiffrement des poids du modèle (la fiche Gen 5 de Qualcomm mentionne le chiffrement des modèles d’IA générative) protège davantage la propriété intellectuelle que la vie privée de l’utilisateur face aux logiciels malveillants.
- Politiques d’entreprise. Les secteurs réglementés tiennent à la localisation des données et aux journaux d’audit ; un LLM local aide, mais les équipes conformité doivent encore encadrer ce qui peut basculer vers le cloud.
Pensez la confidentialité comme un schéma de flux de données, pas comme un badge. Demandez-vous : quels tokens restent sur le NPU, quels embeddings sont synchronisés, quelles requêtes quittent l’appareil ?
Ce qui exige encore le cloud
Une règle empirique utile en 2026 :
| Charge de travail | Plutôt sur l’appareil | Plutôt dans le cloud |
|---|---|---|
| Sous-titres en direct, flou, réduction de bruit | Oui | Rarement |
| Reformulation / résumé court d’un texte local | Oui | Facultatif |
| Agent personnel sur l’index agenda/mails | Surtout en local | Bascule en cas de blocage |
| Agents de code / de recherche de pointe | Assistance locale | Oui |
| Entraînement / fine-tuning de grands modèles | Petits LoRA uniquement | Oui |
| Génération d’images/vidéos de qualité studio | Brouillons / démos 4K mobiles | Qualité haut de gamme |
| Connaissances web fraîches | Cache RAG | Recherche en direct |
Le cloud reste supérieur dès qu’il faut de l’échelle (modèles énormes), de la fraîcheur (recherche en direct), de la collaboration (agents partagés) ou une puissance de calcul en rafale qui ne tiendrait jamais dans l’enveloppe thermique d’un téléphone. Les produits gagnants de 2026 rendent le relais explicite : un LLM local pour la couche privée et sensible à la latence ; le cloud quand l’utilisateur accepte un raisonnement plus poussé.
Plateformes et interfaces : comment les développeurs accèdent au NPU
Du silicium sans API reste une fonction dormante. Trois couches d’interface dominent :
- Les runtimes IA des systèmes d’exploitation — Windows ML (ONNX Runtime en coulisses, avec des fournisseurs d’exécution automatiques), Core ML / Foundation Models / Metal chez Apple, et les chemins de type AICore sur Android.
- Les hubs des fabricants — Qualcomm AI Hub et autres catalogues de modèles déjà quantifiés et validés sur des NPU précis.
- Les frameworks multi-appareils — ONNX, ExecuTorch, MLX et les piles de type llama.cpp pour les développeurs qui apportent leur propre LLM local.
Les recommandations de Microsoft aux développeurs Copilot+ sont d’une précision inhabituelle : de nombreuses expériences IA phares de Windows supposent ce NPU de plus de 40 TOPS ; le Gestionnaire des tâches affiche l’utilisation du NPU ; Windows Performance Recorder inclut des profils de traitement neuronal. Cette maturité de l’outillage compte autant que les tableaux de TOPS pour que l’IA embarquée devienne une véritable plateforme applicative.
Comment choisir un appareil fin 2026
Check-list pratique :
- Regardez la puissance du NPU, pas le slogan. Sous Windows, visez du silicium de classe Copilot+ / plus de 40 TOPS (classe Ryzen AI 300, classe Snapdragon X Elite, Intel Core Ultra 200V ou puces ultérieures qualifiées Copilot+) — pas n’importe quelle référence Core Ultra.
- Vérifiez la RAM. Les LLM locaux et les modèles de vision sont gourmands en mémoire ; 16 Go est un plancher courant pour une IA embarquée sérieuse sur PC, et davantage de marge aide pour les contextes plus longs.
- Demandez quelles fonctions marchent hors ligne. Les textes marketing brouillent la frontière entre hybride et local. Privilégiez les pages des fabricants qui précisent ce qui fonctionne sans réseau.
- Préférez des formats d’export ouverts si vous tenez à utiliser votre propre modèle (ONNX, GGUF, paquets Core ML).
- Tenez compte de la thermique. Les téléphones brident leurs performances ; le débit de tokens soutenu compte plus que la première réponse d’une démo.
En résumé
En 2026, l’IA embarquée est une véritable infrastructure, pas une bande démo. Les NPU de Qualcomm, Apple, Intel, AMD et MediaTek siègent désormais aux côtés du CPU et du GPU comme unités de calcul à part entière. De petites piles de LLM local offrent des assistants privés et à faible latence pour le travail quotidien. Le seuil de 40 TOPS des PC Copilot+ de Microsoft, le Neural Engine d’Apple épaulé par les Neural Accelerators du GPU, le XDNA 2 de classe 50 TOPS d’AMD, le contraste inégal entre Lunar Lake et Arrow Lake chez Intel et le Dimensity 9500 à double NPU de MediaTek vont tous dans le même sens : l’inférence en périphérie est devenue une exigence produit.
Le cloud n’a pas perdu. Il s’est spécialisé. L’intelligence de pointe, l’entraînement et les tâches créatives les plus exigeantes nécessitent toujours des baies entières d’accélérateurs. L’architecture mature est un partage edge/cloud assumé : garder le contexte personnel et l’inférence interactive sur le silicium NPU IA ; n’envoyer vers le haut que le travail qui exige réellement un modèle de pointe — et rendre ce relais visible pour l’utilisateur.
C’est cette répartition — et non le fantasme du « tout hors ligne » ou du « tout dans le cloud » — qui dessine la forme durable des plateformes d’IA grand public en cette fin 2026.
À lire aussi
- Edge incarné : l’IA hors ligne pour les robots et les véhicules
- Humanoïdes grand public : prix, calendrier et usages domestiques
- Modèles vision-langage-action : la nouvelle couche fondatrice des robots
< !– Schema.org NewsArticle (CF_SEO) — image paths relative to draft ; replace with absolute CDN URLs at publish –>
Références / sources
- Microsoft Learn — Copilot+ PCs developer guide (NPU > 40 TOPS definition and Windows ML guidance): https://learn.microsoft.com/en-us/windows/ai/npu-devices/
- Apple Newsroom — Apple introduces M4 chip (Neural Engine up to 38 TOPS): https://www.apple.com/newsroom/2024/05/apple-introduces-m4-chip/
- Apple Newsroom — Apple unleashes M5 (GPU Neural Accelerators, Neural Engine, 153 GB/s unified memory): https://www.apple.com/newsroom/2025/10/apple-unleashes-m5-the-next-big-leap-in-ai-performance-for-apple-silicon/
- AMD press release — AMD Unveils Next-Gen “Zen 5” Ryzen Processors… (Ryzen AI 300 / XDNA 2 up to 50 TOPS): https://ir.amd.com/news-events/press-releases/detail/1202/amd-unveils-next-gen-zen-5-ryzen-processors-to-power-advanced-ai-experiences
- Qualcomm — Snapdragon 8 Elite Gen 5 product brief (37% faster Hexagon NPU; 16% better AI perf/watt; precision list): https://www.qualcomm.com/content/dam/qcomm-martech/dm-assets/documents/Snapdragon-8-Elite-Gen-5-product-brief.pdf
- Qualcomm newsroom — Snapdragon 8 Elite Gen 5… announcement: https://www.qualcomm.com/news/releases/2025/09/snapdragon-8-elite-gen-5–the-world-s-fastest-mobile-system-on-a
- MediaTek press room — Dimensity 9500 (NPU 990, BitNet 1.58-bit, 128K context, dual/CIM NPU claims): https://www.mediatek.com/press-room/mediatek-dimensity-9500-unleashes-best-in-class-performance-ai-experiences-and-power-efficiency-for-the-next-generation-of-mobile-devices
- Counterpoint Research — MediaTek Dimensity 9500… (analyst summary including ~100 TOPS class context): https://www.counterpointresearch.com/en/insights/mediatek-dimensity-9500-powering-powering-next-gen-smartphones
- The Register — Intel’s new Arrow Lake chips can’t make the Copilot+ PC cut (Lunar Lake ~48 TOPS NPU; Arrow Lake H/HX ~13 TOPS / U ~11 TOPS): https://www.theregister.com/on-prem/2025/01/07/intels-new-arrow-lake-chips-cant-make-the-copilot-pc-cut/529267
- Gadgets 360 — Apple Introduces A18, A18 Pro… (16-core Neural Engine / ~35 TOPS reporting): https://www.gadgets360.com/mobiles/news/apple-iphone-16-series-a18-pro-chipset-details-6530448
- RCR Wireless News — Snapdragon 8 Elite Gen 6 splits on-device AI two ways (Element Accelerator; Extreme shared-memory focus): https://rcrtech.com/semiconductor-news/snapdragon-8-elite-gen-6-on-device-ai/
Images : illustrations originales créées pour AndBeyond.Tech ; aucun logo ni aucune personne réelle n’y figurent.