Entraînement multi-trillions de paramètres : ce que doit livrer la prochaine génération de silicium
Entraînement multi-trillions de paramètres : ce que la prochaine génération de silicium doit livrer en bande passante, mémoire et fabrics.
Le plafond de calcul des modèles de frontière n’est plus fixé par une seule puce. Il l’est par le système entier : combien de mémoire haute bande passante siège à côté de chaque processeur, combien de processeurs peuvent partager cette mémoire via un fabric scale-up rapide, jusqu’où le cluster scale-out au-delà du rack, et si le bâtiment peut l’alimenter et le refroidir. Ce guide de référence parcours ces quatre contraintes et regarde ce que les racks de classe NVL comme le GB200 NVL72 disent de la prochaine génération de silicium d’entraînement IA.
Pourquoi « la puce » est la mauvaise unité d’analyse
Le regard public le plus clair sur ce qu’exige réellement l’entraînement à l’échelle frontière reste l’article de Meta sur Llama 3. Meta a entraîné son modèle à 405 milliards de paramètres sur « up to 16K H100 GPUs, each running at 700W TDP with 80GB HBM3 ». Chaque serveur abritait huit GPU reliés via NVLink [1]. Ce modèle n’est qu’une fraction de l’échelle multi-trillions de paramètres pour laquelle l’industrie conçoit désormais, et pourtant l’article décrit des problèmes à chaque couche du système : capacité mémoire, topologie réseau, pannes, et oscillations de puissance assez fortes pour stresser le réseau électrique. Cette checklist sert à ce que le matériel de nouvelle génération doit résoudre.
Meta est explicite : le modèle doit être découpé pour tenir. Elle a utilisé un « 4D parallelism » combinant parallélisme tenseur, pipeline, contexte et données. L’objectif : s’assurer que « each GPU’s model parameters, optimizer states, gradients, and activations fit in its HBM » [1]. Même avec un réglage soigné, Meta a rapporté un Model FLOPs Utilization (MFU) BF16 de 38–43 % sur ses configurations principales [1]. Une large part du compute de crête reste inutilisée à cause de la mémoire et du surcoût de communication. Ce sont les deux contraintes où la prochaine génération de silicium doit livrer.
Exigence 1 : plus de HBM, et bien plus de bande passante vers elle
La mémoire haute bande passante (HBM) est la DRAM empilée placée juste à côté du die accélérateur. Pour un GPU HBM, la capacité décide combien du modèle et de son état d’entraînement peut vivre sur chaque device. La bande passante décide à quelle vitesse ces données atteignent les unités de calcul.
Le standard industriel avance vite. JEDEC a publié le standard JESD270-4 HBM4 en avril 2025. Il spécifie « transfer speeds up to 8 Gb/s across a 2048-bit interface », ce qui porte « total bandwidth up to 2 TB/s » par stack. Il double les canaux indépendants par stack de 16 à 32, et supporte des stacks jusqu’à 16 hauts avec « a higher cube density of 64GB » [2]. Parmi les déclarations industrielles du communiqué, Google Cloud indique que HBM4 « represents the big step in bandwidth that Google needs for next generation training and inference systems » [2].
Les chiffres des accélérateurs livrés et annoncés montrent la tendance :
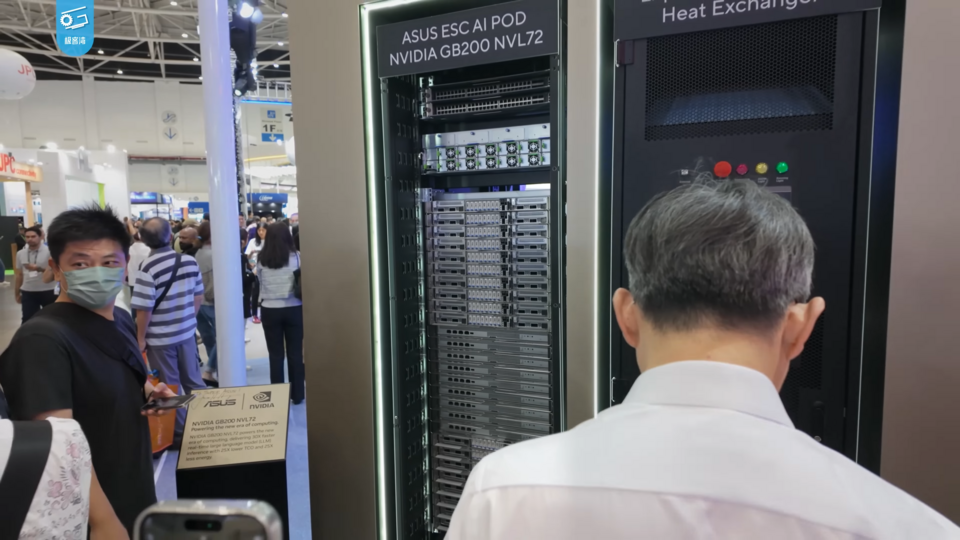
- NVIDIA GB200 NVL72 (Blackwell, HBM3E) : 13,4 To de HBM3E par rack avec 576 To/s de bande passante agrégée, soit 372 Go et 16 To/s par Superchip Grace Blackwell à deux GPU [3].
- NVIDIA Vera Rubin NVL72 (HBM4) : 288 Go de HBM4 à 19,2 To/s par GPU Rubin, et 20,7 To à 1 400 To/s par rack, selon la page produit actuelle de NVIDIA [4].
- Google TPU7x (Ironwood) : 192 Gio de HBM par puce à 7 380 Go/s, contre 95 Gio pour v5p et 32 Gio pour v6e (Trillium) [5].
La documentation Google ajoute une mise en garde valable pour tous les fournisseurs : « despite its size, HBM can still be a bottleneck, particularly for memory-bound vector operations or inefficient data access patterns » [5]. Plus de capacité permet à un job d’entraînement d’utiliser de plus grands batches et moins de shards. La bande passante décide si les unités de calcul restent réellement occupées.
Les specs publiées peuvent aussi bouger. Les pages NVIDIA elles-mêmes portent la mention « preliminary specifications ; may be subject to change » [6]. Les acheteurs qui planifient une run multi-trillions de paramètres devraient traiter les chiffres de bande mémoire comme des cibles jusqu’à mesure sur systèmes livrés.
Exigence 2 : un domaine scale-up plus grand et plus rapide
Un modèle trop grand pour un seul device doit échanger activations et gradients en permanence. Le trafic le plus gourmand en bande — parallélisme tenseur et échanges all-to-all des modèles mixture-of-experts (MoE) — doit rester dans un domaine scale-up : un groupe d’accélérateurs reliés par un fabric à sémantique mémoire bien plus rapide qu’un réseau classique.
L’article Llama 3 de Meta explique pourquoi. Les dimensions de parallélisme étaient ordonnées pour que « the innermost parallelism requires the highest network bandwidth and lowest latency, and hence is usually constrained to within the same server » [1]. Dans le cluster Meta, cela voulait dire huit GPU.
Le rack de classe NVL existe pour élargir largement cette frontière. NVIDIA décrit le GB200 NVL72 comme reliant « 36 Grace CPUs and 72 Blackwell GPUs in a rack-scale, liquid-cooled design » avec « a 72-GPU NVIDIA NVLink domain that acts as a single, massive GPU ». Son NVLink Switch System fournit « 130 terabytes per second (TB/s) of low-latency GPU communications », la cinquième génération NVLink donnant 1,8 To/s à chaque GPU [3]. Le tableau de specs NVLink de NVIDIA trace la progression :
| Génération NVLink | Plateforme | Bande passante par GPU | Domaine NVLink | Agrégé (NVL72) |
|---|---|---|---|---|
| 4e | Hopper | 900 Go/s | 8 GPU | 7,2 To/s (8 GPU) |
| 5e | Blackwell | 1 800 Go/s | 8 ou 72 GPU | 130 To/s |
| 6e | Vera Rubin | 3 000 Go/s | 8 ou 72 GPU | 216 To/s |
Source : page de spécifications NVIDIA NVLink (préliminaire) [6].
Selon NVIDIA, un rack NVL72 « can support 9x the GPU count versus a single eight-GPU system » dans un même domaine NVLink [6]. Pour la génération Vera Rubin, NVIDIA revendique que le NVL72 « trains mixture-of-experts (MoE) models with one-fourth the number of GPUs compared to NVIDIA GB200 NVL72 ». C’est une projection fondée sur « a 10T MoE model trained on 100T tokens in a fixed timeframe of 1 month » [4]. Le scénario de benchmark choisi par NVIDIA est lui-même un modèle à dix trillions de paramètres : voilà l’échelle pour laquelle l’industrie conçoit.
NVLink n’est pas la seule approche. Le TPU7x de Google relie chaque puce directement à ses voisines en tore 3D. Les slices se construisent à partir de « cubes » 4×4×4, et un pod monte jusqu’à 9 216 puces (144 cubes), avec 1 200 Go/s de bande interconnect inter-puces bidirectionnelle totale par puce [5]. Des standards ouverts arrivent aussi. Le consortium UALink a ratifié sa spécification UALink 200G 1.0 en avril 2025. Elle permet « 200G per lane scale-up connection for up to 1,024 accelerators within an AI computing pod », avec un board qui inclut AMD, AWS, Google, Intel, Meta et Microsoft [7]. Quel que soit le fabric gagnant, l’exigence est la même : des domaines cohérents plus grands, à latence prévisible.
Exigence 3 : des réseaux scale-out qui ne gaspillent pas les gains scale-up
Aucun rack ne suffit seul pour une run frontière : les designs de clusters IA NVL72 dépendent encore du networking scale-out entre racks. Là encore, l’article Meta est inhabituellement précis. Son cluster RoCE pour Llama 3 était un réseau Clos à trois couches. Les pods de 3 072 GPU avaient une bande passante de bisection pleine, mais la couche d’agrégation reliant huit pods en un cluster de 24K GPU avait « an oversubscription ratio of 1 :7 ». Meta a rendu son parallélisme et son scheduler « network topology » aware pour minimiser le trafic inter-pods [1]. Meta a aussi dû contourner des problèmes d’équilibrage de charge parce que l’entraînement LLM « produces fat network flows that are hard to load balance » [1].
Les fournisseurs mettent plus de bande et un transport plus intelligent dans le tier scale-out. NVIDIA liste 32,4 To/s de bande réseau par rack Vera Rubin NVL72, avec scale-out sur InfiniBand Quantum-X800 ou Ethernet Spectrum-X [4]. Côté ouvert, l’Ultra Ethernet Consortium a publié la spécification UEC 1.0 en juin 2025. Elle la décrit comme « a comprehensive, Ethernet-based communication stack engineered to meet the demanding needs of modern Artificial Intelligence (AI) and High-Performance Computing (HPC) workloads », couvrant « NICs, switches, optics, and cables », et dit qu’elle « scales to millions of endpoints » [8].
Le principe de design découle de l’expérience Llama 3. Placer le parallélisme le plus intensif en communication dans le domaine scale-up, et rendre le fabric scale-out assez bon pour que le trafic data-parallel et pipeline ne fasse pas caler le calcul.
Exigence 4 : densité de puissance et refroidissement liquide
Empaqueter 72 GPU dans un seul domaine NVLink, c’est les empaqueter dans un rack, et cela change le bâtiment. L’architecture de référence Vertiv co-développée avec NVIDIA pour le GB200 NVL72 « supports up to 132kW per rack ». Elle utilise un design hybride liquide et air pour « efficiently manage high-density heat removal », et scale jusqu’à un déploiement de 7 MW [9]. Les pages NVIDIA décrivent le NVL72 comme liquid-cooled. Elles indiquent que le refroidissement liquide « increases compute density, reduces the amount of floor space used, and facilitates high-bandwidth, low-latency GPU communication with large NVLink domain architectures » [3]. Pour Vera Rubin NVL72, NVIDIA liste une température d’entrée de coolant de 45 °C [4].
Le libellé NVIDIA lie les deux : le rack dense liquid-cooled est ce qui rend le grand domaine NVLink praticable [3]. L’exigence scale-up et l’exigence refroidissement sont le même problème vu sous deux angles.
La puissance n’est pas qu’une question de densité. C’est aussi la vitesse des oscillations de charge. Meta a rapporté qu’en entraînement, « tens of thousands of GPUs may increase or decrease power consumption at the same time », par exemple en attendant des checkpoints ou des opérations collectives. Cela « can result in instant fluctuations of power consumption across the data center on the order of tens of megawatts, stretching the limits of the power grid » [1]. Meta a aussi observé « a diurnal 1-2 % débit variation » liée aux températures de mi-journée qui affectent le scaling tension/fréquence GPU [1]. L’architecture Vertiv inclut « load averaging via lithium-ion battery and next generation UPS » pour « support dynamic GPU workloads » [9]. L’infrastructure commence à répondre directement à ce problème.
Exigence 5 : fiabilité à l’échelle
Plus le calcul synchrone est grand, plus chaque faute coûte cher. Meta a écrit qu’« a single GPU failure may require a restart of the entire job ». Sur un snapshot de 54 jours du pré-entraînement Llama 3, elle a enregistré 466 interruptions de job, dont 419 inattendues. Environ 78 % des inattendues étaient attribuées à des problèmes matériels confirmés ou suspectés [1]. Les GPU défaillants (148 interruptions, 30,1 %) et la mémoire HBM3 GPU (72, 17,2 %) étaient les deux plus grandes catégories [1]. Meta a quand même atteint « higher than 90 % effective training time » grâce à l’automatisation, un checkpointing plus rapide et des outils de diagnostic [1].
Pour un entraînement multi-trillions de paramètres sur bien plus de devices, la maintenabilité est une exigence silicium et système à part entière. Le switch NVLink 6 de NVIDIA ajoute « control plane resilience, the ability to run with a partially populated rack, and hot-swapping of switch trays » [6]. Le standard HBM4 de JEDEC inclut Directed Refresh Management « for improved row-hammer mitigation and Reliability, Availability, and Serviceability (RAS) » [2]. Ces fonctions attirent moins l’attention que les FLOPS, mais à l’échelle cluster elles peuvent décider si une run d’entraînement finit à l’heure.
La checklist : ce que doit livrer le silicium d’entraînement IA de nouvelle génération
En combinant les preuves ci-dessus, une plateforme crédible pour l’entraînement multi-trillions de paramètres doit livrer :
- Capacité et bande HBM qui croissent plus vite que le compute. Stacks de classe HBM4 [2] et capacité par device dans les centaines de gigaoctets [4][5], pour que paramètres, états d’optimiseur et activations puissent être shardés sur moins de devices [1].
- Un grand domaine scale-up. Des dizaines de devices ou plus, avec une bande all-to-all mesurée en téraoctets par seconde par device [3][6], ou des alternatives ouvertes comme UALink visant jusqu’à 1 024 accélérateurs [7].
- Un fabric scale-out topologie-aware. Qui limite le coût de la sursouscription [1], bâti sur InfiniBand ou Ethernet accordé à l’IA [4][8].
- Puissance rack et refroidissement conçus avec le silicium. Racks liquid-cooled de classe 100+ kW [9], avec lissage de puissance pour les oscillations de charge synchrones [1][9].
- Des fonctions de fiabilité intégrées. RAS mémoire [2], fabrics de switch résilients [6], et logiciel qui récupère automatiquement [1].
En résumé
La course à l’entraînement de modèles multi-trillions de paramètres est une course à bâtir des systèmes équilibrés. Les propres données de l’industrie montrent que capacité mémoire, bande d’interconnexion, puissance du bâtiment et gestion des pannes peuvent chacune devenir le facteur limitant avant les FLOPS bruts. Les racks de classe NVL72, HBM4 et les standards ouverts scale-up et scale-out sont les réponses actuelles de l’industrie. Pour juger le prochain lancement de silicium d’entraînement IA, regardez au-delà des FLOPS en une. Vérifiez la mémoire, la taille du domaine scale-up, les watts par rack, et la grâce avec laquelle le système encaisse la panne d’une pièce.
À lire aussi
- Marché des accélérateurs IA : GPU, ASIC custom et qui gagne l’inférence
- InfiniBand vs Ethernet pour les clusters IA : la guerre des fabrics dans l’usine d’IA
- Comment les super-usines d’IA distribuées étirent le réseau entre campus
< !– Schema.org NewsArticle (CF_SEO) — image paths relative to draft ; replace with absolute CDN URLs at publish –>
Références / Sources
- Llama Team, AI @ Meta — « The Llama 3 Herd of Models » (arXiv:2407.21783, July 2024), §3.3. https://arxiv.org/html/2407.21783v2
- JEDEC — « JEDEC and Industry Leaders Collaborate to Release JESD270-4 HBM4 Standard » (Apr 16, 2025). https://www.jedec.org/news/pressreleases/jedec%C2%AE-and-industry-leaders-collaborate-release-jesd270-4-hbm4-standard-advancing
- NVIDIA — « GB200 NVL72 » product page. https://www.nvidia.com/en-us/data-center/gb200-nvl72/
- NVIDIA — « Vera Rubin NVL72 » product page. https://www.nvidia.com/en-us/data-center/vera-rubin-nvl72/
- Google Cloud Documentation — « TPU7x (Ironwood) » (last updated Oct 29, 2026). https://docs.cloud.google.com/tpu/docs/tpu7x
- NVIDIA — « NVLink and NVLink Switch » (specifications, preliminary). https://www.nvidia.com/en-us/data-center/nvlink/
- UALink Consortium — « UALink Consortium Releases the Ultra Accelerator Link 200G 1.0 Specification » (Apr 8, 2025). https://ualinkconsortium.org/wp-content/uploads/2025/04/UALink-1.0-Specification-PR_FINAL.pdf
- Ultra Ethernet Consortium — « UEC Launches Specification 1.0 » (Jun 11, 2025). https://ultraethernet.org/ultra-ethernet-consortium-uec-launches-specification-1-0-transforming-ethernet-for-ai-and-hpc-at-scale/
- Vertiv — « Vertiv codevelops with NVIDIA complete power and cooling blueprint for NVIDIA GB200 NVL72 platform » (Oct 15, 2024). https://prod.vertiv.cn/en-asia/about/news-and-events/news-releases/vertiv-codevelops-with-nvidia-complete-power-and-cooling-blueprint-for–nvidia-gb200-nvl72-platform/
Images : illustrations générées pour AndBeyond.Tech, à l’exception de : Rack NVIDIA GB200 NVL72 en exposition — 极客湾Geekerwan, Wikimedia Commons, CC BY 3.0 ; Schéma en coupe de HBM — 思考的苇丛, Wikimedia Commons, CC BY-SA 4.0.