Modèles vision-langage-action : la nouvelle couche de base des robots
Modèles vision-langage-action (VLA) : de RT-2 à Gemini Robotics 2, π0.7 et GR00T N1.6, et pourquoi les modèles de monde sont la prochaine couche.
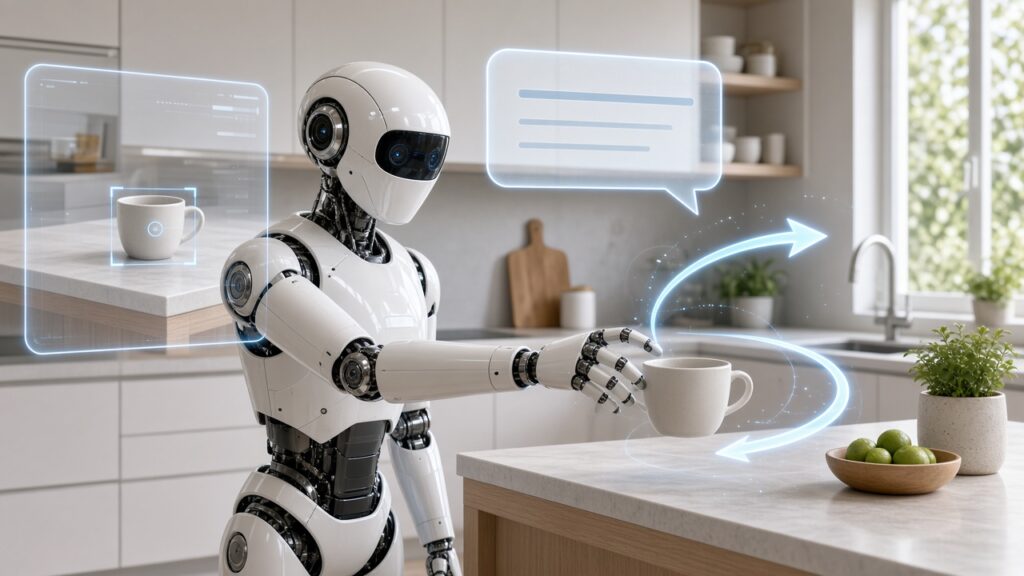
Pendant l’essentiel de leur histoire, les robots ont été des spécialistes brillants et des généralistes désespérants. Un bras de soudage peut répéter le même cordon des millions de fois, mais demandez-lui de ranger une cuisine qu’il n’a jamais vue et il n’a rien à proposer. Depuis trois ans, cela commence à changer, et la raison porte un nom : le modèle vision-langage-action, ou VLA.
Un VLA reprend les ingrédients des chatbots multimodaux actuels — un modèle préentraîné sur des images et du texte à l’échelle d’internet — et lui apprend à produire quelque chose de nouveau : des commandes motrices. En 2026, l’idée est passée du statut de curiosité de laboratoire à celui d’architecture par défaut des programmes robotiques les plus ambitieux du secteur, de Gemini Robotics 2 chez Google DeepMind à π0.7 chez Physical Intelligence, en passant par le modèle ouvert GR00T N1.6 de NVIDIA. Cet article explique ce qu’est la robotique VLA, comment le domaine en est arrivé là, quelle place occupent les modèles de monde et ce qui sépare encore un modèle de fondation robotique d’un robot auquel vous feriez confiance chez vous.
Qu’est-ce qu’un modèle vision-langage-action ?
Le terme a été popularisé par Google DeepMind en juillet 2023 avec RT-2 (Robotic Transformer 2), que DeepMind décrivait comme un modèle VLA qui « apprend à la fois des données du web et des données robotiques » et traduit ces connaissances en commande de robot [1]. L’astuce centrale était d’une simplicité désarmante. Les modèles vision-langage (VLM) prennent déjà des images et du texte en entrée et produisent des tokens de texte en sortie. RT-2 représentait les actions du robot également sous forme de tokens — des suites de nombres indiquant s’il faut s’arrêter, comment déplacer et faire pivoter l’effecteur, et de combien ouvrir la pince —, si bien qu’un VLM pouvait être affiné pour « parler » en actions sans modifier ses espaces d’entrée ni de sortie [1].
Ce cadrage a trois conséquences qui façonnent encore le domaine :
- Le transfert de connaissances. Un modèle qui a vu des milliards d’images du web sait déjà à quoi ressemblent une banane, une poubelle de tri ou la photo d’une célébrité. RT-2 pouvait exécuter des commandes impliquant des objets et des concepts absents de ses données robotiques, comme déplacer un objet sur un nombre donné sous forme d’addition (« deux plus un ») [1].
- Le raisonnement dans la boucle. DeepMind a montré qu’ajouter une courte étape de « plan » en langage naturel avant les actions — une forme de chaîne de pensée — permettait à RT-2 de gérer des instructions en plusieurs étapes, par exemple choisir un caillou comme marteau improvisé [1].
- L’échelle héritée du monde des modèles de langage. Comme un VLA est, du point de vue de l’architecture, un VLM, il hérite de l’infrastructure d’entraînement, des recettes de mise à l’échelle et des progrès rapides de l’écosystème plus large des modèles de fondation [2].
Les résultats étaient frappants pour l’époque. Sur plus de 6 000 essais robotiques, DeepMind indiquait que RT-2 triplait environ les performances de généralisation aux tests de compétences émergentes par rapport aux références antérieures, et faisait passer le taux de réussite dans des scénarios inédits de 32 % (RT-1) à 62 % [1].
Des géants fermés aux modèles ouverts : OpenVLA
RT-2 et son successeur multirobot RT-2-X étaient fermés. En juin 2024, une coalition de chercheurs de Stanford, de l’UC Berkeley, du Toyota Research Institute, de Google DeepMind, de Physical Intelligence et du MIT a publié OpenVLA, un VLA open source de 7 milliards de paramètres entraîné sur 970 000 démonstrations robotiques réelles issues du jeu de données Open X-Embodiment [2].
OpenVLA repose sur un modèle de langage Llama 2 associé à un encodeur visuel qui fusionne les caractéristiques DINOv2 et SigLIP — la partie DINOv2 aiderait au raisonnement spatial dont dépend la manipulation [2]. Son résultat phare : il surpassait de 16,5 points de pourcentage de réussite absolue le RT-2-X à 55 milliards de paramètres sur 29 tâches, avec environ sept fois moins de paramètres [2].
Les enseignements pratiques comptaient tout autant. Les auteurs ont montré qu’OpenVLA pouvait être affiné avec LoRA en n’entraînant qu’environ 1,4 % de ses paramètres tout en égalant un affinage complet, et que la quantification sur 4 bits préservait le taux de réussite tout en ramenant la mémoire GPU à environ 7 Go [2]. Le modèle complet tournait à environ 6 Hz sur une seule RTX 4090 grand public [2]. Autrement dit, un modèle de fondation robotique performant devenait soudain adaptable par un laboratoire universitaire ou une start-up sur du matériel modeste.
L’article d’OpenVLA était aussi franc sur ses limites : une seule image en entrée, une inférence trop lente pour une commande dextre à 50 Hz et une fiabilité généralement inférieure à 90 % sur les tâches testées [2]. Ces limites sont devenues la feuille de route de la génération suivante.
Physical Intelligence et la série π : des tokens au flow
Si OpenVLA a démocratisé les VLA, la start-up de San Francisco Physical Intelligence est sans doute celle qui a le plus poussé leur capacité de généralisation. Son modèle π0, suivi de π0.5 en avril 2025, s’est éloigné des tokens d’action purement discrets. π0.5 combine un décodage autorégressif de tokens pour les décisions de haut niveau et un « expert d’action » à flow matching continu qui produit des « blocs d’action » d’une seconde et de 50 pas en commandes articulaires [3]. En pratique, le modèle se dit d’abord en mots ce qu’il doit faire ensuite (« ramasser l’oreiller »), puis génère des trajectoires motrices fluides pour le faire — un seul et même modèle gérant les deux niveaux [3].
La leçon centrale de π0.5 portait sur le mélange de données plutôt que sur l’architecture. Physical Intelligence a co-entraîné le modèle sur des données du web, des étiquettes de sous-tâches de haut niveau, des consignes verbales données par des humains et des données robotiques issues de nombreux robots et environnements différents [3]. Ses études d’ablation ont montré que retirer les données du web dégradait les performances sur des objets hors distribution, tandis que retirer les données d’autres robots les dégradait partout [3]. Fait marquant : au-delà d’une centaine d’environnements d’entraînement distincts, les performances de π0.5 dans des logements entièrement nouveaux approchaient celles d’une référence entraînée directement sur l’environnement de test [3].
Les travaux 2026 de l’entreprise prolongent cette trajectoire. En mars, elle a présenté Multi-Scale Embodied Memory (MEM) pour les tâches de plus de dix minutes, ainsi qu’une approche « RL Token » pour un apprentissage par renforcement en ligne plus rapide sur des tâches de précision [4]. En avril 2026, elle a publié π0.7, présenté comme un modèle généraliste « pilotable ». π0.7 compte environ 5 milliards de paramètres : une base vision-langage initialisée à partir du modèle Gemma 3 4B de Google (avec un encodeur visuel de 400 millions de paramètres), un encodeur d’historique vidéo de type MEM et un expert d’action à flow matching de 860 millions de paramètres. Il est conditionné non seulement par une commande en langage naturel, mais aussi par des métadonnées et des images de sous-objectifs visuels qui décrivent comment accomplir une tâche [5]. Physical Intelligence fait état des premiers signes de généralisation compositionnelle : guidé pas à pas par des consignes verbales, π0.7 a utilisé des appareils de cuisine pour lesquels il n’avait aucune démonstration, comme mettre une patate douce dans une friteuse à air, et a plié du linge sur un système bimanuel de bras industriels UR5e pour lequel aucune donnée de pliage n’avait été collectée [5]. L’entreprise affirme qu’un seul modèle π0.7 a égalé ou dépassé ses modèles spécialistes π*0.6 entraînés par RL pour le pliage de linge, la préparation d’espresso et l’assemblage de cartons [5]. Le 13 octobre 2026, elle a ouvert une bêta de la Pi API, qui permet aux développeurs d’envoyer leurs données, d’affiner ses derniers modèles sur une infrastructure de calcul qu’elle gère et d’exécuter l’inférence dans le cloud sur leurs propres robots ; les partenaires en accès anticipé vont des engins lourds autonomes à un fabricant de robots à deux bras [6] — signe que le modèle de fondation robotique devient un produit de plateforme, et plus seulement un article scientifique.
Gemini Robotics 2 de Google DeepMind : le contrôle du corps entier
Google DeepMind, à l’origine de l’appellation VLA, a depuis reconstruit sa pile robotique sur Gemini. Le 30 juillet 2026, il a présenté Gemini Robotics 2, une famille de trois modèles [7] :
- Gemini Robotics 2, son VLA le plus avancé, qui convertit les entrées visuelles et textuelles en commande motrice et peut piloter des humanoïdes complets « des pieds au bout des doigts » ainsi que des robots à deux bras [7].
- Gemini Robotics ER 2, un VLM de raisonnement incarné qui joue le rôle de planificateur : il comprend la scène, communique avec les personnes et planifie des tâches en plusieurs étapes durant plusieurs minutes et impliquant des centaines de décisions. Il coordonne aussi plusieurs robots travaillant en équipe [7].
- Gemini Robotics On-Device 2, un VLA économe conçu pour tourner localement sur le robot ; DeepMind affirme qu’il peut s’adapter à de nouveaux robots à deux bras en quelques heures, généralement avec moins de 200 exemples [7].
Cette séparation entre un modèle de raisonnement qui « réfléchit » et un VLA qui « agit » reproduit la structure haut niveau/bas niveau de π0.5, mais sous forme de produits distincts. DeepMind a montré un seul checkpoint pilotant trois robots : l’humanoïde Apollo 2 d’Apptronik équipé de mains SharpaWave, le même humanoïde avec des mains Inspire, et un Franka Duo muni de pinces Robotiq [7]. DeepMind indique que le modèle peut piloter la main SharpaWave à cinq doigts et 22 degrés de liberté pour des tâches comme nouer des nœuds ou fermer un sachet zippé [7]. L’entreprise s’est aussi montrée remarquablement franche : les tâches dextres du corps entier et avec pince atteignent des taux de réussite moyens à élevés, tandis que la manipulation dextre à plusieurs doigts « reste difficile » [7]. L’accès est limité : ER 2 est disponible dans Google AI Studio et en préversion privée sur Gemini Enterprise Agent Platform, tandis que les modèles VLA et On-Device sont réservés aux partenaires en accès anticipé [7][8].
NVIDIA GR00T N1.6 : un modèle de fondation ouvert pour humanoïdes
L’approche de NVIDIA consiste à fournir la « plateforme de référence » ouverte des fabricants d’humanoïdes. Son programme Isaac GR00T regroupe pipelines de données, simulation, bibliothèques d’exécution et l’ordinateur Jetson Thor autour d’un modèle de fondation robotique ouvert [9]. La version actuelle, GR00T N1.6, est un VLA ouvert de 3 milliards de paramètres publié sur Hugging Face [10].
GR00T N1.6 associe un modèle vision-langage NVIDIA Cosmos (une variante Cosmos-Reason-2B) à une tête transformer de diffusion/flow matching deux fois plus profonde que celle de son prédécesseur — 32 couches contre 16 — et prédit des blocs d’action relatifs à l’état plutôt que des angles articulaires absolus [11][12]. Son mélange de préentraînement a ajouté plusieurs milliers d’heures de données téléopérées issues de bras bimanuels, de l’AgiBot Genie-1, de robots simulés et de loco-manipulation du corps entier sur Unitree G1, et NVIDIA indique qu’il surpasse N1.5 en simulation comme sur robots réels [11]. La description que fait l’entreprise de sa recette de données est révélatrice : de la vidéo humaine à l’échelle d’internet pour la connaissance du monde, de la téléopération réelle pour l’ancrage physique et des données synthétiques pour passer à l’échelle sans risque [9].
L’ouverture compte ici. NVIDIA indique que les modèles GR00T sont disponibles dans la bibliothèque LeRobot de Hugging Face pour l’affinage et l’évaluation, et que l’humanoïde open source Reachy 2 de Hugging Face exécutera des VLA, dont GR00T N1.6, sur Jetson Thor [13]. Pour les start-up de l’humanoïde incapables d’entraîner un modèle de pointe à partir de zéro, c’est l’équivalent de partir d’un LLM à poids ouverts.
La place des modèles de monde
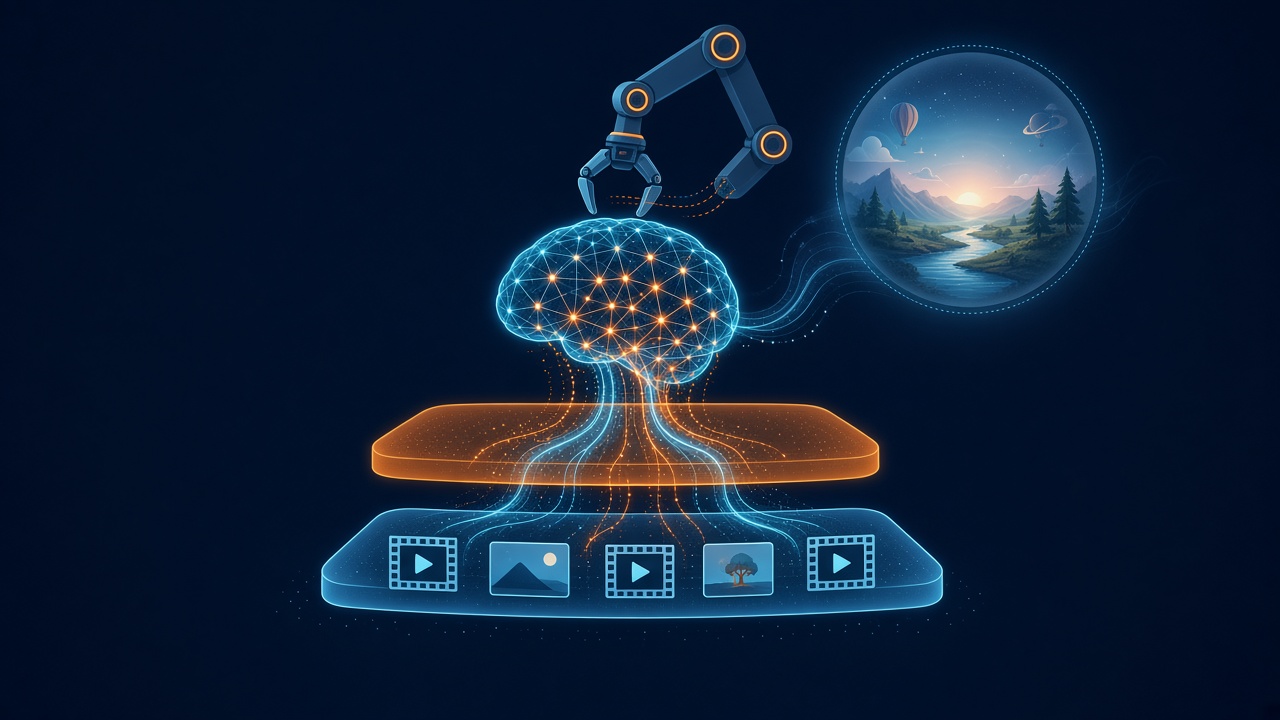
Les VLA associent directement observations et actions. Les modèles de monde empruntent une voie complémentaire : ils apprennent à prédire comment le monde va évoluer, et permettent au robot de planifier en imaginant les conséquences avant d’agir.
V-JEPA 2 de Meta, publié en 2025, en est un exemple clair. Il a été préentraîné de manière auto-supervisée sur plus d’un million d’heures de vidéo issue d’internet, puis post-entraîné en modèle conditionné par l’action (V-JEPA 2-AC, un transformer de 300 millions de paramètres) avec moins de 62 heures de vidéo robotique non annotée tirée du jeu de données DROID [14]. Déployé en zero-shot sur des bras Franka dans deux laboratoires absents de ses données d’entraînement, il a planifié des préhensions et des opérations de pick-and-place à partir d’images d’objectif — sans entraînement spécifique à la tâche ni récompenses [14]. Meta fait état de 65 à 80 % de réussite en pick-and-place de nouveaux objets dans des environnements inconnus, grâce à la commande prédictive : le robot imagine des actions candidates, les évalue par rapport à l’image d’objectif, exécute la meilleure et replanifie [15].
NVIDIA aborde les modèles de monde par la simulation. Ses modèles Cosmos Predict 2.5 et Cosmos Transfer 2.5 sont des modèles de monde ouverts destinés à la génération de données synthétiques fondées sur la physique et à l’évaluation de politiques robotiques en simulation, aux côtés du VLM Cosmos Reason 2 qui alimente aussi GR00T [13]. Dans le flux sim-to-real de NVIDIA pour GR00T N1.6, l’apprentissage par renforcement du corps entier dans Isaac Lab produit des primitives de mouvement qui se transfèrent en zero-shot à des humanoïdes physiques, le VLA se chargeant de les coordonner [12].
La tendance qui se dessine est la convergence plutôt que la concurrence. Les modèles de monde fournissent une expérience bon marché et évolutive ainsi qu’un moyen d’« anticiper » ; les VLA apportent une commande rapide et réactive ancrée dans le langage. Attendez-vous à ce que la frontière entre les deux s’estompe encore, à mesure que les VLA gagnent en mémoire et en planification (comme dans les travaux MEM de π [4]) et que les modèles de monde se dotent de têtes d’action.
Pourquoi les VLA deviennent la couche de base
Pris dans leur ensemble, les développements de 2026 montrent pourquoi la métaphore de la « couche de base » est la bonne :
- Un modèle, plusieurs corps. L’entraînement multi-incarnation est désormais la norme. Gemini Robotics 2 fait tourner un seul checkpoint sur des humanoïdes et des bras [7] ; GR00T N1.6 couvre l’Unitree G1, l’AgiBot Genie-1, le Fourier GR-1 et des configurations bimanuelles [9] ; π0.5 a surtout progressé grâce aux données collectées sur d’autres robots [3].
- L’adaptation plutôt que la programmation. OpenVLA a démontré l’affinage LoRA sur un seul GPU [2] ; Gemini Robotics On-Device 2 revendique l’adaptation à de nouveaux robots à deux bras en quelques heures, généralement avec moins de 200 exemples [7] ; la Pi API fait de l’affinage un service hébergé [6].
- Le langage comme interface. Tous les grands modèles acceptent des instructions en langage naturel, des objectifs de haut niveau (« range la chambre ») jusqu’à des mouvements précis [3].
- La hiérarchie. Une couche de raisonnement qui planifie et une couche motrice qui agit — explicite avec Gemini Robotics ER 2 associé au VLA [7], implicite dans les sous-tâches que π0.5 se donne lui-même [3] et dans l’usage de Cosmos Reason par GR00T pour décomposer les tâches [12].
Ce qui freine encore la robotique VLA
Les réserves les plus honnêtes viennent des concepteurs eux-mêmes :
- La fiabilité. OpenVLA restait généralement sous les 90 % de réussite [2] ; Physical Intelligence reconnaît que π0.5 « fait souvent des erreurs », au niveau sémantique comme moteur [3] ; DeepMind juge la dextérité à plusieurs doigts encore difficile [7]. Pour un domicile, un hôpital ou une usine, un taux d’échec de 10 % n’a rien d’anecdotique.
- Les données. Même les grands jeux de données de manipulation contiennent environ 100 000 à un million d’exemples, soit des ordres de grandeur de moins que le texte et les images à l’échelle du web [2]. C’est pourquoi les données synthétiques, les modèles de monde et la mutualisation entre robots sont si centraux.
- La vitesse et le calcul. La commande à haute fréquence (les auteurs d’OpenVLA citent des systèmes bimanuels à 50 Hz) exige une inférence plus rapide que celle des premiers VLA [2], ce qui pousse le domaine vers le découpage en blocs d’action, le flow matching et les modèles embarqués.
- L’accès. Les modèles propriétaires les plus performants, comme Gemini Robotics 2, restent en préversion privée [8], tandis que les modèles ouverts sont en retrait sur certaines capacités.
En résumé
En un peu plus de trois ans, le modèle vision-langage-action est passé d’un recadrage astucieux — « traiter les actions comme des mots » — au principe organisateur de l’apprentissage robotique moderne. RT-2 a prouvé que la connaissance du web pouvait atteindre la pince ; OpenVLA a rendu l’approche ouverte et abordable ; π0.5 et π0.7 ont montré que des données variées et des consignes pilotables ouvrent la généralisation à de nouveaux logements et à de nouvelles tâches ; Gemini Robotics 2 et GR00T N1.6 l’ont étendue au corps entier des humanoïdes. Des modèles de monde comme V-JEPA 2 et Cosmos y ajoutent, en dessous, l’imagination et l’expérience synthétique.
Aucun de ces systèmes n’est encore un assistant domestique fiable. Mais l’architecture du modèle de fondation robotique est désormais claire, les outils sont de plus en plus ouverts, et les problèmes restants — fiabilité, données et vitesse — sont de ceux que l’échelle, l’ingénierie et le temps finissent généralement par résorber. Pour qui suit l’autonomie, la robotique VLA n’est plus une niche à surveiller : c’est la couche sur laquelle tout le reste sera construit.
À lire aussi
- Sim-to-real en 2026 : combler l’écart sans données réelles à l’infini
- Edge incarné : l’IA hors ligne pour les robots et les véhicules
- Les humanoïdes à l’usine : des vidéos de démo aux équipes complètes
< !– Schema.org NewsArticle (CF_SEO) — image paths relative to draft ; replace with absolute CDN URLs at publish –>
Références / sources
- Google DeepMind — « RT-2: New model translates vision and language into action » (28 July 2023). https://deepmind.google/discover/blog/rt-2-new-model-translates-vision-and-language-into-action/
- Kim, Pertsch, Karamcheti et al. — « OpenVLA: An Open-Source Vision-Language-Action Model », arXiv:2406.09246. https://arxiv.org/abs/2406.09246
- Physical Intelligence — « π0.5: a VLA with Open-World Generalization » (22 April 2025). https://www.physicalintelligence.company/blog/pi05
- Physical Intelligence — homepage research updates (MEM, RL Token, 2026). https://www.pi.website/
- Physical Intelligence — « π0.7: a Steerable Model with Emergent Capabilities », blog (16 April 2026), and technical paper arXiv:2604.15483. https://arxiv.org/html/2604.15483 · https://www.pi.website/blog/pi07
- Physical Intelligence — « Frontier Models for Every Robot: Announcing our API beta » (13 October 2026). https://www.pi.website/blog/api-beta
- Google DeepMind — « Gemini Robotics 2 brings whole body intelligence to robots » (30 July 2026). https://deepmind.google/blog/gemini-robotics-2-brings-whole-body-intelligence-to-robots/
- Google DeepMind — Gemini Robotics 2 model page. https://deepmind.google/models/gemini-robotics/vla/
- NVIDIA Developer — Isaac GR00T. https://developer.nvidia.com/isaac/GR00t
- Hugging Face — nvidia/GR00T-N1.6-3B model card. https://huggingface.co/nvidia/GR00T-N1.6-3B
- NVIDIA GEAR Lab — « GR00T N1.6: An Improved Open Foundation Model for Generalist Humanoid Robots » (15 December 2025). https://research.nvidia.com/labs/gear/gr00t-n1_6/index.html
- NVIDIA Technical Blog — « Building Generalist Humanoid Capabilities with NVIDIA Isaac GR00T N1.6 Using a Sim-to-Real Workflow » (8 January 2026). https://developer.nvidia.com/blog/building-generalist-humanoid-capabilities-with-nvidia-isaac-gr00t-n1-6-using-a-sim-to-real-workflow/
- NVIDIA — « NVIDIA Releases New Physical AI Models as Global Partners Unveil Next-Generation Robots » (press release). https://investor.nvidia.com/news/press-release-details/2026/NVIDIA-Releases-New-Physical-AI-Models-as-Global-Partners-Unveil-Next-Generation-Robots/
- Meta FAIR — « V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning », arXiv:2506.09985. https://arxiv.org/html/2506.09985
- Meta AI — « Introducing the V-JEPA 2 world model and new benchmarks for physical reasoning ». https://ai.fb.com/blog/v-jepa-2-world-model-benchmarks/
Crédits images : les deux illustrations (vla-hero.jpg, vla-stack.jpg) ont été générées par IA pour AndBeyond.Tech, conformément au BP §5.2. Texte original ; chiffres paraphrasés et attribués conformément au §5.1.
Images : illustrations originales créées pour AndBeyond.Tech ; aucun logo ni aucune personne réelle n’y figurent.