Sim-to-real en 2026 : combler l’écart sans données réelles à l’infini
Sim-to-real en robotique en 2026 : randomisation de domaine, MuJoCo, Isaac Lab, jumeaux numériques et données synthétiques de modèles de monde.
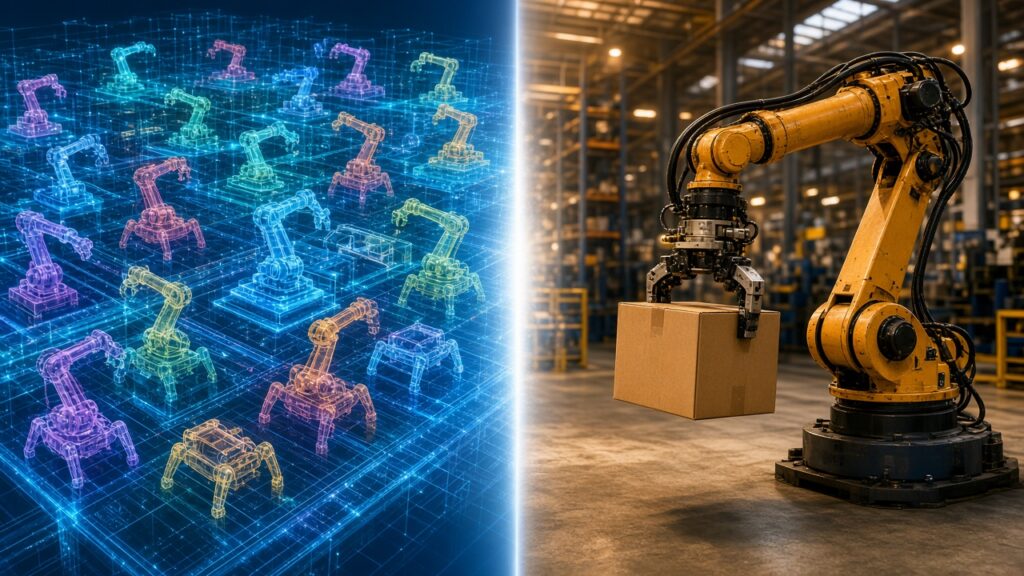
Toute équipe d’apprentissage robotique finit par se heurter au même mur : les données. Les modèles de langage peuvent s’entraîner sur une large part de l’internet public, mais personne ne dispose d’une archive de la taille d’internet montrant des robots qui saisissent, marchent, tombent et se relèvent. Collecter cette expérience sur du matériel physique est lent, coûteux et parfois dangereux. La simulation offre une issue évidente : s’entraîner dans un monde virtuel où les données ne coûtent presque rien, puis déployer sur la vraie machine. Le hic porte un nom, l’écart de réalité (reality gap), et le combler est tout l’enjeu du sim-to-real en robotique.
Ce guide explique d’où vient cet écart, quelles techniques l’ont réduit (randomisation de domaine, simulation rapide sur GPU, jumeaux numériques) et comment les données synthétiques pour robots, de plus en plus produites par des modèles de monde génératifs, s’intègrent à l’apprentissage robotique et à l’autonomie modernes.
Qu’est-ce que l’écart de réalité ?
Dans leur article de 2017 sur la randomisation de domaine, des chercheurs d’OpenAI et de l’UC Berkeley décrivaient clairement le problème. Les simulateurs physiques diffèrent de la réalité d’une manière difficile à éliminer. L’identification de système, c’est-à-dire l’ajustement des paramètres d’un simulateur pour qu’il corresponde à un robot physique, est « chronophage et source d’erreurs ». Même un simulateur bien réglé passe à côté d’effets comme les matériaux non rigides, le jeu des engrenages, l’usure ou la dynamique des fluides. Les images de caméra rendues n’ont pas non plus la richesse ni le bruit des capteurs réels [1]. Ensemble, ces différences constituent l’écart de réalité et expliquent pourquoi une politique qui semble parfaite en simulation peut échouer sur un vrai robot.
Le même article explique pourquoi la simulation en vaut malgré tout la peine. L’apprentissage par renforcement profond (RL) repose sur une exploration aléatoire, qui peut être dangereuse sur du matériel. Il exige aussi souvent des centaines de milliers, voire des millions d’échantillons, dont la collecte sur un robot physique pourrait prendre des milliers d’heures [1].
Technique 1 : la randomisation de domaine, ou faire du réel « une variante de plus »
La première réponse largement adoptée était contre-intuitive. Plutôt que de rendre le simulateur parfaitement réaliste, le rendre extrêmement varié. Si un modèle voit suffisamment de variations aléatoires pendant l’entraînement, avançaient les auteurs, « le monde réel peut apparaître au modèle comme une simple variante de plus » [1].
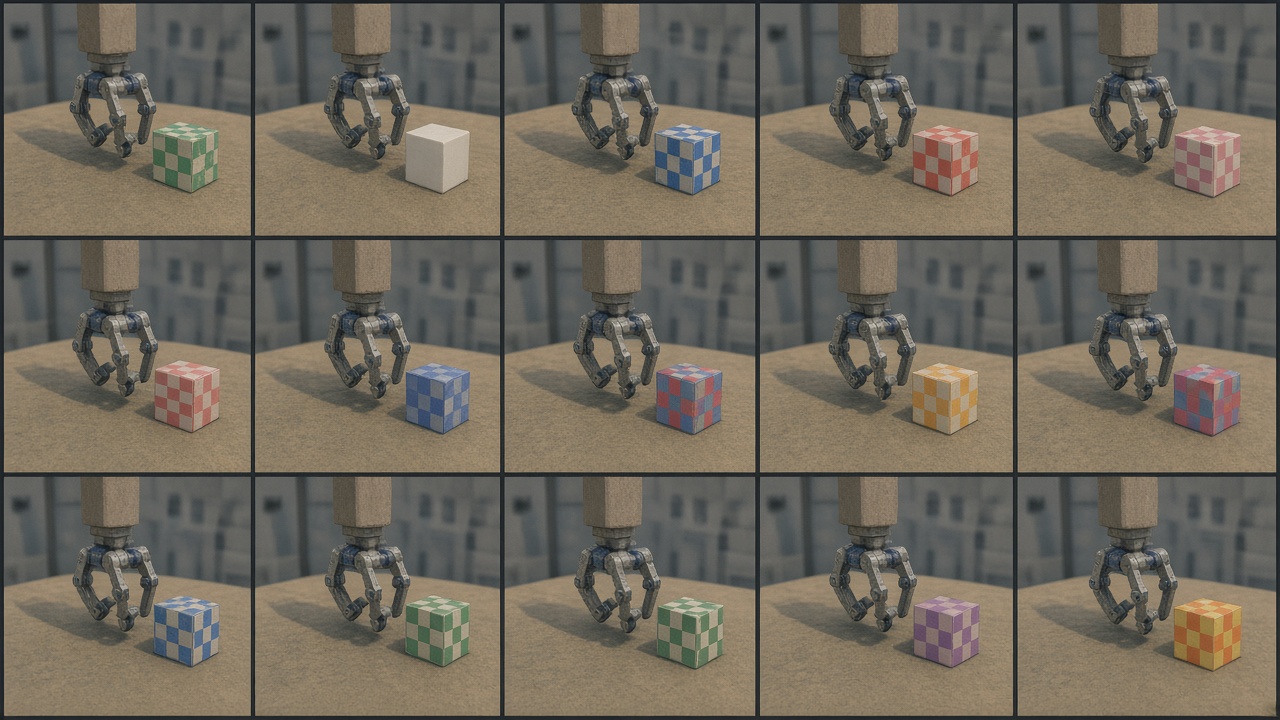
Leur expérience a entraîné un détecteur d’objets uniquement sur des images simulées rendues avec des textures aléatoires délibérément irréalistes : aplats de couleur, dégradés et damiers, présentés sous un éclairage, des poses de caméra et des objets distracteurs randomisés, et rendus avec le moteur de rendu de base intégré à MuJoCo [1]. Le détecteur localisait les objets dans le monde réel à environ 1,5 cm près en moyenne, et un robot Fetch qui l’utilisait a saisi l’objet cible dans 38 essais sur 40 dans des scènes encombrées [1]. Les auteurs y voyaient le premier transfert réussi vers la commande d’un robot réel d’un réseau profond entraîné uniquement sur des images RVB simulées, sans préentraînement sur des images réelles [1].
Les études d’ablation restent utiles aujourd’hui. Les performances chutaient nettement en dessous d’environ 1 000 textures uniques. Retirer les objets distracteurs de l’entraînement faisait passer l’erreur moyenne dans les scènes encombrées d’environ 1,8 cm à 7,2 cm [1]. La variété était en elle-même le signal d’apprentissage.
La randomisation de domaine automatique
Choisir à la main les plages de randomisation est difficile : trop de randomisation complique l’apprentissage, trop peu freine le transfert [2]. OpenAI s’est attaqué au problème en 2019, dans son projet de Rubik’s Cube, avec l’Automatic Domain Randomization (ADR). L’entraînement démarre dans un environnement unique, non randomisé. Chaque fois que la politique atteint un seuil de performance, les plages de randomisation s’élargissent automatiquement, pour des paramètres comme la taille et la masse du cube, le frottement des doigts et l’apparence visuelle de la main [2].
Les réseaux de neurones ont été entraînés entièrement en simulation, puis ont piloté une vraie main robotique de type humain pour résoudre le cube [2]. OpenAI a été transparent sur les limites : le système réussissait 60 % du temps sur des mélanges nécessitant 15 rotations, et 20 % sur les mélanges les plus difficiles, nécessitant 26 rotations [2]. Sur une tâche plus simple de retournement de bloc, l’ADR a fini par doubler les performances de transfert vers le robot réel par rapport à une randomisation réglée manuellement, sans aucun réglage humain [2]. La politique a aussi fait face à des perturbations jamais vues à l’entraînement [2].
Technique 2 : la vitesse, avec la simulation sur GPU et l’itération rapide
La randomisation de domaine multiplie la quantité d’expérience dont une politique a besoin. La vitesse du simulateur devient donc une préoccupation d’ingénierie centrale, et non un simple confort.
MuJoCo Playground, publié en 2025 par des chercheurs de l’UC Berkeley, de Google DeepMind et d’autres institutions, montre le chemin parcouru. Il s’agit d’un framework entièrement open source construit sur MJX, une version du moteur physique MuJoCo basée sur JAX qui tourne sur GPU. Les chercheurs peuvent l’installer avec un simple pip install playground et entraîner de nombreuses politiques en quelques minutes sur un seul GPU [3]. Les auteurs décrivent la recette sim-to-real standard en quatre étapes : construire un environnement simulé qui correspond au monde réel (le « jumeau numérique »), encoder le comportement souhaité sous forme de récompense, entraîner en simulation, puis déployer [3]. Ils soutiennent que la vitesse compte parce que la conception des récompenses est itérative. Le RL excelle à maximiser une récompense, mais produit souvent des comportements étranges : le délai entre la demande d’un comportement et son observation sur le robot devient donc le goulet d’étranglement [3].
Quelques-uns des résultats rapportés :
- Locomotion : des politiques de marche pilotées au joystick pour le Berkeley Humanoid, entraînées sur sol plat en moins de 15 minutes. Les politiques pour les humanoïdes Unitree G1 et Booster T1 ont demandé moins de 30 minutes sur deux GPU RTX 4090 et se sont transférées en zero-shot vers une marche et des virages stables [3].
- Manipulation à partir des pixels : avec des propriétés visuelles randomisées (éclairage, ombres, pose de caméra, couleurs des objets), un bras Franka a appris à saisir un petit bloc à partir d’images RVB de 64×64 après dix minutes d’entraînement sur une seule RTX 4090. Il a ensuite réussi les 12 essais en conditions réelles [3].
- Commande riche en contacts : une politique commandée en couple pour pousser et réorienter une brique de yoga, entraînée avec des délais randomisés et un curriculum, a atteint un taux de réussite moyen d’environ 86 % sur 35 essais sur matériel réel [3].
- Rythme d’itération : l’équipe a déployé des politiques fondées sur l’état et sur la vision sur six plateformes robotiques en moins de huit semaines [3].
L’article donne aussi une vision honnête de l’écart restant. Sa politique de réorientation de cube avec la main LEAP n’a réussi qu’une médiane de 3,5 rotations consécutives lors des essais réels, avec des échecs comme le cube coincé entre les doigts et la paume [3]. La manipulation dextre riche en contacts reste le point le plus faible du sim-to-real.
La pile concurrente de NVIDIA repose sur son moteur GPU PhysX, via Isaac Lab et Isaac Sim. Les auteurs de MuJoCo Playground reconnaissent que cet écosystème a produit un large éventail de résultats sim-to-real en robotique, tout en notant que l’implémentation GPU de PhysX est propriétaire (closed source) [3].
Technique 3 : un sim-to-real en couches pour les humanoïdes
En 2026, le sim-to-real relève moins d’une astuce unique que d’une architecture. La présentation technique publiée en janvier 2026 par NVIDIA sur son modèle humanoïde Isaac GR00T N1.6 illustre ce schéma [4] :
- Bas niveau : un contrôleur du corps entier entraîné par RL dans Isaac Lab produit des primitives de mouvement dynamiquement stables pour la locomotion, la manipulation et les comportements multicontacts. Ces politiques sont soumises à des tests de résistance à grande échelle dans Isaac Lab et Isaac Sim, puis transférées en zero-shot vers des humanoïdes physiques [4].
- Niveau intermédiaire : une politique de navigation entraînée sur de vastes jeux de données synthétiques générés avec le workflow COMPASS de NVIDIA envoie des consignes de vitesse à ce contrôleur. NVIDIA fait état d’un transfert sim-to-real en zero-shot, y compris dans de nouveaux environnements physiques, sans collecte supplémentaire de données propres à la tâche [4].
- Haut niveau : le modèle vision-langage-action GR00T N1.6 raisonne sur la tâche et enchaîne les compétences. Son mélange d’entraînement combine des environnements simulés (BEHAVIOR, RoboCasa et un environnement GR-1 sur mesure) et des démonstrations réelles issues de plusieurs plateformes robotiques [4].
Ce choix de conception est important. La physique la plus difficile, l’équilibre et le contact, est prise en charge par une politique largement entraînée en simulation, où les chutes ne coûtent rien. Le grand modèle peut alors se concentrer sur ce qu’il faut faire plutôt que sur la manière de rester debout [4]. Avant le déploiement, la pile complète est validée en simulation [4].
Technique 4 : des données synthétiques de longue traîne issues de modèles de monde
Les simulateurs classiques sont des moteurs physiques auxquels on a greffé un moteur de rendu. En 2026, un second type de simulateur arrive à maturité : les modèles de monde génératifs, qui produisent des vidéos et des données de capteurs physiquement plausibles.
Au CES de janvier 2026, NVIDIA a publié Cosmos Transfer 2.5 et Cosmos Predict 2.5, qu’elle présente comme des modèles de monde ouverts et entièrement personnalisables pour la génération de données synthétiques fondées sur la physique et l’évaluation de politiques robotiques en simulation. Elle a aussi publié Cosmos Reason 2, un modèle vision-langage de raisonnement ouvert, l’ensemble étant disponible sur Hugging Face [5]. L’intérêt réside dans la longue traîne : conditions d’éclairage rares, objets inhabituels et scènes limites coûteuses ou dangereuses à mettre en scène physiquement, mais qu’un robot déployé finira par rencontrer.
La même annonce montre comment l’outillage autour de la simulation devient une infrastructure industrielle [5] :
- Évaluation : Isaac Lab-Arena, un framework open source d’évaluation et de benchmarking à grande échelle des politiques robotiques en simulation, se connecte à des benchmarks comme Libero et RoboCasa.
- Orchestration : NVIDIA OSMO coordonne la génération de données synthétiques, l’entraînement et les tests software-in-the-loop entre postes de travail et cloud.
- Santé : LEM Surgical utilise Isaac for Healthcare et Cosmos Transfer pour entraîner les bras autonomes de son robot chirurgical Dynamis.
- Partenaires : AGIBOT a présenté Genie Sim 3.0, une plateforme de simulation intégrée à Isaac Sim, et Franka Robotics, NEURA Robotics et Humanoid utilisent des workflows compatibles GR00T pour simuler, entraîner et valider de nouveaux comportements.
Pourquoi l’edge compte : de la simulation à l’autonomie embarquée
Le sim-to-real ne s’arrête pas à la fin de l’entraînement. Une politique entraînée dans le cloud doit encore tourner en temps réel sur le robot, souvent avec une puissance limitée. Les politiques de locomotion de MuJoCo Playground, par exemple, tournent à 50 Hz via ONNX Runtime au sein d’une pile de commande temps réel en C++ [3]. La politique en couple du Franka envoie une commande toutes les 5 ms [3].
Les fabricants de matériel s’y préparent. Le module Jetson T4000 de NVIDIA, annoncé en janvier 2026, apporte l’architecture Blackwell aux machines autonomes. NVIDIA annonce 1 200 TFLOPS en FP4 et 64 Go de mémoire dans une enveloppe configurable de 70 watts, au prix de 1 999 $ l’unité par lot de 1 000 [5]. Pour la robotique industrielle, à retenir : la chaîne « entraîner en simulation, déployer en edge » dispose désormais de briques dédiées à ses deux extrémités.
Ce qui ne se transfère toujours pas
La simulation n’a pas rendu les données réelles superflues. Les sources ci-dessus pointent des points faibles récurrents :
- La dextérité riche en contacts. OpenAI a constaté que la randomisation de domaine seule « ne suffisait pas » pour la physique d’un Rubik’s Cube dans une main robotique [2], et la réorientation en main reste fragile dans des frameworks ouverts plus récents [3].
- La physique non modélisée. Le jeu mécanique, l’usure, les matériaux déformables et les fluides restent difficiles à simuler fidèlement [1].
- Les décalages de capteurs et de latence. Les transferts réussis dépendent souvent d’une modélisation délibérée des délais et du bruit. MuJoCo Playground randomise les délais d’action et d’observation ainsi que le retard de la pince, et ses auteurs indiquent qu’un étalonnage approximatif de l’échelle d’action sur le dispositif réel a amélioré le transfert « de façon spectaculaire » [3].
- La conception des récompenses. L’entraînement est désormais rapide, mais définir ce que le robot doit faire reste un processus humain et itératif [3].
En résumé
La question a changé. Elle était autrefois « un robot entraîné en simulation peut-il fonctionner dans le monde réel ? » et, en 2026, la réponse est clairement oui pour la locomotion et pour un éventail croissant de tâches de manipulation. La question est désormais de savoir comment répartir le travail entre simulation, données synthétiques et expérience réelle. La réponse opérationnelle comporte plusieurs volets :
- Entraîner les compétences de bas niveau, très dépendantes de la physique, dans une simulation GPU fortement randomisée.
- Couvrir la longue traîne avec des données synthétiques issues de modèles de monde.
- Valider les piles complètes dans des jumeaux numériques avant qu’elles n’atteignent le matériel.
- Conserver un flux plus réduit, mais toujours indispensable, de données réelles pour le contact, la perception et les cas limites que les simulateurs ratent encore.
Pour quiconque développe l’apprentissage robotique et l’autonomie, le sim-to-real est devenu une infrastructure essentielle.
À lire aussi
- Modèles vision-langage-action : la nouvelle couche de base des robots
- Usines de données pour l’IA physique : comment les données synthétiques accélèrent les robots industriels
- Cobots IA et vision : là où les usines voient le ROI en premier
< !– Schema.org NewsArticle (CF_SEO) — image paths relative to draft ; replace with absolute CDN URLs at publish –>
Références / sources
- Tobin, Fong, Ray, Schneider, Zaremba, Abbeel, « Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World », arXiv:1703.06907 (2017). https://arxiv.org/abs/1703.06907
- OpenAI, « Solving Rubik’s Cube with a robot hand » (15 October 2019). https://openai.com/index/solving-rubiks-cube/
- Zakka, Tabanpour, Liao et al., « MuJoCo Playground », arXiv:2502.08844 (2025). https://arxiv.org/abs/2502.08844
- NVIDIA Technical Blog, « Building Generalist Humanoid Capabilities with NVIDIA Isaac GR00T N1.6 Using a Sim-to-Real Workflow » (8 January 2026). https://developer.nvidia.com/blog/building-generalist-humanoid-capabilities-with-nvidia-isaac-gr00t-n1-6-using-a-sim-to-real-workflow/
- NVIDIA, « NVIDIA Releases New Physical AI Models as Global Partners Unveil Next-Generation Robots », press release (5 January 2026). https://investor.nvidia.com/news/press-release-details/2026/NVIDIA-Releases-New-Physical-AI-Models-as-Global-Partners-Unveil-Next-Generation-Robots/
Crédits images : les deux illustrations (sim2real-hero.jpg, sim2real-domain-randomization.jpg) sont des images générées par IA, conformément au BP §5.2. Texte original ; chiffres paraphrasés et attribués conformément au §5.1.
Images : illustrations originales créées pour AndBeyond.Tech ; aucun logo ni aucune personne réelle n’y figurent.