Après l’imitation : l’apprentissage par renforcement résiduel et en conditions réelles, nouvelle couche des politiques robotiques
RL résiduel et RL en conditions réelles au-dessus des politiques VLA issues de l’imitation : le résiduel simulé de Microsoft et l’expérience sélective d’Evo-RL.
L’apprentissage par imitation a permis aux modèles de fondation robotiques de sortir du laboratoire et de fonctionner sur des matériels variés. Les modèles vision-langage-action (VLA) savent désormais traduire des images de caméra et des instructions en langage naturel en commandes motrices, pour de nombreuses tâches. Mais quiconque a observé l’exécution d’une tâche longue connaît leur point faible : les petites erreurs d’exécution s’accumulent. Une prise décalée d’un centimètre se mue, trois secondes plus tard, en insertion manquée. Les données de démonstration couvrent rarement ces états de rattrapage, si bien qu’une politique entraînée uniquement par imitation ne sait guère quoi faire ensuite.
En 2026, un nombre croissant de travaux traitent cet écart comme un problème d’apprentissage distinct. Au lieu de remplacer le VLA, les chercheurs ajoutent une couche supplémentaire : un apprentissage par renforcement (RL) résiduel qui corrige la politique de base, laissée figée, et des boucles de RL en conditions réelles qui réutilisent de manière sélective l’expérience acquise en déploiement. Cet article explique ces approches en rattachant chaque chiffre aux robots et aux tâches qui l’ont produit, et les situe par rapport à la boîte à outils du sim-to-real, qui rend praticables les résiduels entraînés en simulation.
Pourquoi l’imitation seule atteint un plafond
Un VLA est généralement entraîné par clonage comportemental ou par appariement de flux (flow matching) à partir de démonstrations téléopérées. Il apprend ainsi le comportement réussi moyen présent dans le jeu de données, sans être explicitement optimisé pour se rattraper lorsque le robot s’écarte de la variété des démonstrations. La lignée de travaux RECAP de Physical Intelligence, ainsi que d’autres systèmes de RL en conditions réelles, partent de ce constat : une fois la politique déployée, les interventions humaines et les exécutions autonomes deviennent une nouvelle source de données pour améliorer la robustesse et le débit [4][5].
Deux stratégies complémentaires se sont dégagées :
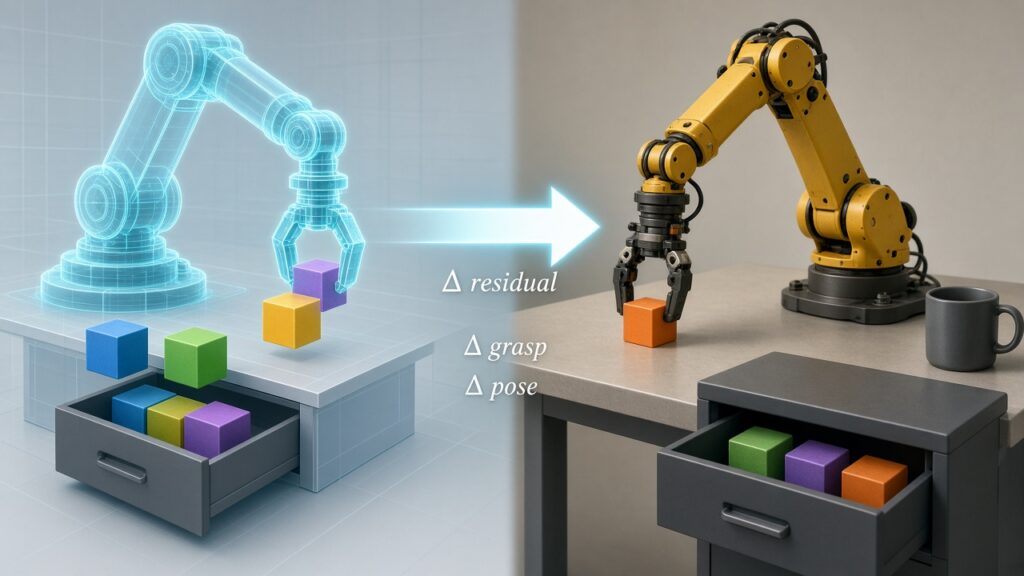
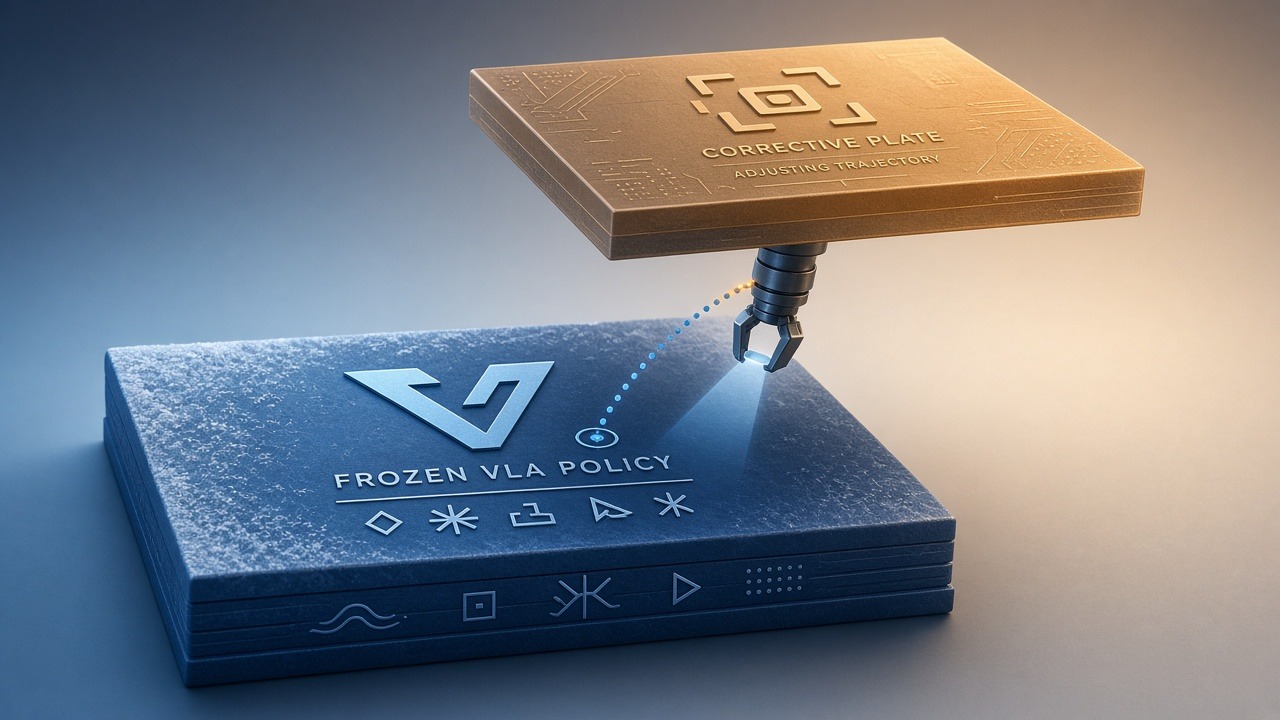
- Le RL résiduel. Le VLA reste figé. On entraîne une politique corrective plus petite qui ajoute un écart à l’action du VLA. Ce résiduel peut être entraîné en simulation si ses observations se transposent proprement au monde réel.
- Le RL itératif en conditions réelles. On déploie la politique, on collecte les interventions et les épisodes autonomes, puis on met à jour la politique elle-même à l’aide d’estimations de valeur qui favorisent un comportement efficace, nécessitant peu d’interventions.
Les deux approches interviennent après l’imitation. Elles supposent l’existence préalable d’un modèle de base performant.
Un RL résiduel entraîné en simulation et transférable sans adaptation
Les travaux de Microsoft Research Object-Centric Residual RL for Zero-Shot Sim-to-Real VLA Enhancement, acceptés à la Conference on Robot Learning (CoRL) 2026 d’Austin, posent une question précise : une politique d’apprentissage par renforcement entraînée uniquement en simulation peut-elle améliorer un VLA en conditions réelles, sans aucun RL sur le robot [1][2] ?
Les auteurs identifient un dilemme bien connu du sim-to-real appliqué aux résiduels. Les résiduels fondés sur un état privilégié doivent être distillés avant de pouvoir fonctionner sur le robot. Les résiduels fondés sur l’image héritent de l’écart visuel entre simulation et réalité. Le RL en conditions réelles est coûteux et risqué. Leur réponse est un résiduel centré sur les objets : la politique corrective observe les poses à six degrés de liberté des objets utiles à la tâche, l’état proprioceptif du robot et l’action courante du VLA de base, et non les images brutes de la caméra [1][2].
La chaîne de traitement comporte trois étapes [1] :
- Des VLA appariés en simulation et en réel. On part d’un VLA entraîné sur des données de téléopération réelles. On rejoue les mêmes actions de téléopération en simulation pour entraîner un pendant simulé, de sorte que les deux VLA restent alignés dans l’espace des actions même lorsque leurs pixels diffèrent.
- L’entraînement du résiduel en simulation. Le résiduel est entraîné avec injection de bruit sur les poses et suppression aléatoire de poses, afin qu’il tolère des estimations de pose imparfaites en conditions réelles.
- Le déploiement sans adaptation (zero-shot). Au moment du test, on substitue le VLA réel et l’on ajoute le même résiduel à chaque action, sans aucun réglage fin du résiduel sur le robot.
Résultats sur un Franka Research 3
Tous les chiffres obtenus sur robot réel présentés ci-dessous proviennent de cinq tâches de manipulation sur table réalisées sur un Franka Research 3 (FR3), à raison de 20 essais par tâche [1][2]. Le VLA de base utilisé dans l’article repose sur une architecture de type GR00T-N1.5 [2]. Les tâches sont : Cube Lift (soulever un cube), Pick-and-Place (prendre et déposer), Stack Cube (empiler un cube), Close Drawer (fermer un tiroir) et Stand Cup Up (redresser un gobelet).
| Tâche | Base réelle (réussites sur 20) | Réel avec résiduel |
|---|---|---|
| Cube Lift | 7 / 20 | 17 / 20 |
| Pick-and-Place | 9 / 20 | 16 / 20 |
| Stack Cube | 7 / 20 | 15 / 20 |
| Close Drawer | 14 / 20 | 20 / 20 |
| Stand Cup Up | 5 / 20 | 8 / 20 |
| Moyenne | 8,4 / 20 (42 %) | 15,2 / 20 (76 %) |
Le résiduel améliore chacune des tâches sans adaptation. Le taux de réussite moyen sur robot réel passe de 42 % à 76 %, sans apprentissage par renforcement en conditions réelles ni réglage fin de la politique résiduelle [1][2]. Sur les épisodes réussis, les auteurs font également état de durées d’exécution plus courtes, avec des réductions comprises entre 9 % et 22 % environ selon la tâche [1].
Il existe un second bénéfice. Les exécutions corrigées par le résiduel peuvent être agrégées et servir à réentraîner le VLA de base, ce qui transforme un module de correction propre à une tâche en boucle d’auto-amélioration ne nécessitant aucune téléopération supplémentaire [1][2]. Le RL résiduel joue ainsi un double rôle : correctif au moment de l’inférence et générateur de données.
Le RL en conditions réelles avec expérience sélective : Evo-RL
Les résiduels entraînés en simulation constituent une première voie. L’autre consiste à améliorer la politique à partir de l’expérience recueillie sur le robot réel. Evo-RL (Ye, Jin, Luo et al., arXiv:2610.13345, octobre 2026) est une méthode itérative qui associe des interventions humaines à une sélection de l’expérience guidée par l’avantage [3]. Cet article est une prépublication arXiv qui n’avait pas été évaluée par les pairs au moment de la rédaction.
Evo-RL part d’une politique entraînée sur des démonstrations et fondée sur l’architecture π0.5 (une base vision-langage PaliGemma associée à un expert d’action par appariement de flux) [3]. Pendant le déploiement, un opérateur intervient lorsque la politique se bloque. La méthode procède ensuite ainsi :
- Elle ne conserve que les portions pilotées par l’humain des trajectoires d’intervention réussies, pour un réglage fin correctif.
- Elle entraîne un modèle de valeur fondé sur la seule vision, avec des récompenses qui pénalisent à la fois la durée et les reprises en main humaines.
- Elle estime les avantages et sélectionne les segments à fort avantage dans les démonstrations et dans les exécutions autonomes réussies, au lieu de traiter toutes les images sur un pied d’égalité.
- Elle redéploie la politique mise à jour pour le cycle suivant [3].
Les auteurs opposent cette approche à RECAP, qui conditionne l’entraînement de la politique à une étiquette d’avantage binaire sur l’expérience accumulée [3][5]. Evo-RL utilise au contraire les avantages estimés pour filtrer et repondérer l’expérience.
À quoi se rattachent les chiffres
Evo-RL est évalué sur deux plateformes réelles, avec une limite de cinq minutes par essai [3] :
AgileX PiperX : insertion de vis de haute précision. Cinq paires vis-manchon sont posées sur une table. Chacun des deux bras peut insérer une vis dans un manchon tenu par l’autre. L’évaluation rend compte du taux de réussite des tentatives (ASR) et du débit sur cinq unités d’insertion successives, avec un objectif de N = 10 réussites par unité [3].
Selon ce protocole (tableau II de la prépublication) [3] :
- Réglage fin supervisé (SFT) sur les seules démonstrations : 22,73 % d’ASR.
- SFT complété d’une heure d’interventions humaines : 78,72 % d’ASR.
- RECAP : 57,78 % d’ASR.
- Premier cycle d’Evo-RL : 88,24 % d’ASR et 60,61 étapes réussies par heure.
- Deuxième cycle d’Evo-RL : 92,16 % d’ASR et 67,14 étapes par heure.
Le chiffre phare du résumé, selon lequel le premier cycle d’Evo-RL améliore l’ASR de 30,46 points de pourcentage par rapport à RECAP, correspond exactement à 88,24 − 57,78 dans ce protocole d’insertion sur PiperX [3]. Il ne s’agit pas d’une affirmation valable pour tous les robots ou toutes les tâches.
SO-101 : pliage de tee-shirts. Cinq tee-shirts sont posés en vrac ; les unités couvrent la saisie, l’étalement, le pliage en deux, le repli des manches et le pliage de l’ourlet vers le col, avec N = 20 par étape [3]. La version complète d’Evo-RL fait passer l’ASR de 55,56 % (SFT) à 76,67 %, et le débit de 75,78 à 90,00 étapes réussies par heure [3].
Un jeu de données accompagne ces travaux, RW-RL-Dataset : plus de 1 000 heures d’interactions réelles sur quatre plateformes (AgiBot G2, Galaxea R1Lite, AgileX PiperX et SO-101), avec des étiquettes au niveau de chaque image indiquant si l’humain ou la politique avait le contrôle [3]. Le code et les points de contrôle sont publiés avec la prépublication [3].
Comment les deux couches s’articulent
Le RL résiduel en simulation et le RL itératif en conditions réelles ne sont pas rivaux. Ils s’attaquent à des goulets d’étranglement différents :
| Couche | Lieu d’apprentissage | Ce qui reste figé | Point fort |
|---|---|---|---|
| Résiduel centré sur les objets [1][2] | Simulation uniquement | Poids du VLA de base | Corrections précises lorsque les poses des objets sont disponibles ; transfert sans adaptation |
| Evo-RL [3] | Robot réel et réutilisation sélective | Rien de manière permanente : la politique est mise à jour à chaque cycle | Rattrapage des échecs de déploiement avec une aide humaine limitée |
Les équipes industrielles voudront souvent combiner les deux. Les résiduels simulés (et plus largement la pile sim-to-real) permettent de relever le plancher à moindre coût. Les boucles de RL en conditions réelles permettent d’aller plus loin sur les échecs liés aux contacts ou aux cas rares qui échappent encore au jumeau numérique. Le VLA reste le socle ; les couches de RL sont le moyen de le rendre moins fragile.
La CoRL 2026, qui se tient du 9 au 12 novembre à Austin (Texas), est un cadre naturel pour cette évolution : l’article sur le RL résiduel centré sur les objets figure au programme de la conférence, tandis que les jeux de données et les méthodes itératives de RL en conditions réelles continuent de paraître sous forme de prépublications, que la communauté mettra à l’épreuve dans les mois à venir [6][1][3].
Ce que les équipes industrielles doivent en retenir
Pour les projets pilotes en usine et en entrepôt, le résultat du résiduel est immédiatement exploitable, puisqu’il n’exige pas des opérateurs qu’ils mènent un RL risqué sur le robot. Si l’on sait estimer la pose des objets pour les gestes qui comptent (tiroirs, gobelets, cubes, cibles de prise et de dépose), un résiduel entraîné en simulation peut améliorer le taux de réussite d’un VLA de type GR00T laissé figé, selon le protocole FR3 décrit plus haut [1][2]. La boucle d’auto-amélioration transforme ensuite les exécutions corrigées en nouvelles données supervisées, ce qui est précieux lorsque les téléopérateurs sont la ressource rare.
Le message d’Evo-RL est différent et complémentaire. Sur l’insertion de vis avec PiperX, combiner les interventions et une réutilisation guidée par l’avantage a fait mieux que les interventions seules et que RECAP, selon les indicateurs d’ASR et de débit des auteurs [3]. Sur le pliage avec SO-101, la même boucle a réduit les tentatives répétées à l’étape de l’étalement tout en relevant l’ASR global [3]. Ce schéma importe pour la robotique industrielle fondée sur l’IA : consacrer le temps humain aux modes de défaillance que la politique actuelle rencontre réellement, puis laisser les estimations de valeur décider quelles images autonomes méritent davantage de poids.
Aucun des deux articles ne prétend que le RL résiduel ou en conditions réelles remplace de meilleurs modèles de base, des données synthétiques plus riches ou une identification soigneuse des systèmes. Ils affirment une chose plus étroite, mais utile : une fois que l’on dispose d’un VLA, il existe une couche supplémentaire mesurable.
Les limites à garder à l’esprit
- La dépendance aux poses. Les résiduels centrés sur les objets exigent des estimations fiables, à six degrés de liberté, des bons objets. Les scènes encombrées et la sélection autonome des objets restent des problèmes ouverts, que les auteurs de Microsoft signalent comme pistes de travaux futurs [1].
- Le coût humain. Evo-RL nécessite toujours des opérateurs pour les interventions, même si des corrections ciblées font mieux que des démonstrations supplémentaires à budget égal [3].
- La portée des affirmations. Le résultat de 42 % → 76 % du résiduel porte sur cinq tâches réalisées sur FR3, à raison de 20 essais chacune [1][2]. Le gain de 30,46 points d’Evo-RL par rapport à RECAP concerne l’insertion de vis sur PiperX, selon le protocole d’ASR de la prépublication [3]. Aucun des deux ne constitue un classement universel des robots.
- Le statut de prépublication. Les chiffres d’Evo-RL proviennent d’une prépublication arXiv dont l’évaluation par les pairs n’est pas achevée [3].
En résumé
L’imitation a produit les premières politiques robotiques généralistes réellement utiles. La couche suivante consiste à apprendre de ses erreurs, soit en entraînant en simulation un résiduel correctif qui se greffe sur un VLA figé, soit en itérant sur des déploiements réels avec une expérience sélective. Dans les deux cas, le principe est le même : conserver le modèle de fondation et lui apprendre à ne plus échouer au dernier centimètre.
À lire aussi
- Modèles vision-langage-action : la nouvelle couche de base des robots
- Sim-to-real en 2026 : combler l’écart sans données réelles à l’infini
- RoboColosseum et la course à la mesure de l’intelligence physique en conditions réelles
Références / sources
- Kinam Kim, Namiko Saito, Heecheol Kim, Katsushi Ikeuchi, Jaegul Choo, Yasuyuki Matsushita — « Object-Centric Residual RL for Zero-Shot Sim-to-Real VLA Enhancement », article de Microsoft Research (17 juin 2026) ; Conference on Robot Learning (CoRL) 2026. https://www.microsoft.com/en-us/research/articles/object-centric-residual-rl/ · https://www.microsoft.com/en-us/research/publication/object-centric-residual-rl-for-zero-shot-sim-to-real-vla-enhancement/
- Même travail en prépublication : arXiv:2606.18953 (juin 2026). Publication évaluée par les pairs : CoRL 2026. https://arxiv.org/abs/2606.18953
- Kai Ye, Yifan Jin, Qianhang Luo et al. — « Evo-RL: Iterative Robot Reinforcement Learning from Selective Experience », arXiv:2610.13345 (prépublication arXiv, non évaluée par les pairs). https://arxiv.org/abs/2610.13345
- Physical Intelligence et al. — « π*0.6: a VLA that learns from experience » (RECAP), tel que cité par Evo-RL ; voir aussi les actualités de recherche de Physical Intelligence. https://www.pi.website/
- Contexte sur les fondements des VLA et les améliorations de type RECAP : AndBeyond.Tech — Modèles vision-langage-action : la nouvelle couche de base des robots.
- Conference on Robot Learning 2026 — site de la conférence (Austin, Texas, 9-12 novembre 2026). https://2026.corl.org/
- À lire aussi : AndBeyond.Tech — Sim-to-real en 2026 : combler l’écart sans données réelles à l’infini.
Images : illustrations originales créées pour AndBeyond.Tech ; aucun logo ni aucune personne réelle n’y figurent.