Au cœur du commutateur IA : l’optique co-packagée passe de la démonstration de laboratoire au réseau refroidi par liquide
L’optique co-packagée entre dans les commutateurs IA : densité CPO, refroidissement liquide, ports 1,6T et arbitrages énergétiques face aux modules enfichables.
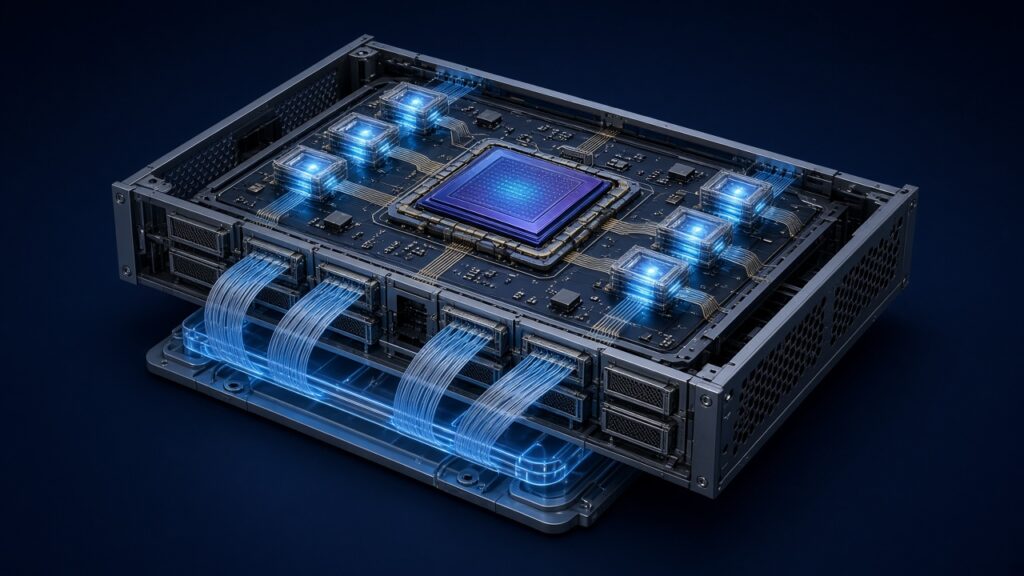
Pendant une décennie, les réseaux de clusters d’IA ont gagné en bande passante en intégrant des SerDes toujours plus rapides dans les ASIC de commutation et en garnissant la façade de modules enfichables toujours plus denses. La recette fonctionne encore, jusqu’au moment où chaleur, portée et consommation de la baie entrent en collision. À 800G, et plus encore à 1,6T par port, le court trajet en cuivre entre le brochage de l’ASIC et une cage OSFP éloignée commence à ressembler davantage à une taxe sur la consommation et l’intégrité du signal qu’à un atout commode pour la maintenance. L’optique co-packagée (CPO, co-packaged optics) y répond en plaçant les moteurs optiques sur le même substrat de boîtier que la puce de commutation, la conversion en lumière s’opérant à quelques millimètres de la puce.
Octobre 2026 a marqué un basculement visible : des feuilles de route, on est passé à des systèmes que l’on peut montrer du doigt sur les stands de l’OCP. Celestica a présenté le DS6005, un commutateur Ethernet CPO entièrement refroidi par liquide, bâti sur la plateforme Tomahawk 6 – Davisson de Broadcom. À la GTC de Berlin, NVIDIA a associé ses systèmes Spectrum-X Ethernet Photonics et Spectrum-6 CPO à une extension de sa chaîne d’approvisionnement en moteurs optiques. Dans son compte rendu de l’OCP, Dell’Oro a présenté cette même semaine comme l’entrée de la CPO dans une phase de commercialisation précoce : pas encore d’adoption de masse, mais plus seulement un poster de laboratoire.
Cet article reste à l’intérieur de la salle informatique : comment la CPO transforme le commutateur IA, ce que les fournisseurs ont réellement livré ou annoncé à l’automne 2026, comment la consommation électrique et le refroidissement liquide s’entremêlent avec des baies plus denses (y compris la pression décrite dans La baie de 1 MW), et ce que les exploitants doivent demander avant de considérer la CPO comme un remplacement direct pour chaque commutateur leaf. Il ne rouvre délibérément pas la guerre des protocoles entre InfiniBand et Ethernet (voir notre précédent dossier, InfiniBand vs Ethernet pour les clusters IA) et ne traite ni de l’interconnexion multi-campus (DCI) ni des liaisons cohérentes ZR longue distance, qui relèvent d’un autre problème optique.
Pourquoi l’optique enfichable se heurte à un mur dans les réseaux d’IA
L’optique enfichable s’est imposée lors de la génération précédente pour de bonnes raisons : remplacement sur site, modules multifournisseurs et séparation nette entre les chaînes d’approvisionnement des puces de commutation et de l’optique. Dans un réseau back-end d’IA, toutefois, chaque watt dépensé pour compenser les pertes électriques sur la carte est un watt soustrait aux GPU, et chaque millimètre de cuivre à haut débit accroît le risque d’une égalisation complexe, de resynchroniseurs (retimers) et de points chauds en façade.
La note technique de SK hynix d’octobre 2026 (rédigée avec des contributeurs universitaires) expose clairement la physique du problème : à mesure que la capacité des commutateurs et la vitesse des ports augmentent, le trajet électrique entre l’ASIC et les cages de la façade devient un défi croissant pour la consommation et l’intégrité du signal. La CPO raccourcit ce trajet en plaçant le moteur optique à côté de l’ASIC sur un substrat de boîtier commun, puis en confiant le trajet plus long à la fibre. L’évaluation par Meta d’un système de commutation CPO présentée à l’ECOC 2025, citée dans cette note, fait état d’une consommation inférieure d’environ 65 % pour la partie interconnexion optique par rapport à une architecture enfichable comparable, dans les conditions de test publiées : une donnée importante, mais pas une garantie universelle pour chaque référence.
Le blog technique de NVIDIA consacré à Spectrum-X Ethernet Photonics (janvier 2026) va plus loin dans les écarts revendiqués pour sa solution CPO : une consommation divisée par 5 par port de 1,6 Tb/s par rapport aux interconnexions enfichables, une disponibilité de l’IA sans instabilité de liaison (link flap) 5 fois plus longue que celle des solutions Ethernet standard et une résilience du réseau 10 fois supérieure, selon la présentation de NVIDIA. Ce sont les affirmations publiées par NVIDIA pour sa conception Spectrum-X à photonique intégrée ; les exploitants doivent les considérer comme des indicateurs du fournisseur en attendant des mesures indépendantes sur des clusters, mais elles expliquent pourquoi les hyperscalers acceptent de rouvrir le débat sur la maintenabilité.
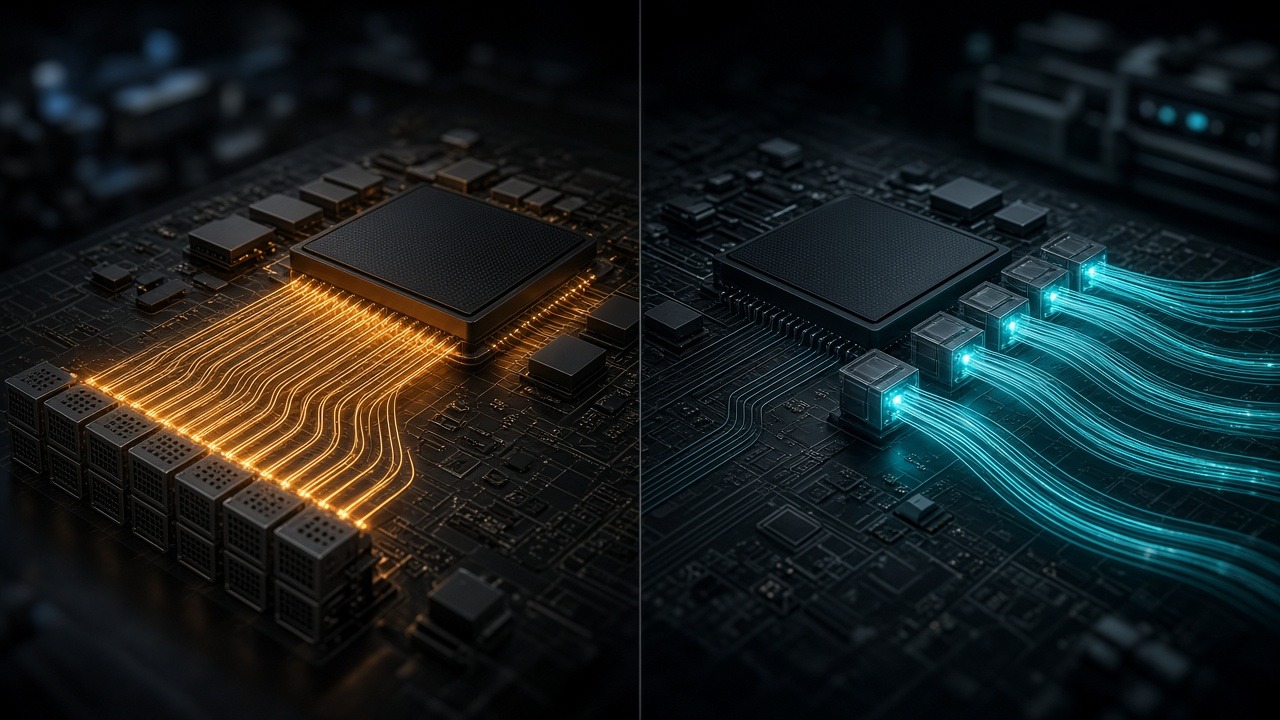
Ce que recouvre concrètement un « commutateur CPO »
Un commutateur IA CPO de production ne se résume pas à une photo de puce. L’ensemble du système comprend généralement :
- L’ASIC de commutation : les exemples actuels reposent sur des puces Ethernet de la classe Broadcom Tomahawk 6 et sur NVIDIA Spectrum-6.
- Les moteurs optiques co-packagés : des convertisseurs en photonique sur silicium placés à côté de l’ASIC.
- La source laser externe (ELS) : une lumière continue fournie hors du boîtier, afin que les lasers ne surchauffent pas la zone la plus chaude de la puce ; Celestica comme NVIDIA mettent en avant des solutions de laser ou de fibre remplaçables sur site ou détachables pour faciliter la maintenance.
- La conception thermique et mécanique : presque toujours un refroidissement liquide, aux densités qu’exigent les baies d’IA OCP ORv3.
- Le logiciel : SONiC ou le système d’exploitation réseau du fournisseur, avec un inventaire adapté à la CPO, le suivi de l’état des lasers et la cartographie des fibres.
L’annonce de Celestica du 12 octobre 2026 attribue au DS6005 une capacité de commutation pouvant atteindre 102,4 Tb/s, 64 ports 1,6TbE à capacité optique, un format ORv3 compact de 1,5OU, un refroidissement entièrement liquide et la prise en charge de SONiC. La division Optical Systems de Broadcom y est citée : elle décrit ce travail comme le passage de la CPO du stade d’architecture avancée à celui de système prêt pour la production, grâce au partenariat sur Tomahawk 6 – Davisson. Celestica positionne la plateforme sur les réseaux d’IA scale-up comme scale-out : la question de la densité optique se pose désormais aussi à proximité des pods de GPU et dans les architectures leaf-spine de scale-out, et plus seulement sur les réseaux Ethernet frontaux classiques.
La famille Spectrum-6 de NVIDIA, documentée dans ses manuels matériels SN6000 et sur son blog consacré à la photonique, couvre des formats enfichables et CPO. Le SN6810-LD y est décrit comme un système Spectrum-6 en photonique sur silicium (CPO) refroidi par liquide, offrant 102,4 Tb/s avec une connectique fibre MMC-16 ; le système Photonics multi-ASIC de la classe SN6800 est positionné à 409,6 Tb/s, avec un brassage de fibres intégré pour un scale-out à haute radix. Le blog consacré à la photonique met en avant un raccordement de fibre détachable à incidence normale et des moteurs optiques compatibles avec la refusion par brasage, testés avant assemblage : autant de détails de fabrication décisifs si la CPO doit sortir des volumes confidentiels.
Octobre 2026 : une commercialisation précoce, pas une généralisation
Le calendrier compte, car le secteur dispose enfin de preuves simultanées et datées :
- 12 octobre 2026 : lancement du DS6005 de Celestica, calé sur l’OCP Global Summit 2026 (12-15 octobre).
- 19 octobre 2026 : note de Dell’Oro sur l’optique à l’OCP : les commutateurs NVIDIA Spectrum-X Ethernet Photonics entrent en production avec de premières adoptions par des clients ; le DS6005 de Celestica est présenté comme un système CPO Broadcom Davisson refroidi par liquide ; l’optique quasi co-packagée (NPO) et la densification des modules enfichables restent dans la course. Dell’Oro prévient explicitement qu’une commercialisation précoce n’est pas une adoption généralisée : qualification, rendements de fabrication, maintenabilité et volumes livrés demeurent les indicateurs à suivre.
- 21 octobre 2026 : salle de presse de NVIDIA : avec SPIL, NVIDIA prévoit d’accroître à Taïwan ses capacités de production de moteurs optiques pour l’optique co-packagée, avec pour objectif une multiplication par 15 d’ici mi-2027, puis un nouveau doublement d’ici fin 2028. (SDxCentral a couvert la même présentation de la GTC de Berlin la même semaine ; le chiffre de 15 figure dans le communiqué de NVIDIA lui-même.)
Cette ligne sur la chaîne d’approvisionnement est l’indice industriel. On ne réserve pas d’extensions de capacité de moteurs optiques pour mi-2027 si les références CPO ne quittent pas le plateau des échantillons d’ingénierie. De même, la prudence de Dell’Oro est l’indice pour les exploitants : la CPO cohabitera pendant des années avec l’enfichable et la NPO. Les perspectives d’Arista à l’échelle de la baie, citées dans la même note de Dell’Oro, esquissent des trajectoires de densité allant des conceptions à base d’OSFP vers une intégration optique de plusieurs pétabits par baie : une vision architecturale, et non la preuve que chaque commutateur leaf sera livré en CPO dès demain.
Consommation, refroidissement liquide et baie hyperscale
La CPO relève autant de l’énergie et des systèmes électriques de l’IA que de la photonique. Les citations du lancement de Celestica mettent fortement l’accent sur la consommation, la gestion thermique, la latence et la portée comme contraintes d’égale importance. Le refroidissement liquide n’est pas un accessoire de mode sur le DS6005 ou sur les systèmes Photonics SN68xx-LD de NVIDIA : c’est ce qui permet de loger un boîtier CPO et un ASIC à haute radix dans un volume de 1,5OU à 2RU sans griller les moteurs optiques.
Ce point recoupe directement la densité de puissance des baies. À mesure que les usines d’IA s’orientent vers des baies de l’ordre du mégawatt et une distribution en courant continu par jeux de barres, les équipements réseau qui gaspillent des watts dans l’égalisation des SerDes au niveau de la carte entrent en concurrence avec les GPU pour le même budget thermique et électrique. Les exploitants déjà aux prises avec les contraintes de conception de la baie de 1 MW devraient intégrer l’évaluation de la CPO au même tableur : des watts par bit utile livré à la carte réseau du GPU, et non des watts par port affiché dans la brochure.
Le résultat publié par Meta à l’ECOC (une consommation de l’interconnexion optique réduite d’environ 65 % par rapport à l’enfichable dans ce test) et la division par 5 revendiquée par NVIDIA par port de 1,6T relèvent de méthodologies et de produits différents, mais vont dans le même sens. La question opérationnelle restée sans réponse est celle du coût sur l’ensemble du cycle de vie : modules ELS, complexité du brassage des fibres, stratégie de pièces de rechange, et savoir si la défaillance d’un moteur optique impose le retour du commutateur entier ou une simple intervention sur site sur le laser ou la fibre. L’insistance de Celestica sur des modules laser externes remplaçables sur site et le discours de NVIDIA sur la fibre détachable visent à répondre à cette objection avant qu’elle ne compromette les déploiements.
Fabrication, rendement et importance soudaine des chaînes d’approvisionnement
Les problèmes les plus ardus de la CPO ne sont pas seulement optiques : ils sont industriels. Les modules enfichables peuvent être rodés, stockés et remplacés indépendamment de l’ASIC de commutation. Le co-packaging lie le rendement de la photonique à celui de la commutation, à moins que les fabricants n’inventent des parades de procédé. Le blog de NVIDIA consacré à la photonique met en avant des moteurs compatibles avec la refusion par brasage, entièrement testables avant assemblage, une fibre détachable à incidence normale pour un assemblage automatisé en fin de chaîne, et un procédé de fabrication visant un rendement élevé des boîtiers. Ces détails paraissent prosaïques à côté des gros titres sur le térabit ; ce sont pourtant eux qui distinguent un plateau de démonstration d’une référence qu’un sous-traitant peut planifier.
Le discours de Celestica sur son partenariat avec Broadcom insiste de même sur la collaboration entre puces, moteurs optiques, mise en boîtier, conception thermique, fabrication et intégration système. Cette liste constitue la véritable nomenclature de la CPO : qu’une seule discipline fasse défaut, et le commutateur reste un projet de recherche. Le plan de capacité de NVIDIA et SPIL du 21 octobre 2026 (une capacité de moteurs optiques multipliée par 15 d’ici mi-2027, avec l’objectif de la doubler encore d’ici fin 2028, selon la salle de presse de NVIDIA) s’interprète comme un pari sur la maturité de ces parades de fabrication pour un passage à l’échelle. La couverture de SDxCentral, le même jour, de la présentation de la GTC de Berlin reprend ce chiffre sous forme d’article de presse spécialisée ; l’attribution primaire retenue dans cet article est le communiqué de NVIDIA.
Pour les acheteurs, les annonces de capacité envoient un signal ambivalent. Davantage de moteurs laisse présager des délais de livraison plus courts à l’avenir, mais aussi que l’offre à court terme sera d’abord allouée aux plus grands programmes d’usines d’IA. Les néoclouds de taille intermédiaire qui évaluent des systèmes de la classe DS6005 ou Spectrum Photonics devraient poser explicitement la question des allocations pour 2027, des réserves de modules ELS et d’un éventuel approvisionnement optique auprès d’une source unique.
Enfichable, NPO et CPO : une carte de la coexistence
Il est tentant de présenter la CPO comme une fatalité. La synthèse de Dell’Oro sur l’optique à l’OCP 2026 récuse ce simplisme. Les écosystèmes OSFP enfichables continuent de gagner en densité ; l’optique quasi co-packagée (NPO) constitue une approche mécanique intermédiaire ; les voies CPO/NPO ouvertes et les approches XPO apparentées figurent dans les réflexions d’architecture à l’échelle de la baie (y compris les perspectives de densité d’Arista, qui vont des chiffres actuels de l’ordre du pétabit par baie en OSFP vers des objectifs de plusieurs pétabits, présentées comme une trajectoire architecturale et non comme la preuve de livraisons en volume). Le plan réseau réaliste pour 2026-2028 s’organise donc par niveaux :
- Le réseau frontal et les commutateurs leaf à faible risque pourront rester en enfichable pendant des années, ce qui préserve des pratiques de rechange éprouvées.
- Les commutateurs spine de scale-out d’IA à haute radix et les commutateurs de milieu de rangée contraints en puissance sont les premiers candidats à la CPO.
- Les domaines expérimentaux de scale-up en Ethernet pourront adopter la CPO là où la longueur du cuivre et la consommation deviennent rédhibitoires à l’intérieur de la baie, sans confondre ce choix avec des réseaux mémoire de la classe NVLink.
Les exploitants doivent aussi garder à l’esprit que la CPO ne choisit pas à leur place entre InfiniBand et Ethernet. Elle modifie la couche physique et l’enveloppe de consommation du réseau de paquets, quel qu’il soit, qu’ils ont déjà retenu. Les fonctions protocolaires (contrôle de congestion, routage adaptatif, profil RDMA) continuent de déterminer le temps d’exécution des tâches une fois les photons sortis du boîtier. Mise en boîtier et protocoles ne sont liés que par les watts et la densité de ports.
Discours sur la fiabilité et réalité des parcs
Les affirmations des fournisseurs sur la fiabilité méritent un examen sceptique à part entière. NVIDIA annonce pour Spectrum-X Ethernet Photonics une disponibilité de l’IA sans instabilité de liaison 5 fois plus longue et une résilience 10 fois supérieure à celles de références Ethernet standard. L’évaluation CPO de Meta présentée à l’ECOC 2025, telle que résumée par SK hynix, souligne à la fois la baisse de consommation (environ 65 % pour la partie interconnexion optique testée) et la stabilité des connexions sur une période d’exploitation prolongée dans ces conditions. Aucun de ces résultats ne dispense un exploitant de mesurer le temps moyen entre deux interventions optiques dans son infrastructure fibre, avec sa discipline de nettoyage et son environnement vibratoire et électromagnétique.
La CPO déplace le domaine de défaillance. De la poussière sur un connecteur MMC, un canal ELS en limite de tolérance ou un gradient thermique dans le boîtier peuvent apparaître à NCCL comme un « réseau défaillant », alors même que le pipeline de l’ASIC est sain. Les procédures d’exploitation doivent intégrer des réflexes de diagnostic optique, à la manière d’un réflectomètre (OTDR), à côté des tableaux de bord PFC/ECN. La formation des équipes du NOC fait partie du coût total de possession que les présentations commerciales passent sous silence.
Comment la CPO transforme la conception des réseaux de clusters d’IA
Radix et topologie. Une bande passante supérieure dans un nombre réduit d’unités OU permet aux architectes d’augmenter la radix des commutateurs leaf ou de supprimer des niveaux. Le discours de NVIDIA sur le SN6800 Photonics multi-ASIC (409,6 Tb/s, brassage intégré) vise explicitement un scale-out à plat pour de très grands nombres de GPU. Les 64 ports de 1,6T en 1,5OU de Celestica répondent à la même pression de densité, du côté de l’écosystème Broadcom.
Portée et infrastructure fibre. La CPO ne supprime pas l’ingénierie de la fibre. Le câblage monomode MMC ou équivalent, la polarité et la propreté des connecteurs deviennent des compétences de premier plan pour le NOC. Les pannes ne se règlent plus en « remplaçant le QSFP », mais en « diagnostiquant le boîtier, l’ELS ou le câble de liaison ».
Logiciel et observabilité. La prise en charge de SONiC par le DS6005 compte, car les réseaux d’IA hyperscale se standardisent déjà sur les fonctions des systèmes d’exploitation réseau ouverts pour la mise en mémoire tampon, l’ECN et l’équilibrage de charge adapté à l’IA. L’état de la CPO doit figurer dans le même plan de télémesure que la profondeur des files d’attente : polarisation des lasers, température et puissance optique sont désormais des indicateurs clés du réseau.
Optique de scale-up et de scale-out. Les fournisseurs brouillent de plus en plus le vocabulaire : la même puce de commutation CPO peut équiper des commutateurs spine de scale-out ou des domaines de scale-up plus denses, à mesure que le cuivre s’essouffle à l’intérieur de la baie. La CPO ne se substitue pas pour autant aux réseaux mémoire de la classe NVLink ; cela signifie que les expérimentations de scale-up en Ethernet et le scale-out à haute radix partageront une même feuille de route de mise en boîtier optique. Le choix du protocole reste une décision distincte (voir, là encore, InfiniBand vs Ethernet pour les clusters IA).
Coexistence. La synthèse de Dell’Oro sur l’OCP constitue la référence la plus sobre : l’enfichable continue de gagner en densité, la NPO se situe entre les deux, et la CPO s’impose là où la consommation et la radix justifient un nouveau modèle de maintenance. Une nomenclature rationnelle d’usine d’IA en 2027 pourra combiner les trois selon les niveaux.
Ce qu’il faut exiger d’un pilote CPO
Les exploitants qui préparent une vague de qualification après l’OCP 2026 devraient exiger des preuves, et non des slogans :
- Les watts par équivalent 800G/1,6T sous un trafic de type NCCL ou MLPerf, mesurés dans la même enveloppe thermique de baie qu’en production.
- Les taux d’instabilité de liaison et de baisses de puissance optique sur des essais d’endurance de plusieurs semaines : les affirmations de NVIDIA sur la disponibilité sans instabilité de liaison fixent une barre que les autres doivent atteindre ou relativiser.
- Le temps d’intervention en cas de défaillance de l’ELS ou du raccordement de la fibre, comparé à un remplacement du système entier.
- Une politique de fibres et de connecteurs multifournisseurs, ou un plan d’infrastructure fibre à source unique assumé en toute transparence.
- La parité fonctionnelle du système d’exploitation réseau avec la référence enfichable à laquelle vous faites déjà confiance (ECN, routage adaptatif, mise en mémoire tampon, télémesure IA).
- Un engagement d’approvisionnement aligné sur les courbes de capacité de moteurs optiques à mi-2027 : l’objectif affiché par NVIDIA et SPIL d’une capacité multipliée par 15 d’ici mi-2027 (salle de presse de NVIDIA, 21 octobre 2026) constitue un signal utile pour l’ensemble du secteur, même si vous n’achetez jamais de Spectrum-X.
Perspectives
L’optique co-packagée pour les réseaux de clusters d’IA a franchi un seuil : commutateurs CPO refroidis par liquide reposant sur des ASIC identifiés, lancements calés sur l’OCP, familles de produits Photonics et plans de capacité de moteurs optiques exprimés en multiples à l’horizon mi-2027. C’est une commercialisation précoce, et non la fin de l’enfichable. Les gagnants seront les équipes qui évalueront la CPO à l’aune du temps d’exécution des tâches et des joules par jeton dans de véritables réseaux de GPU, tout en gérant l’exploitation de la fibre avec la même rigueur que les boucles de refroidissement liquide des GPU.
Pour les bâtisseurs d’infrastructures hyperscale, la question stratégique n’est plus « la CPO est-elle réelle ? », mais « quels niveaux du réseau méritent la CPO en premier, et comment ce choix s’articule-t-il avec les enveloppes de puissance et de refroidissement des baies de l’ordre du mégawatt ? ». Il faut y répondre par des pilotes, et non par des keynotes, en menant dans des chantiers distincts les débats sur les protocoles, l’interconnexion entre campus et la physique de la mise en boîtier, afin que chacun avance à son propre rythme.
À lire aussi
- La baie de 1 MW : comment le 800 V CC et le refroidissement à l’eau tiède recâblent l’usine d’IA
- InfiniBand vs Ethernet pour les clusters IA : la guerre des fabrics dans l’usine IA
- Ultra Ethernet 1.1 : quand l’Ethernet de l’IA se dote d’en-têtes scale-up, d’opérations collectives et d’un contrôle de congestion programmable
- Superfactories IA distribuées : comment le réseau s’étire entre les campus
Sources
- Celestica — “Celestica Introduces the DS6005 Data Center Switch with Co-Packaged Optics…” (12 October 2026). https://corporate.celestica.com/news-releases/news-release-details/celestica-introduces-ds6005-data-center-switch-co-packaged
- SDxCentral — “Celestica debuts liquid-cooled CPO switch for AI fabrics” (14 October 2026). https://www.sdxcentral.com/news/celestica-debuts-liquid-cooled-cpo-switch-for-ai-fabrics/
- NVIDIA Newsroom — “NVIDIA and Supply Chain Partners Expand Capacity…” (21 October 2026). https://nvidianews.nvidia.com/news/nvidia-and-supply-chain-partners-expand-capacity-to-accelerate-ai-infrastructure-buildout
- SDxCentral — “Nvidia targets 15x optics capacity expansion by 2027…” (21 October 2026). https://www.sdxcentral.com/news/nvidia-targets-15x-optics-capacity-expansion-by-2027-to-meet-cpo-demand/
- Dell’Oro — “OCP 2026 AI Networking: Six Key Trends in Optics” (19 October 2026). https://www.delloro.com/ocp-2026-optics-takes-center-stage-in-enabling-the-next-wave-of-ai-networking-and-high-speed-switching/
- NVIDIA Technical Blog — “Scaling Power-Efficient AI Factories with NVIDIA Spectrum-X Ethernet Photonics” (6 January 2026). https://developer.nvidia.com/blog/scaling-power-efficient-ai-factories-with-nvidia-spectrum-x-ethernet-photonics/
- NVIDIA Blog — “NVIDIA Spectrum-6 Arrives in Gigascale AI Factories.” https://blogs.nvidia.com/blog/nvidia-spectrum-six-arrives-in-gigascale-ai-factories/
- NVIDIA — Spectrum-6 SN6000 Switch Systems Hardware User Manual (Introduction). https://networking-docs.nvidia.com/sn6000hw/introduction
- SK hynix Newsroom — “How silicon photonics and CPO are building the ‘highways of light’” (29 October 2026). https://news.skhynix.com/en/tech-note-series-ep3/
Images : illustrations originales créées pour AndBeyond.Tech ; aucun logo ni aucune personne réelle n’y figurent.