Modelos frontier de pesos abiertos vs APIs cerradas: el trade-off de soberanía
Open-weight frente a APIs cerradas: soberanía, coste, cumplimiento y cuándo un lab o empresa debe alojar sus pesos de verdad.
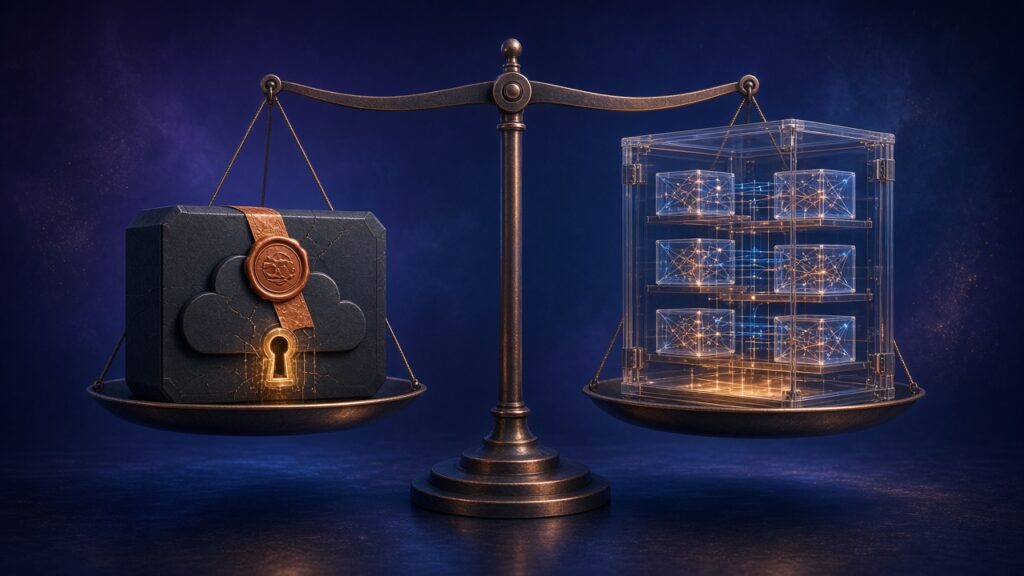
Elegir entre modelos open-weight que puedes alojar y APIs de frontera cerradas no es un concurso de belleza: es una decisión de soberanía, coste y control.
Los equipos de IA empresarial ya no enfrentan la bifurcación «usar GPT o no construir nada». Lanzamientos de LLM open weight de varios laboratorios van unos pocos meses detrás de la frontera cerrada en índices agregados de capacidad, mientras las plataformas para desarrolladores enrutan decenas de billones de tokens por endpoints open de autoservicio. Al mismo tiempo, los dólares LLM empresariales siguen concentrados en APIs cerradas. La pregunta real de 2026 no es qué bando «gana», sino qué mezcla de modelos de IA autoalojados, inferencia open-weight alojada y APIs cerradas encaja con tus restricciones de soberanía IA, cumplimiento y economía unitaria.
Este artículo mapea el contrapartida con evidencia pública: cuán cerca están los pesos abiertos en capacidad, adónde van realmente tokens y dólares, qué significa «abierto» bajo las reglas europeas, y qué criterios de decisión sobreviven al contacto con GPUs, silicio edge y auditores.
Qué significa realmente «abierto» en 2026
«Open weight» no es sinónimo de código abierto. Los pesos pueden descargarse bajo licencias estilo Apache o MIT, bajo licencias comunitarias a medida con topes de uso, o bajo términos que prohíben ciertos usos comerciales. Las fichas de arquitectura, las recetas de entrenamiento y los inventarios de datasets forman otro eje. La Open Source AI Definition de la Open Source Initiative sigue siendo un listón más estricto que «pesos en un hub», y muchos lanzamientos populares no lo cumplen —aunque sean muy usables en producción.
El derecho de producto europeo fuerza ya el vocabulario. Bajo la vía del artículo 53(2) de la AI Act de la UE para modelos de IA de propósito general, los proveedores que publican un modelo bajo licencia libre y de código abierto —con parámetros que incluyen pesos, arquitectura e información de uso disponibles públicamente— pueden quedar exentos de algunas obligaciones documentales frente a autoridades y proveedores downstream, y de designar un representante autorizado si no son de la UE. Esas exenciones no aplican a modelos clasificados como GPAI de riesgo sistémico. Incluso cuando aplican las exenciones documentales, siguen exigiendo una política de cumplimiento de derechos de autor y un resumen suficientemente detallado del contenido de entrenamiento. Para el comprador, la lección práctica es clara: trata «abierto» como una lista de comprobación de cumplimiento, no como un adjetivo de marketing.
El texto de la licencia sigue importando aunque los pesos sean públicos. Las concesiones Apache-2.0 y estilo MIT atraviesan limpiamente la mayoría de revisiones legales empresariales. Las licencias comunitarias a medida —comunes en grandes familias Llama y algunas líneas Mistral— pueden restringir el uso por proveedores de modelos competidores, imponer políticas de uso aceptable o cambiar la historia de redistribución de los productos que envías. Trata el archivo de licencia como un artefacto de primera clase junto al shard GGUF o safetensors: si legal no puede validarlo para tu banda de MAU o tu geografía, el modelo no está «disponible» para producción por muy fuerte que se vea el gráfico de eval.
El autoalojamiento añade otra capa. Ejecutar pesos en tu VPC, en instalaciones propias o en un entorno aislado de la red compra residencia de datos e inspeccionabilidad que una API de frontera multi-inquilino no puede igualar. Alojar los mismos pesos abiertos vía una API de inferencia de terceros compra comodidad y elasticidad —pero reintroduce un límite de proveedor. El diseño de cartera debe nombrar cuál de esas tres superficies usa cada carga: API de frontera cerrada, API open-weight alojada o autoalojado / en dispositivo.
Capacidad: un retraso duradero, no un abismo
El seguimiento Epoch Capabilities Index (ECI) de Epoch AI muestra que, desde enero de 2026, los modelos open-weight más capaces han ido con un retraso medio de unos cuatro meses respecto a los modelos cerrados de punta, con una brecha ECI media de unos ocho puntos —del orden de la brecha que Epoch asocia a lanzamientos cerrados sucesivos como GPT-5 frente a GPT-5.5. Es un número de planificación, no una sentencia. Cuatro meses es poco para que fine-tuning, retrieval, tool use y enrutado en cascada cierren a menudo la brecha de producto en tareas definidas, y bastante para que los equipos que persiguen razonamiento de frontera absoluto, profundidad multimodal o funciones de agente brand-new sigan prefiriendo APIs cerradas para la punta de la pila.
La investigación Mixture-of-Agents ilustra la otra cara: la colaboración en capas entre modelos abiertos puede superar una referencia cerrada fuerte en benchmarks de preferencia. En el paper MoA Together / académico de 2024, un Mixture-of-Agents solo-open alcanzó un 65,1 % de win rate controlado por longitud en AlpacaEval 2.0 frente al 57,5 % de GPT-4 Omni en esa comparación —evidencia de que la orquestación, no solo el recuento de parámetros, mueve la frontera de Pareto. Las cascadas cortan el otro camino en coste: FrugalGPT (2023) mostró que enrutar consultas a través de APIs LLM heterogéneas puede igualar la precisión de un modelo individual top con hasta cerca de un 98 % de reducción de coste en la tarea financiera HEADLINES de ese estudio (unos 73 % en OVERRULING y unos 59 % en COQA), o mejorar la precisión al mismo gasto. Esos papers son anteriores a las model cards de hoy, pero la lección arquitectónica es perenne: enruta, no fetichices un solo endpoint.
Tokens frente a dólares: dos mercados distintos
La telemetría de uso y el gasto empresarial cuentan historias distintas —y ambas importan para planificar la soberanía.
A finales de 2025, el estudio State of AI de OpenRouter —construido sobre unos 100 billones de tokens de tráfico de plataforma en esa ventana— sitúa los modelos open-weight en cerca de un tercio del volumen de tokens al final del periodo, con familias open chinas (DeepSeek, Qwen y pares) aportando gran parte de esa franja open tras las olas de lanzamiento de mediados de 2025. Roleplay y programación dominan el mix de categorías open-weight en esa plataforma; los modelos propietarios siguen cargando gran parte del coding y el trabajo de conocimiento de mayor riesgo. La estructura dual es duradera: los sistemas cerrados definen el techo de fiabilidad que muchas empresas compran; los sistemas abiertos absorben el volumen sensible al precio y a la personalización.
La cuota dólar empresarial se ve más conservadora. Según el State of Generative AI in the Enterprise 2025 de Menlo Ventures, el gasto en IA generativa es de unos 37.000 millones de dólares, incluidos unos 12.500 millones en APIs de modelos fundacionales. Los modelos open-source / open-weight representan cerca del 11 % del uso de API LLM empresarial en ese marco de encuesta —bajando desde cerca del 19 % el año anterior—, mientras Anthropic, OpenAI y Google juntos se llevan la vasta mayoría de la cuota API empresarial de pago. Los modelos open chinos siguen siendo una franja fina de los dólares API empresariales aunque crezcan entre desarrolladores. La actualización de mitad de 2025 de Menlo situaba igualmente a los modelos cerrados detrás de la gran mayoría de cargas empresariales y describía el rendimiento open como retrasado unos nueve a doce meses respecto a la frontera cerrada en esa ventana.
Esas cifras de retraso no son tanto contradictorias como no comparables. La brecha ECI de ~cuatro meses / ~ocho puntos de Epoch es una medida continua y agregada de índice de capacidad que cubre lanzamientos open frente a cerrados desde enero de 2026. La estimación de nueve a doce meses de Menlo es un marco anterior, de encuesta y mercado, del rendimiento open relevante para la empresa frente a la punta cerrada a mediados de 2025. Relojes distintos, métodos distintos, misma historia direccional: los pesos abiertos van detrás de la frontera cerrada, y la brecha se mide en meses —no en años.
Leídos juntos: los modelos de IA autoalojados y las APIs open ganan mente y cuota de tokens donde dominan precio, personalización y experimentación; las APIs cerradas siguen ganando donde dominan compras, SLA de soporte y calidad pico. Los programas de soberanía que solo miran uno de esos gráficos dimensionarán mal la pila.
Coste, control y cumplimiento
El coste no es «precio API × tokens»
Las APIs cerradas convierten tokens marginales en opex casi sin planificar capacidad. El autoalojamiento convierte el mismo trabajo en depreciación de GPU, energía, red, tiempo de SRE, bancos de pruebas y parches de seguridad. Las APIs open-weight alojadas quedan en medio: pagas la curva de utilización de otro pero conservas la elección de modelo. Cascadas y modelos especialistas pequeños (incluidos open weights mid-size cuantizados) suelen vencer a «llamar siempre a la frontera» en coste por resultado exitoso —la métrica hacia la que empujan FrugalGPT y MoA.
Los efectos a lo Jevons siguen aplicando. A medida que la inferencia open y cerrada se abarata, la demanda total de tokens sube. El comentario 2025 de Menlo ya esperaba que el gasto neto en IA generativa siguiera trepando aunque cayeran los costes unitarios de inferencia. Soberanía no significa automáticamente «más barato»; puede significar «predecible», «auditable» o «air-gappable».
Una métrica interna útil es el coste por resultado aceptado: ticket resuelto, extracción correcta o borrador aprobado por un humano —no dólares brutos por millón de tokens. Llamadas de frontera cerradas que cierran un caso duro de un tiro pueden vencer a una cascada open ahorradora que reintenta cinco veces y aun así escala a un humano. A la inversa, enrutar el noventa por ciento del tráfico fácil a un modelo open mid-size cuantizado puede financiar el diez por ciento que de verdad necesita la punta cerrada. Mide ambas piernas antes de declarar un ganador.
Control e inspeccionabilidad
Los pesos que posees pueden hashearse, fijarse en versión, red-teamearse offline, fine-tunearse sobre corpus regulados y ejecutarse sin enviar prompts a un tercer país. Las APIs cerradas dan controles contractuales, endpoints regionales y opciones de retención cero —pero no inspeccionabilidad bit a bit del modelo que llamaste ayer. Para entornos de alta exigencia, esa distinción es el núcleo de la soberanía IA: quién puede cambiar el modelo, quién puede ver los prompts y quién puede probar qué artefacto produjo una decisión.
El cumplimiento está acotado a la carga
La inferencia aislado de la red ayuda con la residencia de datos; no borra preguntas de procedencia de datos de entrenamiento, deberes de política de copyright para proveedores GPAI ni reglas sectoriales sobre decisiones automatizadas. Las exenciones open-source de la AI Act de la UE reducen algunas cargas documentales GPAI; no crean un pase libre para modelos de riesgo sistémico ni para desplegadores de sistemas de IA de alto riesgo. El lenguaje de compra debería exigir: compatibilidad de licencia para tu caso de uso, una model card y suite de evaluación nombradas, registro de IDs de modelo y prompts en tu plano de control, y un fallback documentado si un proveedor cerrado cambia términos o regiones.
Hardware: la puerta silenciosa del autoalojamiento
Las fantasías de soberanía mueren en el ancho de banda de memoria y la capacidad de KV-cache. Las specs del acelerador primario marcan el techo: el H200 de NVIDIA, por ejemplo, lleva 141 GB de HBM3e y 4,8 TB/s de ancho de banda de memoria —casi el doble de capacidad que el H100 y cerca de 1,4× su ancho de banda— y NVIDIA cita hasta cerca de 2× de inferencia Llama-2 más rápida frente al H100 en notas de carga publicadas. Los checkpoints MoE open de clase de frontera siguen queriendo nodos multi-GPU, interconexión rápida e ingeniería de inferencia seria. El software de serving importa tanto como el silicio: la línea vLLM / PagedAttention mostró ganancias de caudal de proceso 2–4× frente a sistemas previos a latencia comparable al paginar el KV-cache y habilitar continuous batching —exactamente el tipo de utilización que necesitas antes de que el autoalojamiento cuadre.
Los modelos open mid-size en la banda aproximada 15B–70B —la cohorte «medium is the new small» de OpenRouter a finales de 2025— son donde muchas empresas encuentran calidad desplegable en un solo acelerador de alta memoria o un clúster pequeño. Las variantes sub-15B y muy cuantizadas empujan más lejos hacia workstations y dispositivos edge cuando dominan la latencia, la operación offline o el coste por consulta.
Por eso los insignias temáticas de IA en el borde y Aceleradores de IA y chips pertenecen a este tema. La inferencia on-device y near-edge encoge el límite de confianza: los prompts no salen de las instalaciones, y la elección de silicio (GPU, NPU, acelerador a medida) pasa a ser parte del producto. Las encuestas empresariales de Menlo ya señalaban modelos que migran al borde por privacidad, latencia y coste API marginal cero. El contrapartida es el margen de capacidad: el silicio edge rara vez aloja la frontera absoluta. Los diseños híbridos mantienen un profesor cerrado o open grande en la nube para los casos duros y un estudiante local para el camino común.
Criterios de decisión para 2026 (lista de comprobación perenne)
Usa las siguientes pruebas por carga de trabajo, no por eslogan corporativo:
- Límite de datos. ¿Deben prompts y embeddings quedarse dentro de una jurisdicción nombrada o un air gap? Si sí, prefiere autoalojado o endpoints privados estrictamente regionales; trata las APIs multi-inquilino públicas como último recurso.
- Techo de capacidad. ¿La tarea necesita la frontera cerrada actual (herramientas de agente nuevas, razonamiento más duro, casos límite multimodales)? Si sí, compra la API cerrada para esa franja y guarda pesos abiertos para la cola larga.
- Forma del volumen. ¿La carga es alto QPS, repetitiva y evaluable? Cascadas, modelos open mid-size y cachés suelen ganar en economía unitaria.
- Control del cambio. ¿Necesitas congelar pesos para validación (médico, industrial, casos de seguridad)? Pesos abiertos que fijas vencen a revisiones API semanales opacas.
- Licencia y encaje con el Act. Confirma que la licencia permite tu MAU, geografía e historia de redistribución; mapea deberes GPAI si redistribuyes o modificas de forma sustancial.
- Madurez ops. ¿Tienes SRE de GPU, regresión de eval y respuesta a incidentes para serving de modelos? Si no, las APIs open-weight alojadas son un peldaño —no un fracaso.
- Opción de salida. ¿Puedes cambiar de proveedor en una semana? Abstrae detrás de un router interno pronto; el hábito multi-modelo estilo OpenRouter es un patrón de resiliencia, no solo un truco de precio.
Un default sobrio para muchas empresas reguladas en 2026: APIs cerradas para calidad pico y trabajo de conocimiento indiferenciado, pesos abiertos autoalojados o en VPC para caminos sensibles y de alto volumen, y modelos edge para funciones offline / ultra baja latencia —con una cascada interna que solo asciende cuando los tramos más baratos fallan una puerta de calidad automatizada.
Conclusión
El contrapartida de soberanía no es «open bueno, cerrado malo». El retraso ECI ~cuatro meses / ~ocho puntos de Epoch (desde enero de 2026) dice que los pesos abiertos están lo bastante cerca como para importar. La cuota de tokens open ~un tercio de OpenRouter a finales de 2025 dice que los desarrolladores ya votan con el tráfico. La cuota open ~11 % del uso LLM empresarial de Menlo en su encuesta 2025 dice que el dinero y los comités de riesgo aún se inclinan al cerrado. El artículo 53(2) de la AI Act de la UE dice que «abierto» es un estatus legal con deberes residuales, no una vibra.
Los equipos que ganan tratan la elección de LLM open weight como construcción de cartera: mide la capacidad en tus evals, precifica el éxito no los tokens, pon el silicio donde la residencia lo exija y conserva una salida contractual de cada dependencia cerrada. La soberanía IA es la capacidad de probar dónde corrió la inferencia, qué artefacto decidió y cómo continuarías si un proveedor o una frontera cerrara mañana.
Lecturas relacionadas
- Los agentes computer-use llegan a producción: lo que realmente funciona en la empresa
- Dentro del mercado de aceleradores de IA: GPUs, ASICs a medida y quién gana la inferencia
- Navegador, IDE y SO: los tres campos de batalla de las interfaces de IA
Referencias
- Open models lag state-of-the-art closed models by 4 months | Epoch AI — Edwards & Emberson; retraso ~4 meses y brecha ECI media ~8 puntos desde enero de 2026.
- State of AI (OpenRouter / a16z) — Aubakirova et al., dic. 2025; estudio ~100T tokens; cuota open-weight ~1/3 al final del periodo.
- 2025: The State of Generative AI in the Enterprise | Menlo Ventures — encuesta 2025: ~37.000 M$ genAI; ~12.500 M$ APIs fundación; open ~11 % del uso LLM empresarial.
- 2025 Mid-Year LLM Market Update | Menlo Ventures — actualización mid-2025: dominio closed-source; open ~9–12 meses detrás.
- How does the AI Act apply to general-purpose AI models released as open-source? | AI Act Service Desk — exenciones art. 53(2), carve-out de riesgo sistémico.
- Mixture-of-Agents (arXiv:2406.04692) — Wang et al., 2024; MoA open 65,1 % vs GPT-4o 57,5 %.
- FrugalGPT (arXiv:2305.05176) — Chen, Zaharia & Zou, 2023; cascada ~98 % / ~73 % / ~59 % de reducción de coste.
- NVIDIA H200 GPU — 141 GB HBM3e, 4,8 TB/s; hasta ~2× Llama-2 vs H100.
- PagedAttention / vLLM (arXiv:2309.06180) — Kwon et al.; throughput 2–4×.
Imágenes: ilustraciones originales creadas para AndBeyond.Tech; no aparecen logotipos ni personas reales.