Marché des accélérateurs IA : GPU, ASIC custom et qui gagne l’inférence
GPU vs ASIC custom sur le marché des accélérateurs IA : NVIDIA, AMD, TPU Google, Trainium, Maia, MTIA, Groq, Cerebras — et qui gagne l’inférence.
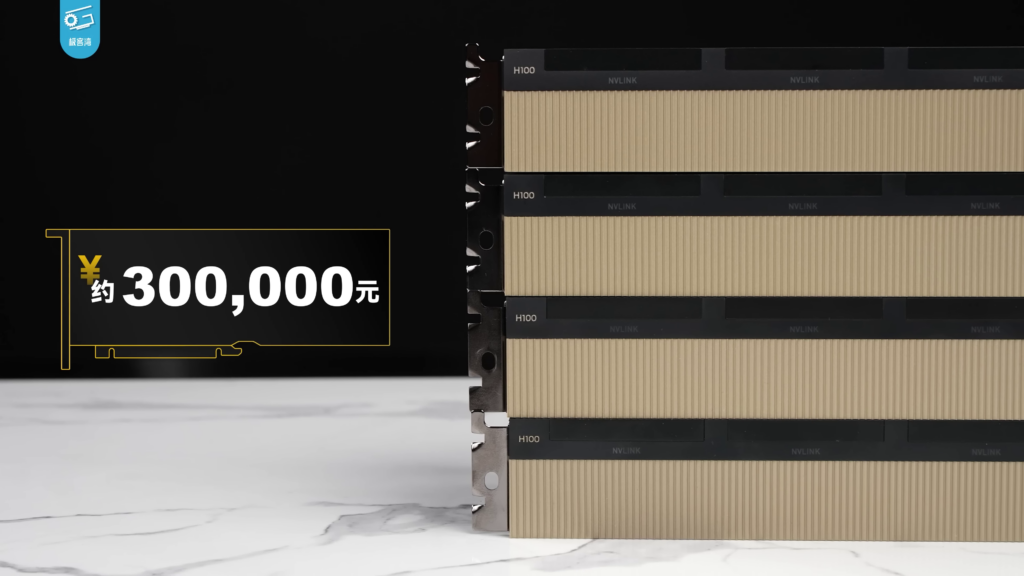
Les accélérateurs IA, c’était longtemps un seul mot : un GPU NVIDIA. Le terrain s’est peuplé. Les hyperscalers fabriquent leurs propres puces, AMD a décroché un client multi-gigawatts, et des start-up conçues uniquement pour l’inférence signent avec les plus grands labs. Ce guide cartographie qui construit quoi, où chaque famille de silicium se place entre entraînement et inférence, et pourquoi le débat GPU vs ASIC porte désormais sur le service de tokens plutôt que sur l’entraînement des modèles.
Pourquoi la carte des accélérateurs a changé
Pendant l’essentiel de l’ère deep learning, le marché des accélérateurs IA tournait sur un seul volant d’inertie. Les GPU NVIDIA, plus l’écosystème logiciel CUDA, étaient le défaut pour entraîner comme pour exécuter. Ce défaut tient encore dans bien des endroits. Ce qui a changé, c’est la forme de la demande. Labs de frontière et cloud providers font tourner des modèles pour d’énormes volumes d’utilisateurs, 24 h/24. Le coût de chaque token produit, et l’énergie que cette production consomme, est devenu un problème métier de premier ordre.
Les fournisseurs le disent sans détour. Google a présenté sa TPU de septième génération, Ironwood, comme « the first Google TPU for the age of inference » [3]. Microsoft a lancé Maia 200 comme « the AI accelerator built for inference », conçu « to dramatically improve the economics of AI token generation » [6]. Dans ses propres termes, la stratégie compute d’OpenAI vise « to build a resilient portfolio that matches the right systems to the right workloads » [11]. La formule right systems to the right workloads résume le marché 2026 : aucune puce n’a à tout gagner, et les acheteurs mélangent activement les fournisseurs.
L’acteurs en place : l’échelle NVIDIA
Toute carte des puces d’inférence IA et du silicium d’entraînement commence par NVIDIA, parce que personne d’autre n’opère à son échelle. Dans ses résultats du deuxième trimestre fiscal 2027, publiés le 26 août 2026, NVIDIA a annoncé un chiffre d’affaires total de 96,2 milliards de dollars, en hausse de 106 % en un an. Le Data Center a représenté 89,0 milliards, en hausse de 117 % [1]. Le commentaire du CFO déposé auprès de la SEC détaille davantage. Les clients hyperscale ont compté pour 48,7 milliards. La catégorie « AI Clouds, Industrial, & Enterprise » a représenté 40,3 milliards et a progressé de 138 % en un an [2]. Le commentaire attribue la croissance à « the ramp of our Blackwell Ultra infrastructure » [2].
Les annonces du même communiqué montrent comment NVIDIA défend sa position. La plateforme Vera Rubin « ramping into full production », avec des racks chez CoreWeave, Google Cloud, Microsoft Azure, Oracle Cloud Infrastructure et Nebius [1]. NVIDIA indique aussi que « NVIDIA Groq 3 LPX, the interactive AI inference accelerator, is now in full production » [1]. C’est notable : le plus grand vendeur de GPU au monde commercialise désormais une ligne fondée sur une technologie licenciée auprès d’une start-up ASIC d’inférence (voir plus bas).
La liste clients montre aussi comment les labs se couvrent. En novembre 2025, la société a annoncé un partenariat avec OpenAI pour déployer « at least 10 gigawatts of NVIDIA systems ». Elle a aussi indiqué que « for the first time, Anthropic will run and scale on NVIDIA infrastructure, initially adopting 1 gigawatt of compute capacity » [12]. Anthropic est aussi l’un des clients phares Trainium d’AWS [8][9]. Acheter chez plusieurs fournisseurs est devenu la norme.
L’autre GPU : la tête de pont multi-gigawatts d’AMD
AMD est la principale alternative GPU marchande. Sa percée date du 6 octobre 2025, quand AMD et OpenAI ont annoncé « a 6 gigawatt agreement to power OpenAI’s next-generation AI infrastructure across multiple generations of AMD Instinct GPUs ». Le premier déploiement d’un gigawatt de GPU Instinct MI450 doit commencer au second semestre 2026 [4]. AMD décrit une collaboration « began with the MI300X and continued with the MI350X series ». Elle a émis au profit d’OpenAI un warrant portant sur jusqu’à 160 millions d’actions AMD, qui se vest selon des jalons de déploiement et de cours [4]. Le CFO d’AMD a indiqué que le partenariat « expected to deliver tens of billions of dollars in revenue for AMD » [4].
Le point stratégique est limpide. Un acheteur de GPU qui veut du levier et de la sécurité d’approvisionnement dispose désormais d’une seconde source GPU programmable à l’échelle frontière. Sur la question GPU vs ASIC, AMD reste côté GPU : processeurs parallèles flexibles et généralistes, vendus à qui en veut, plutôt que des puces dessinées autour des charges de calcul d’une seule maison.
Les ASIC des hyperscalers
Les circuits intégrés spécifiques (ASIC) échangent de la généricité contre de l’efficacité sur un jeu de charges de calcul connus. Chacun des quatre plus grands acteurs cloud et plateforme a désormais sa propre lignée.
Google TPU : du cheval de trait d’entraînement au fleuron d’inférence
Google a le programme d’accélérateur sur mesure le plus ancien. La société indique que « for more than a decade, TPUs have powered Google’s most demanding AI training and serving workloads » [3]. Ironwood est la septième génération. La documentation Google Cloud liste le TPU7x (Ironwood) à 4 614 TFLOPs FP8 de crête par puce, 192 Gio de HBM à 7 380 Go/s par puce, et 9 216 puces par pod — contre 918 TFLOPs FP8 et 32 Gio pour la génération précédente v6e (Trillium) [5]. Google revendique aussi pour Ironwood une performance par watt 2× supérieure à Trillium [3].
Les détails comptent. Google commercialise Ironwood comme conçu pour l’inférence, mais sa documentation décrit la génération comme « designed for large-scale AI training and inference », y compris « pre-training, sampling and decode-heavy inference » [5]. Google a aussi travaillé la portabilité : un support TPU renforcé dans vLLM permet aux développeurs de « switch between GPUs and TPUs, or run both, with only a few minor configuration changes » [13]. Le lock-in logiciel a longtemps été la meilleure défense du GPU ; baisser le coût de bascule compte autant que les FLOPs bruts.
AWS Trainium (et la lignée Inferentia)
La lignée Amazon porte un nom d’entraînement, mais AWS la vend désormais pour les deux usages. Lors de re:Invent 2024, AWS a indiqué que les instances Trn2 « offer 30-40% better price performance than the current generation of GPU-based EC2 P5e and P5en instances » [7]. Elle a aussi annoncé Project Rainier avec Anthropic [7]. Amazon a ensuite déclaré Project Rainier « fully operational » avec « nearly half a million Trainium2 chips », et que Claude devait tourner sur « more than 1 million Trainium2 chips — for workloads including training and inference — by the end of the year » [8].
La génération suivante, Trainium3, est la première puce IA 3 nm d’AWS. Amazon indique que les Trn3 UltraServers montent jusqu’à 144 puces et délivrent « up to 362 FP8 PFLOPs ». Elle revendique jusqu’à 4,4× la performance compute et 4× l’efficacité énergétique des UltraServers Trainium2, et précise que « Amazon Bedrock is already serving production workloads on Trainium3 » [9]. Le nom dit entraînement ; l’argumentaire couvre clairement l’inférence aussi.
Microsoft Maia 200 : conçu pour les tokens
Maia 200, annoncé le 26 janvier 2026, est l’exemple le plus net d’une puce hyperscaler pensée pour l’inférence. Microsoft la dit construite sur le nœud 3 nm de TSMC avec cœurs tenseurs natifs FP8/FP4, « 216GB HBM3e at 7 TB/s and 272MB of on-chip SRAM ». Elle délivre « over 10 petaFLOPS in 4-bit precision (FP4) and over 5 petaFLOPS of 8-bit (FP8) performance, all within a 750W SoC TDP envelope » [6]. Microsoft revendique 30 % de meilleure performance par dollar que le matériel le plus récent de sa flotte. Maia 200 doit servir des modèles dont GPT-5.2 d’OpenAI pour Microsoft Foundry et Microsoft 365 Copilot [6].
Deux choix de design trahissent l’accent inférence. Le premier : le large SRAM on-die, qui garde les données près du calcul quand le décodage est limité par la bande passante mémoire. Le second : le réseau. Microsoft indique que Maia 200 utilise « a novel, two-tier scale-up network design built on standard Ethernet », avec des clusters jusqu’à 6 144 accélérateurs, « without relying on proprietary fabrics » [6]. C’est l’opposé direct des racks GPU basés sur NVLink.
Meta MTIA : quatre générations tournées vers le serving
Le programme MTIA de Meta a commencé par l’inférence de recommandation. En 2023, Meta écrivait que « GPUs were not always optimal for running Meta’s specific recommendation workloads at the levels of efficiency required at our scale » [14]. En mars 2026, Meta a indiqué avoir « deployed hundreds of thousands of MTIA chips in production », développés « in close partnership with Broadcom » [10]. La feuille de route dit où Meta place le goulot. Meta affirme que « the bandwidth of high-bandwidth memory (HBM) is the most important factor affecting GenAI inference performance ». Elle a doublé la bande HBM de MTIA 400 à MTIA 450, avec déploiement de masse prévu début 2027, puis ajouté encore 50 % pour MTIA 500, annoncé pour 2027 [10]. Meta insiste aussi rester « committed to a diverse silicon portfolio » : MTIA complète les GPU, elle ne les remplace pas [10].
Les spécialistes de l’inférence : Groq et Cerebras
Les start-up montrent le plus clairement à quel point l’inférence rapide est devenue précieuse.
Groq a conçu son architecture LPU pour l’inférence à faible latence. Le 24 décembre 2025, Groq a annoncé « a non-exclusive licensing agreement with Nvidia for Groq’s inference technology ». Dans le cadre de l’accord, le fondateur Jonathan Ross, le président Sunny Madra et d’autres membres de l’équipe ont rejoint NVIDIA, tandis que Groq reste une société indépendante et que GroqCloud continue d’opérer [15]. NVIDIA liste désormais un accélérateur d’inférence « NVIDIA Groq 3 LPX » en production pleine [1]. L’acteurs en place a choisi de licencier la techno d’un spécialiste plutôt que de la reconstruire de zéro.
Cerebras construit des processeurs à l’échelle du wafer. OpenAI a annoncé le 14 janvier 2026 un partenariat avec Cerebras « to add 750MW of ultra low-latency AI compute to our platform », avec une capacité qui arrive « in multiple tranches through 2028 » [11]. OpenAI indique que la vitesse de Cerebras « comes from putting massive compute, memory, and bandwidth together on a single giant chip », et présente l’accord comme l’ajout d’« a dedicated low-latency inference solution » à son mix [11]. La presse (Reuters, citant le Wall Street Journal) évoque environ 10 milliards de dollars [16] ; l’annonce d’OpenAI ne donne pas de montant [11].
GPU vs ASIC : entraînement vs inférence, côte à côte
| Acteur | Type | Rôle primaire aujourd’hui (selon le fournisseur) | Faits publics notables |
|---|---|---|---|
| NVIDIA (Blackwell Ultra, Vera Rubin) | GPU marchand | Entraînement et inférence | 89,0 Md$ de CA Data Center au T2 FY27 [1] |
| AMD Instinct (MI350X → MI450) | GPU marchand | Entraînement et inférence | Accord 6 GW avec OpenAI, premier GW au S2 2026 [4] |
| Google TPU7x (Ironwood) | ASIC hyperscaler | Inférence d’abord, aussi entraînement | 9 216 puces par pod ; 192 Gio HBM par puce [5] |
| AWS Trainium2 / Trainium3 | ASIC hyperscaler | Entraînement et inférence | Trn3 UltraServer : 144 puces, jusqu’à 362 PFLOPs FP8 [9] |
| Microsoft Maia 200 | ASIC hyperscaler | Inférence | 216 Go HBM3e, >10 PFLOPS FP4, 750 W [6] |
| Meta MTIA (300–500) | ASIC interne | Entraînement/inférence recommandation, inférence GenAI | Des centaines de milliers déployées [10] |
| Groq (techno LPU) | ASIC inférence | Inférence faible latence | Licence non exclusive à NVIDIA [15] |
| Cerebras (wafer-scale) | Systèmes orientés inférence | Inférence faible latence | Accord 750 MW OpenAI jusqu’en 2028 [11] |
Un schéma se détache. L’entraînement à la frontière reste dominé par de grands clusters étroitement couplés. Les GPU marchands mènent, avec les TPU Google et le Trainium AWS comme principales alternatives propriétaires. L’inférence est le terrain où la spécialisation se répand. Microsoft et Meta ont bâti des puces avec l’inférence comme cible principale. Google a donné à Ironwood une identité inference-first. Deux start-up au argumentaire 100 % inférence ont décroché des accords majeurs en quelques semaines.
Dynamiques de marché : ce qui décide qui gagne l’inférence
Plutôt que de parier sur un vainqueur unique, mieux vaut regarder les leviers que les fournisseurs eux-mêmes mettent en avant.
1. La bande passante mémoire plutôt que les FLOPs de crête. Meta le dit clairement pour l’inférence GenAI [10]. Le design Maia de Microsoft combine large SRAM on-die et HBM3e [6]. L’argumentaire Cerebras repose sur mémoire et compute sur un même wafer [11]. Produire des tokens un à un est en général limité par la vitesse de déplacement des poids et du cache KV : les puces se dessinent désormais autour du mouvement de données.
2. Performance par dollar et par watt. Presque chaque annonce de silicium sur mesure ouvre sur l’économie plutôt que sur la vitesse brute. Exemples : le gain revendiqué de 30 % de performance par dollar chez Microsoft [6], les 30–40 % de meilleur rapport qualité-prix Trn2 vs instances GPU chez AWS [7], le 2× performance par watt Ironwood vs Trillium chez Google [3]. Ce sont des affirmations de fournisseurs, pas des benchmarks indépendants. Ils disent toutefois ce que les acheteurs demandent.
3. La puissance comme unité d’achat. Les deals se dimensionnent désormais en gigawatts et mégawatts plutôt qu’en nombre de puces : 10 GW pour NVIDIA–OpenAI [12], 6 GW pour AMD–OpenAI [4], 750 MW pour Cerebras–OpenAI [11], et 1 GW pour l’engagement NVIDIA initial d’Anthropic [12]. Quand la puissance disponible est la contrainte liante, l’efficacité par watt décide directement de la capacité qu’un acheteur peut réellement servir.
4. Portabilité logicielle. Le fossé CUDA est réel, mais le camp ASIC le cible. Google pousse le support vLLM GPU et TPU [13]. Microsoft livre un SDK Maia avec intégration PyTorch et compilateur Triton pour « easy model porting across heterogeneous hardware accelerators » [6]. Meta intègre MTIA directement dans PyTorch [14]. Plus il est facile de déplacer un modèle, moins il coûte de choisir un ASIC.
5. Réseau scale-up. Les grands modèles se servent désormais sur des racks, pas sur une seule puce. NVIDIA vend des plateformes rack intégrées comme Vera Rubin [1]. Microsoft mise sur le scale-up Ethernet [6]. Google s’appuie sur son Inter-Chip Interconnect à travers des pods de 9 216 puces [3]. Le MTIA 400 de Meta propose « a 72-accelerator scale-up domain » [10]. L’interconnexion fait de plus en plus partie du produit.
Alors, qui gagne l’inférence ?
Sur les preuves disponibles aujourd’hui, la réponse honnête est que l’inférence devient un marché de portefeuille plutôt qu’un marché à vainqueur unique. NVIDIA reste de loin le plus grand fournisseur en chiffre d’affaires [1], et a absorbé de la techno spécialiste via la licence Groq [1][15]. Les hyperscalers basculent une part croissante de leur serving sur du silicium maison, surtout là où ils contrôlent à la fois le modèle et la plateforme : Microsoft avec Copilot et Foundry [6], Meta avec recommandations et GenAI [10], Google sur ses services et Cloud [3], AWS avec Bedrock [9]. Les labs de frontière se couvrent sur tous. OpenAI seule a des accords publics avec NVIDIA, AMD et Cerebras [12][4][11], et Anthropic tourne à la fois sur Trainium et sur NVIDIA [8][12].
Pour qui suit les accélérateurs IA, la leçon pratique est de regarder les économies par token et par watt que chaque fournisseur publie. Il faut les lire comme des affirmations, les comparer aux benchmarks indépendants dès qu’ils sortent, et suivre où les grands labs placent leur prochain gigawatt. C’est là que se décidera l’arbitrage GPU contre ASIC.
À lire aussi
- Entraînement multi-trillions de paramètres : ce que la prochaine génération de silicium doit livrer
- Course aux capex : cartographier les dépenses IA des hyperscalers et ce qu’elles achètent
- InfiniBand vs Ethernet pour les clusters IA : la guerre des fabrics dans l’usine d’IA
< !– Schema.org NewsArticle (CF_SEO) — image paths relative to draft ; replace with absolute CDN URLs at publish –>
Références / Sources
- NVIDIA — « NVIDIA Announces Financial Results for Second Quarter Fiscal 2027 » (Aug 26, 2026). https://investor.nvidia.com/news/press-release-details/2026/NVIDIA-Announces-Financial-Results-for-Second-Quarter-Fiscal-2027/default.aspx
- NVIDIA — CFO Commentary, Q2 FY27 (SEC filing). https://www.sec.gov/Archives/edgar/data/1045810/000104581026000073/q2fy27cfocommentary.htm
- Google — « Ironwood: The first Google TPU for the age of inference. » https://blog.google/innovation-and-ai/infrastructure-and-cloud/google-cloud/ironwood-tpu-age-of-inference/
- AMD — « AMD and OpenAI Announce Strategic Partnership to Deploy 6 Gigawatts of AMD GPUs » (Oct 6, 2025). https://ir.amd.com/news-events/press-releases/detail/1260/amd-and-openai-announce-strategic-partnership-to-deploy-6-gigawatts-of-amd-gpus
- Google Cloud Documentation — « TPU7x (Ironwood). » https://docs.cloud.google.com/tpu/docs/tpu7x
- Microsoft — « Maia 200: The AI accelerator built for inference » (Jan 26, 2026). https://blogs.microsoft.com/blog/2026/01/26/maia-200-the-ai-accelerator-built-for-inference/
- Amazon — « AWS Trainium2 Instances Now Generally Available » (Dec 2024). https://press.aboutamazon.com/2024/12/aws-trainium2-instances-now-generally-available
- Amazon — « AWS’s Project Rainier. » https://www.aboutamazon.com/news/aws/aws-project-rainier-ai-trainium-chips-compute-cluster
- Amazon — « Trainium3 UltraServers now available. » https://www.aboutamazon.com/news/aws/trainium-3-ultraserver-faster-ai-training-lower-cost
- Meta — « Four MTIA Chips in Two Years: Scaling AI Experiences for Billions » (Mar 11, 2026). https://ai.meta.com/blog/meta-mtia-scale-ai-chips-for-billions/
- OpenAI — « OpenAI partners with Cerebras » (Jan 14, 2026). https://openai.com/index/cerebras-partnership/
- NVIDIA — « NVIDIA Announces Financial Results for Third Quarter Fiscal 2026 » (Nov 19, 2025). https://investor.nvidia.com/news/press-release-details/2025/NVIDIA-Announces-Financial-Results-for-Third-Quarter-Fiscal-2026/default.aspx
- Google Cloud Blog — « Ironwood TPUs and new Axion-based VMs for your AI workloads. » https://cloud.google.com/blog/products/compute/ironwood-tpus-and-new-axion-based-vms-for-your-ai-workloads
- Meta — « MTIA v1: Meta’s first-generation AI inference accelerator » (May 18, 2023). https://ai.meta.com/blog/meta-training-inference-accelerator-AI-MTIA/
- Groq — « Groq and Nvidia Enter Non-Exclusive Inference Technology Licensing Agreement » (Dec 24, 2025). https://groq.com/newsroom/groq-and-nvidia-enter-non-exclusive-inference-technology-licensing-agreement-to-accelerate-ai-inference-at-global-scale
- Reuters — « OpenAI signs $10 billion computing deal with Nvidia challenger Cerebras » (Jan 14, 2026). https://www.reuters.com/technology/openai-buy-compute-capacity-startup-cerebras-around-10-billion-wsj-reports-2026-01-14/
Images : illustrations générées pour AndBeyond.Tech, à l’exception de : Accélérateur NVIDIA H100 — 极客湾Geekerwan, Wikimedia Commons, CC BY 3.0 ; Carte Google Tensor Processing Unit 3.0 — Zinskauf, Wikimedia Commons, CC BY-SA 4.0.