Microsoft Fairwater et l’essor de la superusine d’IA distribuée
Comment Microsoft Fairwater relie le Wisconsin et Atlanta en une seule superusine d’IA : refroidissement liquide, réseau WAN IA et bascule multi-campus.
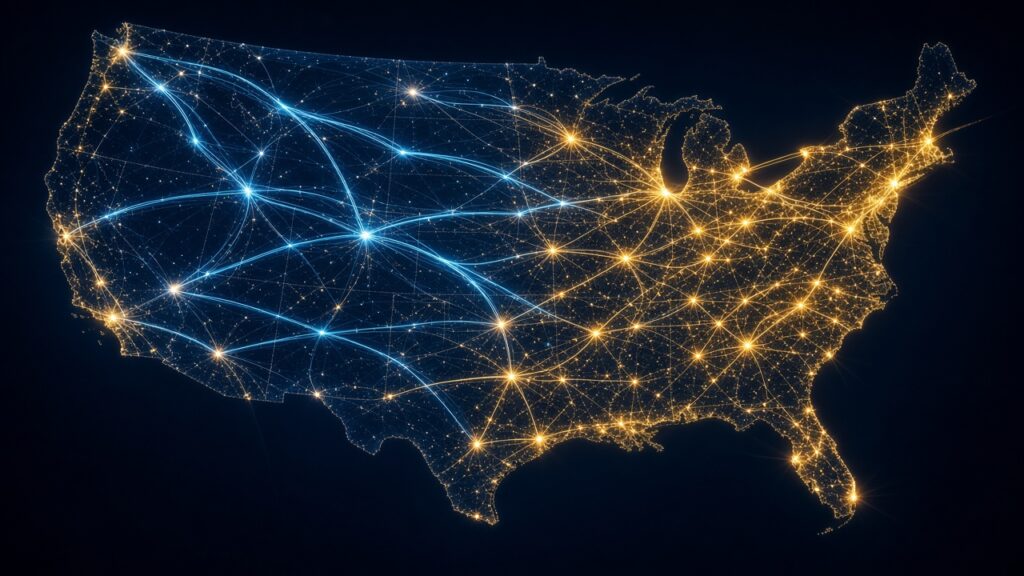
Pendant l’essentiel de l’ère cloud, le data center était l’unité qui comptait. On construisait un bâtiment, on le remplissait de serveurs, on le branchait à Internet, et de nombreuses charges clients sans lien entre elles partageaient l’espace. L’IA de frontière a brisé ce modèle une première fois, quand les clusters d’entraînement sont devenus des machines uniques de la taille d’un bâtiment. Aujourd’hui, elle le brise à nouveau. Avec Fairwater, Microsoft parie que la prochaine unité de calcul n’est ni un bâtiment, ni même un campus, mais un réseau de campus séparés de centaines de kilomètres qui se comportent comme une seule machine. Microsoft appelle cela une superusine d’IA.
Cet article examine ce qu’est réellement Fairwater, en quoi un data center IA distribué diffère d’un seul campus géant, ce qu’il faut pour interconnecter des GPU d’un État à l’autre, et pourquoi le vrai moteur pourrait être l’électricité davantage que le silicium.
Ce qu’est Fairwater
Microsoft a dévoilé Fairwater en septembre 2025 avec un site à Mount Pleasant, dans le Wisconsin. Dans un billet du Official Microsoft Blog, Scott Guthrie, Executive Vice President of Cloud + AI, l’a présenté comme l’usine d’IA la plus vaste et la plus sophistiquée construite jusqu’ici par l’entreprise. Il a aussi indiqué que plusieurs data centers Fairwater identiques étaient en construction ailleurs aux États-Unis.
Le campus du Wisconsin est imposant même aux standards hyperscale. Microsoft indique qu’il couvre 315 acres, avec trois bâtiments totalisant 1,2 million de pieds carrés sous toiture. Sa construction a requis 46,6 miles de pieux de fondation profonde, 26,5 millions de livres d’acier de structure, 120 miles de câble souterrain moyenne tension et 72,6 miles de tuyauterie mécanique. Microsoft affirme que le site fait tourner un cluster unique de serveurs NVIDIA GB200 interconnectés sur un réseau plat unique couvrant des centaines de milliers de GPU. L’entreprise affirme aussi qu’il offrira dix fois les performances du supercalculateur le plus rapide d’aujourd’hui. C’est la comparaison de Microsoft, sans méthodologie de benchmark dans le billet.
Deux mois plus tard, en novembre 2025, Microsoft a annoncé le second site Fairwater, à Atlanta, en Géorgie. Le billet de Guthrie sur l’architecture indique qu’Atlanta se connecte au Wisconsin, aux générations antérieures de supercalculateurs IA Microsoft, et à l’empreinte Azure plus large, formant ce que l’entreprise appelle « la première superusine d’IA à l’échelle planétaire ». Un dossier compagnon sur la newsroom Source de Microsoft dit, selon l’extrait publié, que le site d’Atlanta a démarré en octobre 2025. Il partage l’architecture du Wisconsin, et d’autres sites Fairwater en construction rejoindront le même réseau au fil du temps.
Microsoft a aussi rattaché Fairwater à son déploiement IA à l’étranger. Le billet de septembre mentionnait un data center IA hyperscale prévu à Narvik, en Norvège, avec nScale et Aker JV, et un partenariat avec nScale à Loughton, au Royaume-Uni, pour bâtir ce que Microsoft appelait le plus grand supercalculateur du Royaume-Uni. Microsoft indique que ces sites utiliseront des clusters similaires basés sur les GB300 de NVIDIA. Ils ne portent pas la marque Fairwater dans ce billet, mais ils appartiennent à la même histoire : une capacité IA dédiée conçue pour se brancher sur un réseau mondial de plus de 400 data centers dans 70 régions.
Objectifs de conception : densité, refroidissement et salle à deux niveaux
L’ingénierie de Fairwater part d’une contrainte. Dans les mots de Guthrie, la vitesse de la lumière est devenue un goulot d’étranglement majeur. Quand des dizaines de milliers d’accélérateurs doivent échanger des gradients plusieurs fois par seconde, chaque mètre de câble ajoute de la latence. La première règle de conception est donc la densité : mettre autant de calcul que possible aussi près que possible.
Cela se traduit de trois façons.
Accélérateurs à l’échelle du rack. Chaque rack Fairwater accueille jusqu’à 72 GPU NVIDIA Blackwell dans un seul domaine NVLink. Microsoft cite 1,8 To de bande passante GPU à GPU par rack et plus de 14 To de mémoire mutualisée disponible pour chaque GPU. L’entreprise affirme qu’un rack GB200 peut traiter 865 000 tokens par seconde, ce qu’elle présente comme le plus haut débit de toute plateforme cloud. C’est une affirmation fabricant.
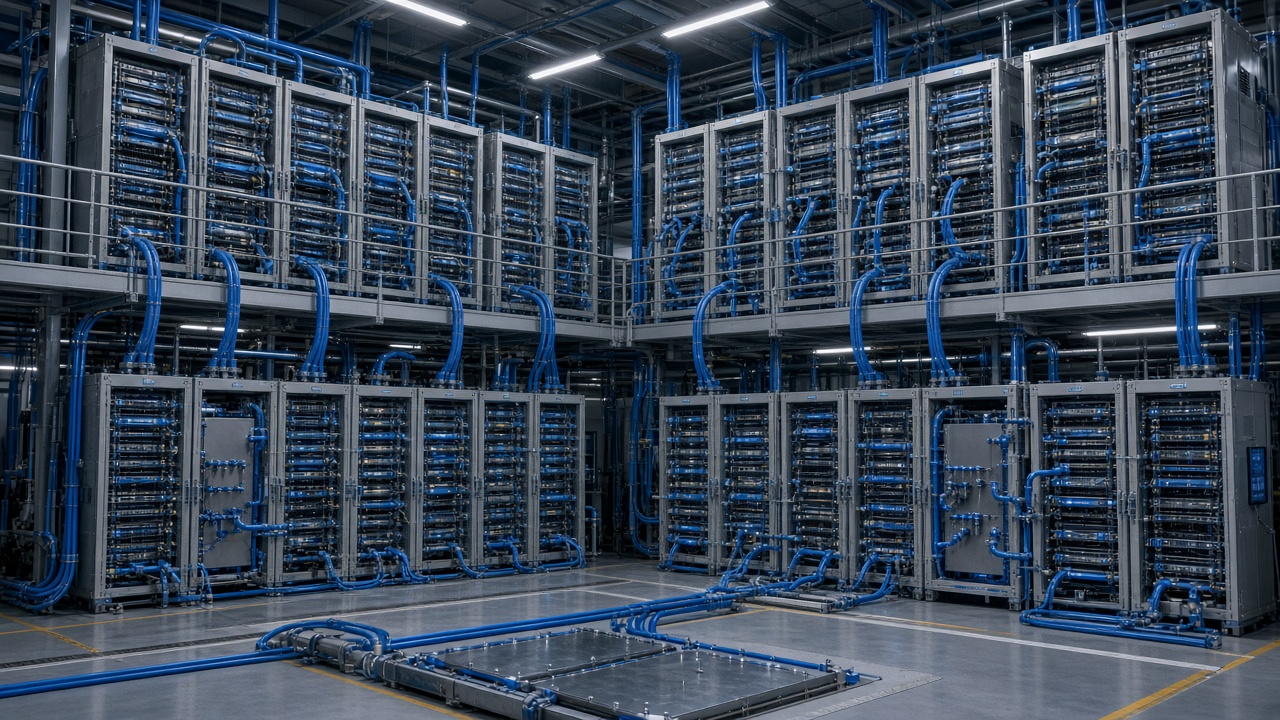
Refroidissement liquide à l’échelle de l’installation. Le refroidissement à air ne peut pas évacuer la chaleur à ces densités. Fairwater utilise un refroidissement liquide en boucle fermée qui amène le fluide jusqu’aux plaques froides des serveurs. Selon Microsoft, le liquide est réutilisé en continu après le premier remplissage, sans évaporation. Ce premier remplissage équivaut à peu près à la consommation annuelle de 20 foyers, et le système est conçu pour durer six ans ou plus avant qu’une éventuelle reprise de la chimie de l’eau ne soit nécessaire. Le billet Wisconsin décrit le site comme adossé à la deuxième plus grande centrale de chillers à eau du monde, avec 172 ventilateurs de vingt pieds sur les « ailettes » de refroidissement de chaque côté des bâtiments. Le refroidissement liquide permet à Microsoft de pousser la puissance par rack à environ 140 kW, et la puissance par rangée à 1 360 kW.
Construire en trois dimensions. Les salles Fairwater font deux étages. Les racks se connectent aux voisins du dessus et du dessous autant qu’à ceux d’à côté, ce qui raccourcit les plus longs parcours de câble. Microsoft indique que cela améliore latence, bande passante, fiabilité et coût — un rappel que le plan du bâtiment est devenu une décision réseau.
Les salles de calcul ne sont qu’une partie du tableau. Microsoft indique que le Wisconsin s’appuie aussi sur un data center séparé de stockage et de calcul dont les systèmes de stockage font « cinq terrains de football de long ». L’entreprise affirme aussi avoir réingénié Azure Blob Storage pour que chaque compte puisse soutenir plus de deux millions de transactions lecture/écriture par seconde. Un run d’entraînement de frontière est autant un problème de logistique de données qu’un problème de FLOPS.
Superusine vs. méga-campus unique
Une stratégie mono-campus est simple : trouver un site avec assez de terrain, d’eau et, surtout, de puissance, puis bâtir le plus grand cluster cohérent possible. Le modèle a des forces claires. La latence entre deux GPU quelconques est bornée par la taille du bâtiment, l’entraînement synchrone est bien compris, et les opérations sont concentrées.
Sa faiblesse : puissance, foncier et interconnexion au réseau ne s’échelonnent pas en douceur. Le billet de novembre de Guthrie le dit directement : la demande de calcul pour les grands jobs d’entraînement, désormais mesurée en milliers de milliards de paramètres, « dépasse rapidement les contraintes de puissance et d’espace d’une seule installation ».
Fairwater conserve l’idée mono-campus à l’intérieur de chaque site. Chaque data center Fairwater fait tourner un cluster cohérent. La superusine ajoute ensuite une couche au-dessus. Microsoft décrit trois niveaux de réseau :
- Scale-up à l’intérieur du rack (NVLink, 72 GPU).
- Scale-out à travers le site, sur un réseau back-end plat couvrant des centaines de milliers de GPU.
- Inter-sites, via un WAN IA dédié reliant les campus Fairwater et les supercalculateurs plus anciens.
Le changement important est que les charges peuvent être placées sur le niveau qui leur convient. Microsoft souligne que « l’entraînement » n’est plus un job monolithique. Il couvre désormais le pré-entraînement, le fine-tuning, l’apprentissage par renforcement, l’évaluation et la génération de données synthétiques, chacun avec des motifs de communication différents. Auparavant, écrit Guthrie, tout le trafic devait emprunter le réseau scale-out, quel que soit le besoin. Dans une superusine, un job tensor-parallel sensible à la latence reste dans un rack, un grand pré-entraînement data-parallel peut s’étendre sur un site, et des jobs plus lâchement couplés comme la génération de données synthétiques ou les rollouts RL peuvent tourner ailleurs. Microsoft appelle l’objectif fungibility : garder les GPU occupés sur l’ensemble du système, pas seulement dans un bâtiment.
C’est ce qui distingue un vrai data center IA distribué d’un ensemble de grands data centers qui partagent seulement un propriétaire. Les sites sont conçus pour être planifiés comme un seul pool.
Réseaux de clusters entre sites
À l’intérieur du site : Ethernet à échelle extrême
Les descriptions Microsoft du fabric intra-site ont évolué d’un billet à l’autre, et ce changement compte. Le billet Wisconsin de septembre indique qu’Azure utilise à la fois InfiniBand et Ethernet à 800 Gbit/s en fat-tree non bloquant pour connecter les racks en pods. Le billet superusine de novembre, centré sur l’architecture Fairwater, décrit un réseau back-end Ethernet à deux niveaux avec une connectivité GPU à GPU de 800 Gbit/s. Il tourne sur SONiC, le système d’exploitation réseau open de Microsoft, sur des commutateurs commodity. Microsoft présente cela comme un moyen d’éviter le lock-in fabricant et de maîtriser les coûts, et affirme que le design dépasse « les limites traditionnelles des réseaux Clos » avec les commutateurs de génération actuelle.
Pour faire se comporter Ethernet à cette échelle, Microsoft cite le packet trimming, le packet spraying, la télémétrie haute fréquence et un contrôle plus fin des routes. Ensemble, ces mécanismes apportent contrôle de congestion, détection rapide des pertes et retransmission, et équilibrage de charge adaptatif. Ce sont les mêmes problèmes que visent les efforts Ultra Ethernet de l’industrie. Fairwater montre un hyperscaler qui parie qu’une pile Ethernet ouverte peut porter l’entraînement de frontière sans fabrics propriétaires.
Entre les sites : le WAN IA
La couche inter-sites est la partie nouvelle. Microsoft indique avoir bâti un réseau optique WAN IA dédié pour étendre les réseaux scale-up et scale-out de Fairwater entre régions. Elle affirme aussi avoir déployé plus de 120 000 miles de fibre nouvelle aux États-Unis dans l’année précédant le billet de novembre 2025. Le dossier Source décrit le WAN IA, selon son extrait, comme permettant aux données de circuler entre sites séparés de plusieurs États avec un minimum de goulots, afin que plusieurs sites coopèrent sur un entraînement quasi temps réel. Le même texte indique que le design distribué cible des modèles de centaines de milliers de milliards de paramètres et pourrait réduire certains jobs d’entraînement de plusieurs mois à quelques semaines. Les deux sont des projections Microsoft.
Sur la bande passante, les notes publiques de l’ingénieur HPC Glenn K. Lockwood sur l’entraînement multi-clusters citent Guthrie indiquant que le WAN IA supporte jusqu’à 400 térabits de bande passante réseau. Ce chiffre est rapporté via cette source secondaire ; la transcription originale n’a pas été localisée pour ce brouillon.
Le problème de physique
Microsoft n’a pas publié de chiffres de latence pour la liaison Wisconsin–Atlanta. Les arbitrages sont clairs en principe. La lumière dans la fibre couvre environ un kilomètre toutes les cinq microsecondes : des sites séparés de centaines de kilomètres ajoutent des délais aller-retour mesurés en millisecondes. Dans un rack ou une salle, les délais se mesurent en microsecondes. Un briefing secondaire du 311 Institute, citant The Register, situe la distance entre Mount Pleasant et Atlanta à environ 1 000 km, selon ce reportage.
Cet écart façonne ce qui peut tourner entre sites. Des opérations étroitement synchrones comme le parallélisme de tenseurs ne tolèrent pas la latence WAN et doivent rester dans un site. Le parallélisme de données est plus indulgent, surtout avec une réduction hiérarchique des gradients, un chevauchement communication/calcul, ou une synchronisation moins fréquente. C’est le motif de « hiérarchie de fabrics » décrit par Lockwood : la communication intra-site est rapide et dense, la communication inter-sites est plus lente et doit être utilisée avec parcimonie, et les logiciels d’entraînement doivent être construits autour de cette asymétrie. La superusine ne fonctionne que si les ordonnanceurs et frameworks respectent ces frontières.
L’angle énergie et systèmes électriques
Microsoft ne le formule pas ainsi, mais l’argument le plus fort pour la distribution pourrait être électrique. Le même briefing du 311 Institute résume, selon le reportage, qu’un seul site peine à obtenir assez de puissance pour les plus grands runs d’entraînement. Il indique aussi que l’argument Microsoft est que relier des sites permet de choisir des lieux au foncier moins cher, aux climats plus frais et à la puissance abondante. La distribution transforme une demande d’interconnexion impossible en plusieurs demandes difficiles mais réalisables.
Le design électrique de Fairwater reflète cette logique. Pour Atlanta, Microsoft dit avoir choisi le site pour une alimentation utilitaire résiliente capable de délivrer « une disponibilité 4×9 au coût 3×9 ». Parce que l’alimentation réseau est si fiable, Microsoft affirme pouvoir abandonner les couches de résilience traditionnelles pour la flotte GPU : pas de production sur site, pas d’UPS, pas de distribution bi-câblée. C’est un écart notable par rapport à la pratique classique des data centers. Cela montre aussi comment le choix de site devient une décision d’ingénierie électrique une fois que le calcul peut vivre n’importe où sur le WAN. Une autre implication suit : si un site a un problème, une partie de la résilience peut venir du réseau de sites plutôt que de générateurs diesel dans la cour. Microsoft ne le dit pas explicitement, mais Thomas Kurian de Google a formulé le même point sur l’entraînement multi-sites, comme évoqué plus bas.
Un second enjeu électrique est moins évident : l’oscillation de charge. Les grands jobs d’entraînement synchrones tirent la puissance par vagues, quand des milliers de GPU passent ensemble entre phases de calcul et de communication. À des centaines de mégawatts, ces à-coups peuvent devenir un problème de stabilité pour le réseau. Microsoft indique avoir co-développé trois mitigations avec des partenaires :
- une approche logicielle qui lance des charges complémentaires pendant les périodes de faible activité pour lisser la demande ;
- une approche matérielle dans laquelle les GPU appliquent leurs propres seuils de puissance ; et
- du stockage d’énergie sur site pour absorber les fluctuations sans gaspiller de puissance supplémentaire.
La distribution aide aussi ici. Les à-coups d’un job de 2 GW sont bien plus faciles à gérer pour un utilitaire quand ils sont répartis sur plusieurs réseaux. Le coût, c’est la complexité : chaque site doit encore gérer son propre profil de puissance, et le WAN devient une dépendance critique.
L’eau est le troisième volet du tableau énergétique. Microsoft affirme que plus de 90 % de sa capacité de data centers utilise le système en boucle fermée, et que les serveurs traditionnels restants utilisent l’air extérieur, ne passant à l’eau que les jours les plus chauds. Les communautés proches des campus hyperscale demandent d’abord de l’eau et de l’électricité, et le message Fairwater met les deux en avant.
Contexte sectoriel : tout le monde passe au multi-sites
Microsoft marque la superusine d’IA, mais elle n’a pas inventé l’entraînement multi-sites.
Google est arrivé tôt. Dans une interview Data Center Dynamics, selon l’extrait publié, le CEO de Google Cloud Thomas Kurian a indiqué que Gemini Ultra avait été entraîné « sur plusieurs sites, et plusieurs clusters à l’intérieur de ces sites ». Il a expliqué que la distribution apporte de la résilience si un lieu a des problèmes d’alimentation et permet un cluster global plus grand face aux limites d’espace et de puissance. DCD note que Google relie des TPU SuperPods de 4 096 puces via des réseaux intra- et inter-clusters, en utilisant le parallélisme de modèle dans un SuperPod et le parallélisme de données entre SuperPods. C’est la même hiérarchie que Fairwater formalise.
OpenAI a, selon Lockwood et le 311 Institute, confirmé l’entraînement de GPT-4.5 sur plusieurs clusters. NVIDIA a annoncé Spectrum-XGS Ethernet en août 2025 pour connecter des data centers entre villes et continents en ce qu’elle appelle de géantes usines d’IA, avec CoreWeave parmi les premiers adopteurs, selon les reportages. Cisco et Broadcom auraient publié des routeurs conçus pour relier des data centers IA jusqu’à environ 1 000 km, selon The Register via le briefing 311. Ces affirmations fabricants n’ont pas été confrontées aux pages primaires NVIDIA, Cisco ou Broadcom pour ce brouillon.
Pris ensemble, cela dessine une direction claire. L’industrie bâtit le matériel, les protocoles et les logiciels pour des runs d’entraînement qui traversent les régions, et le WAN IA de Microsoft en est l’exemple le plus visible à ce jour.
État 2026 : du plan au campus vivant
Les reportages métier et locaux de 2026 ont complété la chronologie laissée ouverte par les blogs Microsoft de 2025. Selon MLQ News et Inside the Datacenter, Microsoft a déclaré le premier bâtiment Fairwater de Mount Pleasant pleinement opérationnel le 23 juin 2026, après environ deux ans de construction qui ont employé près de 10 000 personnes au pic. Ces comptes situent le campus sur l’ancien site Foxconn du comté de Racine et décrivent une seconde installation adjacente visée pour 2028, avec des approbations locales plus tôt en 2026 pour une expansion multi-bâtiments bien plus vaste.
Le dossier blueprint Fairwater de Data Center Frontier (mis à jour après dépôt) a rapporté un investissement Wisconsin d’environ 7,3 milliards de dollars dans des filings d’État examinés via Data Center Dynamics, avec une demande de pointe de Phase 1 près de 400 MW et un déploiement complet approchant environ 900 MW — des chiffres qui restent secondaires aux affirmations du blog Microsoft et doivent être traités comme rapportés, non comme des divulgations Microsoft auditées. Le même texte note des mises à niveau réseau prépayées, de la production au gaz temporaire pour la fiabilité initiale, et des programmes communautaires comme une Datacenter Academy avec Gateway Technical College.
Par ailleurs, Bloomberg a rapporté en septembre 2026 que Microsoft prévoit de faire passer sa capacité mondiale de data centers d’environ 12 GW à plus de 38 GW d’ici 2032, citant des personnes familières des plans ; Reuters a relayé le chiffre le même jour et indiqué que Microsoft n’avait pas commenté. Cette feuille de route de capacité n’est pas spécifique à Fairwater, mais c’est le décor corporate dans lequel les superusines d’IA multi-campus ont du sens : Microsoft dimensionne une flotte, pas une seule salle.
Perspectives
Plusieurs questions diront si la superusine d’IA devient l’architecture par défaut ou reste une approche de niche pour les plus grands labs.
Jusqu’où les sites peuvent-ils se coupler ? Si l’entraînement inter-sites reste limité à des phases lâchement couplées, la superusine est surtout un gain d’utilisation et d’ordonnancement. Si de nouveaux algorithmes d’entraînement et équipements réseau réduisent le coût de la synchronisation sur 1 000 km, elle devient un vrai multiplicateur d’échelle.
Combien de sites rejoignent ? Microsoft a indiqué que d’autres sites Fairwater sont en construction aux États-Unis. Le 311 Institute liste l’arrivée de sites supplémentaires dans le cluster lié, au-delà du Wisconsin et d’Atlanta, comme un signal à surveiller. Chaque nouveau site teste si le modèle tient opérationnellement.
L’électricité restera-t-elle la contrainte liante ? Si la production sur site ou de grands nouveaux raccordements réseau rendent à nouveau faciles les campus d’un gigawatt uniques, une partie de l’argument pour la distribution s’affaiblit. Pour l’instant, les files d’interconnexion et les oppositions locales suggèrent le contraire.
Qui construit la fibre longue distance ? Les 120 000 miles de fibre nouvelle rapportés par Microsoft en un an suggèrent que des backbones optiques privés dédiés au trafic IA pourraient devenir aussi stratégiques que les allocations de GPU.
Le point plus large est que l’infrastructure IA de frontière devient un système distribué au sens informatique : partitionné, hiérarchique, conscient de la latence et ordonnancé comme un tout. Fairwater est la première tentative sérieuse de Microsoft de faire tourner un tel système à l’échelle continentale. Le data center n’est plus l’ordinateur. C’est le réseau de data centers qui l’est.
À lire aussi
- La course aux usines d’IA au Texas : pourquoi les hyperscalers misent des dizaines de milliards sur un seul État
- Comment les superusines d’IA distribuées étirent le réseau entre campus
- InfiniBand vs Ethernet pour les clusters IA
< !– Schema.org NewsArticle (CF_SEO / CF_Localization FR) — image paths relative to draft ; replace with absolute CDN URLs at publish –>
Références / sources
- Scott Guthrie, « Inside the world’s most powerful AI datacenter, » Official Microsoft Blog, 18 Sep 2025 — https://blogs.microsoft.com/blog/2025/09/18/inside-the-worlds-most-powerful-ai-datacenter/ (primary, fully read)
- Scott Guthrie, « Infinite scale: The architecture behind the Azure AI superfactory, » Official Microsoft Blog, 12 Nov 2025 — https://blogs.microsoft.com/blog/2025/11/12/infinite-scale-the-architecture-behind-the-azure-ai-superfactory/ (primary, fully read)
- « From Wisconsin to Atlanta: Microsoft connects datacenters to build its first AI superfactory, » Microsoft Source — https://news.microsoft.com/source/features/ai/from-wisconsin-to-atlanta-microsoft-connects-datacenters-to-build-its-first-ai-superfactory/ (primary; search extract only)
- « Training Google’s Gemini: TPUs, multiple data centers, and risks of cosmic rays, » Data Center Dynamics — https://www.datacenterdynamics.com/en/news/training-gemini-tpus-multiple-data-centers-and-risks-of-cosmic-rays/ (search extract)
- Glenn K. Lockwood, « Multicluster training » — https://glennklockwood.com/garden/multicluster-training (secondary; search extract)
- 311 Institute, « Multi-Site AI Training: 2026 trend briefing » — https://www.311institute.com/starburst-centre/trend/multi-site-ai-training/ (secondary tracker; search extract)
- David Chernicoff, « Inside Microsoft’s Global AI Infrastructure: The Fairwater Blueprint for Distributed Supercomputing, » Data Center Frontier, 9 Oct 2025 (with later updates) — https://www.datacenterfrontier.com/hyperscale/article/55317925/inside-microsofts-global-ai-infrastructure-the-fairwater-blueprint-for-distributed-supercomputing
- MLQ News, « Microsoft Brings First Mount Pleasant, Wisconsin Data Center Online at Former Foxconn Site » — https://mlq.ai/news/microsoft-brings-first-mount-pleasant-wisconsin-data-center-online-at-former-foxconn-site/ (secondary; search extract / 2026 ops claim)
- Inside the Datacenter, « Every Data Center in Wisconsin » — https://insidethedatacenter.com/articles/wisconsin-data-centers/ (secondary; Jun 2026 operational note)
- Bloomberg via Global Data Center Hub summary, « Microsoft Data Center Capacity Plan: 38 GW By 2032, » Sep 2026 — https://www.globaldatacenterhub.com/p/microsoft-data-center-capacity-38gw-2032 (Bloomberg/Reuters secondary; Microsoft did not confirm)
Images : illustrations originales créées pour AndBeyond.Tech ; aucun logo ni aucune personne réelle n’y figurent.