IA en el dispositivo en 2026: NPU, modelos locales y lo que aún necesita la nube
Así funciona la IA en el dispositivo en 2026: NPU de Qualcomm, Apple, Intel, AMD y MediaTek, LLM locales, límites de privacidad y lo que aún exige la nube.
Portada: móviles y PC ya integran silicio neuronal dedicado para una inferencia privada y de baja latencia.
Durante casi todo el auge de la IA generativa, «inteligente» significaba «conectado». Una petición salía del móvil, cruzaba un centro de datos y volvía convertida en texto o imagen. En 2026, ese patrón ya no es lo habitual en los asistentes del día a día. La IA en el dispositivo —la inferencia que se ejecuta en el propio móvil o PC— se ha convertido en una categoría de producto con su propio silicio, sus propias familias de modelos y su propio argumento de privacidad.
El cambio no ha borrado la nube. Los modelos multimodales punteros, los agentes de investigación de contexto largo y el entrenamiento pesado siguen viviendo en los centros de datos. Lo que ha cambiado es el reparto: una parte creciente de los resúmenes, las reescrituras, la traducción, los efectos de cámara y los agentes personales se ejecuta ya en local sobre hardware de NPU para IA, a menudo con un pequeño LLM local como cerebro. Este artículo traza el mapa de ese panorama: qué prometen realmente las NPU de los chips actuales de Qualcomm, Apple, Intel, AMD y MediaTek; qué cargas de trabajo encajan en un modelo local; y qué sigue necesitando la nube.
Por qué la IA en el dispositivo ha despegado
Tres presiones empujaron a los fabricantes en la misma dirección.
Latencia y fiabilidad. Las funciones que deben sentirse instantáneas —subtítulos en directo, filtros de cámara siempre activos, traducción sin conexión— no pueden depender de la cobertura. Una NPU (unidad de procesamiento neuronal) es un bloque especializado en cálculo matricial y tensorial. Junto con un modelo cuantizado que quepa en la memoria del dispositivo, puede responder sin ida y vuelta al servidor.
Privacidad y regulación. Usuarios y empresas prefieren cada vez más que los borradores, las fotos, el contexto del calendario y el audio del micrófono se queden en el dispositivo. Los proveedores de plataformas ya lo venden de forma explícita: las directrices de Microsoft para los PC Copilot+ sitúan una NPU de alto rendimiento en el centro de las funciones de IA de Windows; la pila Apple Intelligence de Apple se apoya en el Neural Engine y aceleradores relacionados para sus herramientas en el dispositivo.
Consumo. Ejecutar cada petición en la nube castiga la radio y la batería. Una NPU que los fabricantes cifran en decenas de TOPS (billones de operaciones por segundo) puede mantener la inferencia interactiva dentro del presupuesto energético de un móvil o un portátil, siempre que el modelo sea lo bastante pequeño y esté cuantizado de forma lo bastante agresiva.
Los TOPS máximos son cifras de marketing, no experiencia de usuario. Aun así, el sector ha convergido en un umbral práctico para Windows: Microsoft define los PC Copilot+ como equipos con Windows 11 y una NPU de más de 40 TOPS, además de los mínimos habituales de memoria y almacenamiento para las funciones avanzadas de IA local.
El mapa del silicio en 2026
Qualcomm: la NPU Hexagon en el corazón del móvil
La gama insignia Snapdragon de Qualcomm convierte la NPU Hexagon en el centro de la IA agéntica móvil. En la ficha oficial del Snapdragon 8 Elite Gen 5, Qualcomm anuncia una NPU Hexagon un 37 % más rápida que la del Snapdragon 8 Elite anterior, con un 16 % más de rendimiento de IA por vatio. La ficha también enumera un amplio soporte numérico —de INT2 a FP16, con precisión mixta incluida— y un Sensing Hub con dos micro-NPU para grafos de audio, voz y sensores siempre activos que alimentan un almacén de conocimiento personal en el dispositivo.
Esas mejoras relativas importan más que un titular de TOPS. A los fabricantes de móviles les preocupan los tokens por segundo sostenidos para un LLM local de 3.000 a 8.000 millones de parámetros, la convivencia con el procesado de la cámara y que un agente pueda seguir trabajando con la radio apagada. El mensaje de Qualcomm para la Gen 5 apunta explícitamente a asistentes agénticos que actúan a partir del contexto local, no solo a responder mensajes de chat.
A finales de 2026, la documentación de su sucesor, el Snapdragon 8 Elite Gen 6, destaca una mayor memoria compartida de la NPU en el chip y un Hexagon Element Accelerator orientado al cálculo de transformers, lo que vuelve a subrayar que la localidad de la memoria, y no solo las operaciones máximas, es lo que limita la IA generativa local.
Apple: Neural Engine más Neural Accelerators en la GPU
Apple fue de las primeras en lanzar un Neural Engine dedicado y no ha dejado de ampliar la arquitectura de IA que lo rodea.
- Apple cifra el Neural Engine del M4 en hasta 38 billones de operaciones por segundo, con los aceleradores de ML de la CPU y la GPU trabajando como una vía combinada de IA en el dispositivo.
- El M5 (anunciado en octubre de 2025) mantiene un Neural Engine de 16 núcleos y añade un Neural Accelerator en cada núcleo de GPU; Apple asegura más de 4 veces el cómputo máximo de GPU para IA respecto al M4 y un ancho de banda de memoria unificada de 153 GB/s (alrededor de un 30 % más que el M4). Apple presenta ese ancho de banda como lo que permite mantener modelos más grandes íntegramente en el dispositivo en MacBook Pro, iPad Pro y Vision Pro.
- En el iPhone, la información publicada sobre la generación A18 / A18 Pro hablaba de un Neural Engine de 16 núcleos en torno a los 35 TOPS para las tareas de Apple Intelligence; el marketing de Apple sobre Apple Intelligence sigue insistiendo en un diseño híbrido: procesamiento sensible en el dispositivo y Private Cloud Cómputo cuando hace falta un modelo mayor.
La lección de Apple para 2026 es de arquitectura: la NPU para IA es necesaria, pero no suficiente. El ancho de banda de memoria y las rutas tensoriales de la GPU deciden si un modelo de difusión local o un LLM local de tamaño medio resultan realmente utilizables.
Intel: Lunar Lake supera el listón; Arrow Lake, a menudo no
En los PC con Windows, el requisito de Microsoft de una NPU de más de 40 TOPS trazó una línea divisoria muy clara.
Según informaciones basadas en documentación de Intel, la NPU de los Core Ultra 200V (Lunar Lake) ronda los 48 TOPS, suficiente para la certificación Copilot+. En cambio, muchos chips Arrow Lake Core Ultra 200H / 200HX figuraban con unos 13 TOPS en la NPU (en torno a 11 TOPS en algunos modelos 200U), por debajo del mínimo de NPU de Copilot+, aunque Intel promocionara unos «TOPS de plataforma» combinados de CPU, GPU y NPU cercanos a 99.
Esa división es la prueba más visible para el consumidor de que la IA en el dispositivo no es «cualquier pegatina de AI PC». Quien quiera Windows Studio Effects, funciones del tipo Recall y otras experiencias que dependen de la NPU debe mirar la potencia de la NPU, no solo la marca Core Ultra.
AMD: XDNA 2 y la clase de 50 TOPS
La serie Ryzen AI 300 de AMD, presentada en Computex 2024 y muy extendida en portátiles de 2025-2026, incorpora una NPU XDNA 2 de hasta 50 TOPS (con modelos HX de gama más alta, como el AI 9 HX 375, que los materiales de AMD sitúan en 55 TOPS). AMD presentó explícitamente la gama como preparada para Copilot+ y planteó la IA local como un argumento de privacidad y rapidez de respuesta para los portátiles con Windows.
A efectos de este artículo, AMD demuestra que, en cuanto Microsoft fijó un umbral numérico, los fabricantes x86 se lanzaron a superarlo con silicio NPU dedicado en lugar de confiar solo en la iGPU.
MediaTek: la lógica de la doble NPU en los Android de gama alta
El Dimensity 9500 de MediaTek (anunciado en septiembre de 2025) impulsa un discurso de doble NPU: una NPU 990 de alto rendimiento con Generative AI Engine 2.0 y una Super Efficient NPU con computación en memoria para modelos ligeros siempre activos. Según los comunicados de MediaTek, la plataforma duplica el cómputo frente a la generación anterior, introduce el procesamiento de grandes modelos BitNet de 1,58 bits con hasta un 33 % menos de consumo en esa ruta, una salida un 100 % más rápida para un LLM de 3.000 millones de parámetros respecto a la generación previa y procesamiento de textos largos de 128K tokens, además de generación de imágenes 4K en el dispositivo. Los análisis del sector (por ejemplo, de Counterpoint) sitúan el rendimiento máximo de IA de la clase 9500 en torno a los 100 TOPS: un dato útil, pero secundario frente a las cifras relativas de la propia MediaTek.
La apuesta de diseño es clara: el silicio Android de gama alta da ya por hecho que convivirán modelos de percepción siempre activos y ráfagas de trabajo generativo con un LLM local.
LLM locales: lo que de verdad cabe en un móvil o un PC
El hardware solo importa si la pila de software puede colocar en él un modelo útil. En 2026, «LLM local» suele referirse a un modelo de entre 1.000 y 8.000 millones de parámetros, aproximadamente (a veces más en PC con mucha RAM), cuantizado a 4 bits o menos y exportado mediante ONNX, ExecuTorch, Core ML, MLX o los hubs de IA de los fabricantes.
Funciones típicas en el dispositivo:
- Reescribir, resumir y redactar documentos breves o hilos de correo.
- Respuestas aumentadas por recuperación (RAG) sobre notas, mensajes o un índice personal guardados en el dispositivo.
- Asistentes multimodales que describen una foto o extraen su texto sin subir la imagen.
- Estructura de agente que planifica las llamadas a herramientas en local y, si procede, escala a la nube.
La vía Windows ML / ONNX Runtime de Microsoft, los paquetes de Qualcomm AI Hub, el marco Foundation Models de Apple y los despliegues locales de clase Gemini Nano en Android persiguen la misma idea: distribuir un modelo pequeño y cuantizado que la NPU pueda sostener a velocidades de tokens interactivas.
Donde los modelos locales todavía flaquean —seamos sinceros— es en la profundidad de razonamiento de vanguardia, el conocimiento actualizado del mundo y los contextos multimodales muy largos. Un LLM local de 3.000 a 7.000 millones de parámetros puede ser excelente para la productividad personal y aun así perder frente a un modelo puntero en la nube en exámenes difíciles, investigaciones de varios saltos o generación de vídeo con calidad de estudio. Es una característica del reparto edge/nube, no un fracaso de la NPU para IA.
Privacidad: el producto de verdad, con matices
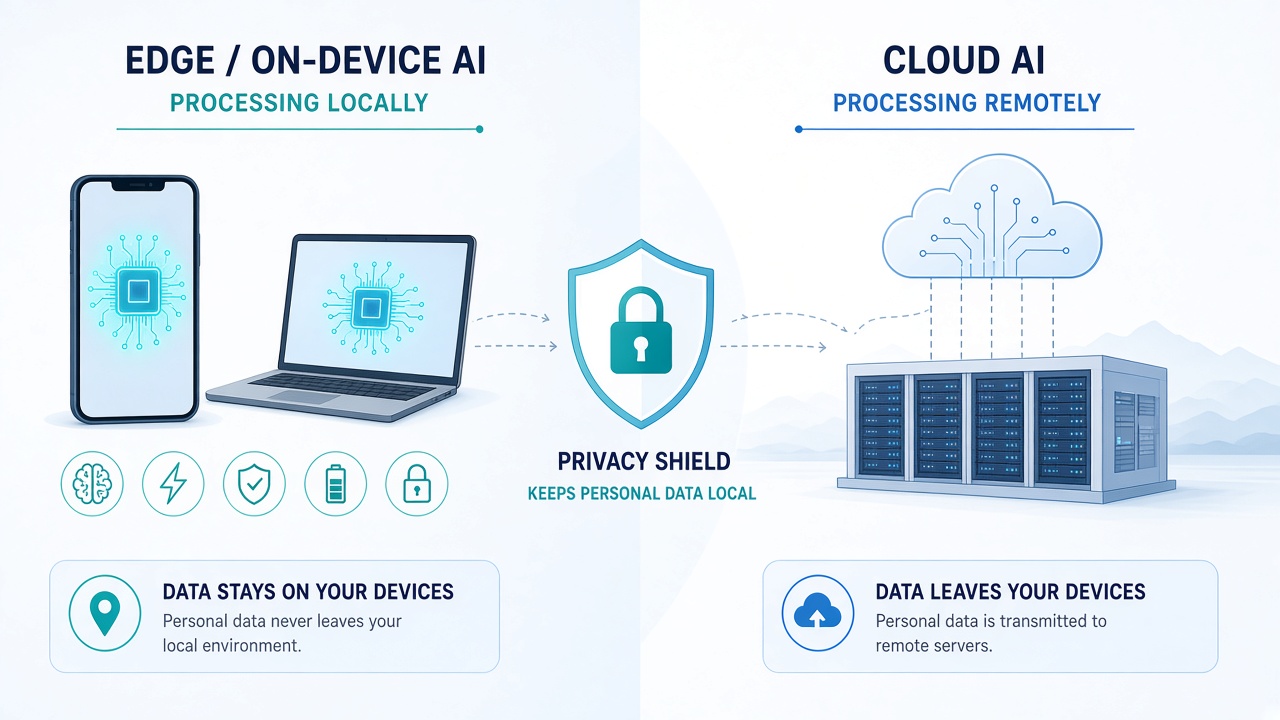
Los fabricantes venden la IA en el dispositivo como privacidad por defecto. Es en parte verdad y en parte marketing.
Lo cierto: si la inferencia nunca sale del SoC, la petición en bruto y el flujo de los sensores no tienen por qué pasar por un clúster de GPU de terceros. Funciones como las herramientas de Apple Intelligence en el dispositivo o las funciones de Windows que Microsoft documenta como locales en la NPU reducen la superficie de ataque del «todo en claro en el rack de otro».
Los matices:
- Híbrido por diseño. Apple, Google, Microsoft y los fabricantes de móviles siguen derivando las tareas difíciles a modelos en la nube. Private Cloud Cómputo y diseños similares intentan acotar la confianza necesaria, pero no equivalen a una inferencia puramente sin conexión.
- Telemetría y cuentas. La inferencia local no elimina los SDK de analítica, la sincronización de copias de seguridad ni las funciones ligadas a la cuenta.
- En el dispositivo no significa imposible de robar. Un móvil comprometido puede seguir leyendo la ventana de contexto de un modelo local. El cifrado de los pesos del modelo (la ficha de la Gen 5 de Qualcomm menciona el cifrado de modelos de IA generativa) protege más la propiedad intelectual que la privacidad del usuario frente al malware.
- Políticas empresariales. A los sectores regulados les importan la residencia de los datos y los registros de auditoría; un LLM local ayuda, pero los equipos de cumplimiento siguen necesitando controles sobre lo que puede escalar a la nube.
Trate la privacidad como un diagrama de flujo de datos, no como una insignia. Pregúntese qué tokens se quedan en la NPU, qué embeddings se sincronizan y qué peticiones salen del dispositivo.
Lo que aún necesita la nube
Una regla práctica útil para 2026:
| Carga de trabajo | Mejor en el dispositivo | Mejor en la nube |
|---|---|---|
| Subtítulos en directo, desenfoque, reducción de ruido | Sí | Rara vez |
| Reescritura / resumen breve de texto local | Sí | Opcional |
| Agente personal sobre índice de calendario/correo | Mayormente local | Escalar si se atasca |
| Agentes punteros de programación / investigación | Asistencia local | Sí |
| Entrenamiento / ajuste fino de grandes modelos | Solo LoRA pequeños | Sí |
| Generación de imagen/vídeo de estudio | Borradores / demos 4K en móvil | Calidad de gama alta |
| Conocimiento web reciente | Caché RAG | Búsqueda en directo |
La nube sigue siendo superior cuando se necesita escala (modelos enormes), actualidad (búsqueda en directo), colaboración (agentes compartidos) o cómputo a ráfagas que nunca cabría en el margen térmico de un móvil. Los productos ganadores de 2026 hacen explícito el relevo: un LLM local para la capa privada y sensible a la latencia, y la nube cuando el usuario acepta un razonamiento más profundo.
Plataformas e interfaces: cómo llegan los desarrolladores a la NPU
El silicio sin API es una función dormida. Dominan tres capas de interfaz:
- Runtimes de IA del sistema operativo: Windows ML (con ONNX Runtime por debajo y proveedores de ejecución automáticos), Core ML / Foundation Models / Metal de Apple y las vías de tipo AICore en Android.
- Hubs de los fabricantes: Qualcomm AI Hub y catálogos similares de modelos ya cuantizados y validados en NPU concretas.
- Frameworks multidispositivo: ONNX, ExecuTorch, MLX y pilas de tipo llama.cpp para desarrolladores que traen su propio LLM local.
Las directrices de Microsoft para desarrolladores de Copilot+ son inusualmente concretas: muchas de las experiencias de IA estrella de Windows dan por supuesta esa NPU de más de 40 TOPS; el Administrador de tareas muestra el uso de la NPU; Windows Performance Recorder incluye perfiles de procesamiento neuronal. Esa madurez de las herramientas pesa tanto como las tablas de TOPS a la hora de que la IA en el dispositivo se convierta en una plataforma de aplicaciones real.
Cómo elegir dispositivo a finales de 2026
Lista de comprobación práctica:
- Mire la cifra de la NPU, no el eslogan. En Windows, busque silicio de clase Copilot+ / más de 40 TOPS (clase Ryzen AI 300, clase Snapdragon X Elite, Intel Core Ultra 200V o chips posteriores con certificación Copilot+), no cualquier modelo Core Ultra.
- Compruebe la RAM. Los LLM locales y los modelos de visión consumen mucha memoria; 16 GB es un mínimo habitual para una IA en el dispositivo seria en PC, y más margen ayuda con contextos más largos.
- Pregunte qué funciones van sin conexión. Los textos promocionales difuminan lo híbrido y lo local. Dé prioridad a las páginas de fabricante que indican qué funciona sin red.
- Prefiera formatos de exportación abiertos si quiere usar su propio modelo (ONNX, GGUF, paquetes Core ML).
- Tenga en cuenta la temperatura. Los móviles reducen su rendimiento al calentarse; la velocidad de tokens sostenida importa más que la primera respuesta de una demo.
Conclusión
En 2026, la IA en el dispositivo es infraestructura real, no un vídeo de demostración. Las NPU de Qualcomm, Apple, Intel, AMD y MediaTek están ya junto a la CPU y la GPU como recursos de cómputo de primer nivel. Las pequeñas pilas de LLM local ofrecen asistentes privados y de baja latencia para el trabajo diario. El listón de 40 TOPS de los PC Copilot+ de Microsoft, el Neural Engine de Apple con los Neural Accelerators de la GPU, el XDNA 2 de clase 50 TOPS de AMD, la desigual historia de Lunar Lake frente a Arrow Lake en Intel y el Dimensity 9500 de doble NPU de MediaTek apuntan en la misma dirección: la inferencia en el borde es un requisito de producto.
La nube no ha perdido. Se ha especializado. La inteligencia de vanguardia, el entrenamiento y los trabajos creativos más duros siguen necesitando racks llenos de aceleradores. La arquitectura madura es un reparto edge/nube deliberado: mantener el contexto personal y la inferencia interactiva en el silicio de NPU para IA, enviar arriba solo el trabajo que de verdad necesita un modelo puntero y hacer visible ese relevo al usuario.
Ese reparto —y no la fantasía de «todo sin conexión» o «todo en la nube»— es la forma duradera de las plataformas de IA de consumo al cierre de 2026.
Lecturas relacionadas
- Edge encarnado: IA sin conexión para robots y vehículos
- Humanoides de consumo: precio, plazos y usos domésticos
- Modelos visión-lenguaje-acción: la nueva capa base de los robots
Referencias / fuentes
- Microsoft Learn — Copilot+ PCs developer guide (NPU > 40 TOPS definition and Windows ML guidance): https://learn.microsoft.com/en-us/windows/ai/npu-devices/
- Apple Newsroom — Apple introduces M4 chip (Neural Engine up to 38 TOPS): https://www.apple.com/newsroom/2024/05/apple-introduces-m4-chip/
- Apple Newsroom — Apple unleashes M5 (GPU Neural Accelerators, Neural Engine, 153 GB/s unified memory): https://www.apple.com/newsroom/2025/10/apple-unleashes-m5-the-next-big-leap-in-ai-performance-for-apple-silicon/
- AMD press release — AMD Unveils Next-Gen “Zen 5” Ryzen Processors… (Ryzen AI 300 / XDNA 2 up to 50 TOPS): https://ir.amd.com/news-events/press-releases/detail/1202/amd-unveils-next-gen-zen-5-ryzen-processors-to-power-advanced-ai-experiences
- Qualcomm — Snapdragon 8 Elite Gen 5 product brief (37% faster Hexagon NPU; 16% better AI perf/watt; precision list): https://www.qualcomm.com/content/dam/qcomm-martech/dm-assets/documents/Snapdragon-8-Elite-Gen-5-product-brief.pdf
- Qualcomm newsroom — Snapdragon 8 Elite Gen 5… announcement: https://www.qualcomm.com/news/releases/2025/09/snapdragon-8-elite-gen-5–the-world-s-fastest-mobile-system-on-a
- MediaTek press room — Dimensity 9500 (NPU 990, BitNet 1.58-bit, 128K context, dual/CIM NPU claims): https://www.mediatek.com/press-room/mediatek-dimensity-9500-unleashes-best-in-class-performance-ai-experiences-and-power-efficiency-for-the-next-generation-of-mobile-devices
- Counterpoint Research — MediaTek Dimensity 9500… (analyst summary including ~100 TOPS class context): https://www.counterpointresearch.com/en/insights/mediatek-dimensity-9500-powering-powering-next-gen-smartphones
- The Register — Intel’s new Arrow Lake chips can’t make the Copilot+ PC cut (Lunar Lake ~48 TOPS NPU; Arrow Lake H/HX ~13 TOPS / U ~11 TOPS): https://www.theregister.com/en instalaciones propias/2025/01/07/intels-new-arrow-lake-chips-cant-make-the-copilot-pc-cut/529267
- Gadgets 360 — Apple Introduces A18, A18 Pro… (16-core Neural Engine / ~35 TOPS reporting): https://www.gadgets360.com/mobiles/news/apple-iphone-16-series-a18-pro-chipset-details-6530448
- RCR Wireless News — Snapdragon 8 Elite Gen 6 splits on-device AI two ways (Element Accelerator; Extreme shared-memory focus): https://rcrtech.com/semiconductor-news/snapdragon-8-elite-gen-6-on-device-ai/
Imágenes: ilustraciones originales creadas para AndBeyond.Tech; no aparecen logotipos ni personas reales.