Entrenamiento multi-billones de parámetros: lo que debe entregar la próxima generación de silicio
Entrenamiento multi-billones de parámetros: qué debe entregar la próxima generación de silicio en ancho de banda, memoria y fabrics.
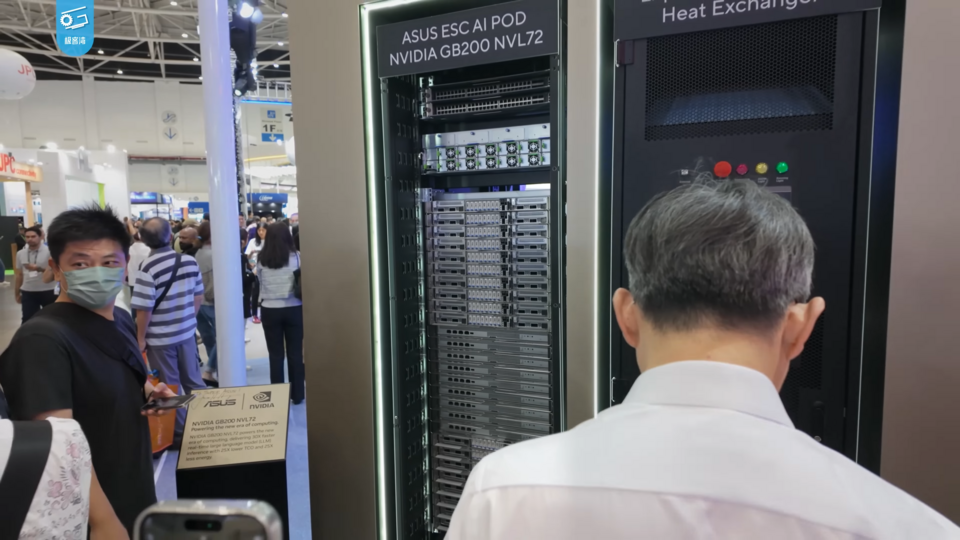
El techo de cómputo de los modelos de frontera ya no lo fija un solo chip. Lo fija el sistema entero: cuánta memoria de alto ancho de banda hay junto a cada procesador, cuántos procesadores pueden compartir esa memoria por un fabric de scale-up rápido, hasta dónde escala el clúster más allá del rack, y si el edificio puede alimentarlo y refrigerarlo. Esta guía de referencia permanente recorre esas cuatro restricciones y mira lo que racks de clase NVL como el GB200 NVL72 revelan sobre la próxima generación de silicio de entrenamiento de IA.
Por qué «el chip» es la unidad de análisis equivocada
La mirada pública más clara sobre lo que realmente exige el entrenamiento a escala frontera sigue siendo el paper de Meta sobre Llama 3. Meta entrenó su modelo de 405.000 millones de parámetros en «up to 16K H100 GPUs, each running at 700W TDP with 80GB HBM3». Cada servidor alojaba ocho GPU conectadas vía NVLink [1]. Ese modelo es una fracción de la escala multi-billones de parámetros para la que la industria diseña ya, y aun así el paper describe problemas en cada capa del sistema: capacidad de memoria, topología de red, fallos y oscilaciones de potencia lo bastante fuertes para estresar la red eléctrica. Esa lista de comprobación sirve para lo que el hardware next-gen debe resolver.
Meta es explícita: el modelo hay que partirlo para que quepa. Usó un «4D parallelism» que combina paralelismo de tensor, pipeline, contexto y datos. El objetivo: asegurar que «each GPU’s model parameters, optimizer states, gradients, and activations fit in its HBM» [1]. Incluso con un ajuste cuidadoso, Meta reportó un Model FLOPs Utilization (MFU) BF16 del 38–43 % en sus configuraciones principales [1]. Una gran parte del cómputo de pico queda sin usar por la memoria y el sobrecoste de comunicación. Esas dos restricciones son donde la próxima generación de silicio debe entregar.
Requisito 1: más HBM, y mucho más ancho de banda hacia ella
La memoria de alto ancho de banda (HBM) es la DRAM apilada colocada justo al lado del die del acelerador. Para una GPU HBM, la capacidad decide cuánto del modelo y de su estado de entrenamiento puede vivir en cada device. El ancho de banda decide a qué velocidad esos datos llegan a las unidades de cómputo.
El estándar industrial avanza rápido. JEDEC publicó el estándar JESD270-4 HBM4 en abril de 2025. Especifica «transfer speeds up to 8 Gb/s across a 2048-bit interface», lo que eleva «total bandwidth up to 2 TB/s» por stack. Duplica los canales independientes por stack de 16 a 32, y soporta stacks de hasta 16 de altura con «a higher cube density of 64GB» [2]. Entre las declaraciones industriales del comunicado, Google Cloud dice que HBM4 «represents the big step in bandwidth that Google needs for next generation training and inference systems» [2].
Las cifras de aceleradores enviados y anunciados muestran la tendencia:
- NVIDIA GB200 NVL72 (Blackwell, HBM3E): 13,4 TB de HBM3E por rack con 576 TB/s de ancho de banda agregado, o 372 GB y 16 TB/s por Superchip Grace Blackwell de dos GPU [3].
- NVIDIA Vera Rubin NVL72 (HBM4): 288 GB de HBM4 a 19,2 TB/s por GPU Rubin, y 20,7 TB a 1.400 TB/s por rack, según la página de producto actual de NVIDIA [4].
- Google TPU7x (Ironwood): 192 GiB de HBM por chip a 7.380 GB/s, frente a 95 GiB para v5p y 32 GiB para v6e (Trillium) [5].
La documentación de Google añade una advertencia válida para todos los proveedores: «despite its size, HBM can still be a bottleneck, particularly for memory-bound vector operations or inefficient data access patterns» [5]. Más capacidad permite a un job de entrenamiento usar batches mayores y menos shards. El ancho de banda decide si las unidades de cómputo se mantienen realmente ocupadas.
Las specs publicadas también pueden cambiar. Las propias páginas de NVIDIA llevan la etiqueta «preliminary specifications; may be subject to change» [6]. Los compradores que planifiquen una run multi-billones de parámetros deberían tratar las cifras de ancho de banda de memoria como objetivos hasta medirlas en sistemas entregados.
Requisito 2: un dominio de scale-up más grande y más rápido
Un modelo demasiado grande para un solo device debe intercambiar activaciones y gradientes sin cesar. El tráfico más hambriento de ancho de banda —paralelismo de tensor e intercambios all-to-all de los modelos mixture-of-experts (MoE)— debe quedarse dentro de un dominio de scale-up: un grupo de aceleradores enlazados por un fabric de semántica de memoria mucho más rápido que una red normal.
El paper Llama 3 de Meta explica por qué. Las dimensiones de paralelismo se ordenaron para que «the innermost parallelism requires the highest network bandwidth and lowest latency, and hence is usually constrained to within the same server» [1]. En el clúster de Meta, eso significaba ocho GPU.
El rack de clase NVL existe para ensanchar mucho ese límite. NVIDIA describe el GB200 NVL72 como la conexión de «36 Grace CPUs and 72 Blackwell GPUs in a rack-scale, liquid-cooled design» con «a 72-GPU NVIDIA NVLink domain that acts as a single, massive GPU». Su NVLink Switch System aporta «130 terabytes per second (TB/s) of low-latency GPU communications», y la quinta generación de NVLink da a cada GPU 1,8 TB/s [3]. La tabla de especificaciones NVLink de NVIDIA traza la progresión:
| Generación NVLink | Plataforma | Ancho de banda por GPU | Dominio NVLink | Agregado (NVL72) |
|---|---|---|---|---|
| 4.ª | Hopper | 900 GB/s | 8 GPU | 7,2 TB/s (8 GPU) |
| 5.ª | Blackwell | 1.800 GB/s | 8 o 72 GPU | 130 TB/s |
| 6.ª | Vera Rubin | 3.000 GB/s | 8 o 72 GPU | 216 TB/s |
Fuente: página de especificaciones NVIDIA NVLink (preliminar) [6].
Según NVIDIA, un rack NVL72 «can support 9x the GPU count versus a single eight-GPU system» dentro de un mismo dominio NVLink [6]. Para la generación Vera Rubin, NVIDIA afirma que el NVL72 «trains mixture-of-experts (MoE) models with one-fourth the number of GPUs compared to NVIDIA GB200 NVL72». Es una proyección basada en «a 10T MoE model trained on 100T tokens in a fixed timeframe of 1 month» [4]. El escenario de benchmark que NVIDIA eligió es en sí un modelo de diez billones de parámetros: esa es la escala para la que diseña la industria.
NVLink no es el único enfoque. El TPU7x de Google enlaza cada chip directamente con sus vecinos en un toro 3D. Los slices se construyen a partir de «cubes» 4×4×4, y un pod escala hasta 9.216 chips (144 cubes), con 1.200 GB/s de ancho de banda total bidireccional de interconexión entre chips por chip [5]. También llegan estándares abiertos. El consorcio UALink ratificó su especificación UALink 200G 1.0 en abril de 2025. Permite «200G per lane scale-up connection for up to 1,024 accelerators within an AI computing pod», con un board que incluye AMD, AWS, Google, Intel, Meta y Microsoft [7]. Gane el fabric que gane, el requisito es el mismo: dominios coherentes más grandes con latencia predecible.
Requisito 3: redes scale-out que no desperdicien las ganancias del scale-up
Ningún rack basta solo para una run de frontera, así que los diseños de clúster de IA NVL72 siguen dependiendo del networking scale-out entre racks. También aquí el paper de Meta es inusualmente preciso. Su clúster RoCE para Llama 3 era una red Clos de tres capas. Los pods de 3.072 GPU tenían ancho de banda de bisección completo, pero la capa de agregación que unía ocho pods en un clúster de 24K GPU tenía «an oversubscription ratio of 1:7». Meta hizo su paralelismo y su scheduler conscientes de la «network topology» para minimizar el tráfico entre pods [1]. Meta también tuvo que sortear problemas de equilibrado de carga porque el entrenamiento de LLM «produces fat network flows that are hard to load balance» [1].
Los proveedores están metiendo más ancho de banda y un transporte más inteligente en el tier scale-out. NVIDIA lista 32,4 TB/s de ancho de banda de red por rack Vera Rubin NVL72, con scale-out sobre InfiniBand Quantum-X800 o Ethernet Spectrum-X [4]. En el lado abierto, el Ultra Ethernet Consortium publicó la especificación UEC 1.0 en junio de 2025. La describe como «a comprehensive, Ethernet-based communication stack diseñado para meet the demanding needs of modern Artificial Intelligence (AI) and cargas de High-Performance Computing (HPC)», que cubre «NICs, switches, optics, and cables», y dice que «scales to millions of endpoints» [8].
El principio de diseño sigue de la experiencia Llama 3. Poner el paralelismo más intensivo en comunicación dentro del dominio scale-up, y hacer el fabric scale-out lo bastante bueno para que el tráfico data-parallel y de pipeline no detenga el job.
Requisito 4: densidad de potencia y refrigeración líquida
Empaquetar 72 GPU en un solo dominio NVLink es empaquetarlas en un rack, y eso cambia la instalación. La arquitectura de referencia de Vertiv codearrollada con NVIDIA para el GB200 NVL72 «supports up to 132kW per rack». Usa un diseño híbrido líquido y aire para «efficiently manage high-density heat removal», y escala hasta un despliegue de 7 MW [9]. Las páginas de NVIDIA describen el NVL72 como refrigerado por líquido. Dicen que la refrigeración líquida «increases cómputo density, reduces the amount of floor space used, and facilitates high-bandwidth, low-latency GPU communication with large NVLink domain architectures» [3]. Para Vera Rubin NVL72, NVIDIA lista una temperatura de entrada de refrigerante de 45 °C [4].
El propio texto de NVIDIA une ambos: el rack denso refrigerado por líquido es lo que hace práctico el gran dominio NVLink [3]. El requisito de scale-up y el de refrigeración son el mismo problema visto desde dos lados.
La potencia no es solo cuestión de densidad. También es la velocidad de las oscilaciones de carga. Meta reportó que durante el entrenamiento «tens of thousands of GPUs may increase or decrease power consumption at the same time», por ejemplo al esperar checkpoints u operaciones colectivas. Eso «can result in instant fluctuations of power consumption across the data center on the order of tens of megawatts, stretching the limits of the power grid» [1]. Meta también observó «a diurnal 1-2% caudal de proceso variation» ligada a las temperaturas del mediodía que afectan al escalado de tensión y frecuencia de la GPU [1]. La arquitectura de Vertiv incluye «load averaging via lithium-ion battery and next generation UPS» para «support dynamic GPU cargas de trabajo» [9]. La infraestructura empieza a responder a este problema de forma directa.
Requisito 5: fiabilidad a escala
Cuanto mayor es el job síncrono, más cara resulta cada falla. Meta escribió que «a single GPU failure may require a restart of the entire job». En una instantánea de 54 días del preentrenamiento de Llama 3 registró 466 interrupciones de job, 419 de ellas inesperadas. Alrededor del 78 % de las inesperadas se atribuyeron a problemas de hardware confirmados o sospechados [1]. Las GPU defectuosas (148 interrupciones, 30,1 %) y la memoria HBM3 de GPU (72, 17,2 %) fueron las dos categorías mayores [1]. Meta aun así alcanzó «higher than 90% effective training time» mediante automatización, checkpointing más rápido y herramientas de diagnóstico [1].
Para el entrenamiento multi-billones de parámetros en muchos más devices, la capacidad de servicio es un requisito de silicio y de sistema por derecho propio. El switch NVLink 6 de NVIDIA añade «control plane resilience, the ability to run with a partially populated rack, and hot-swapping of switch trays» [6]. El estándar HBM4 de JEDEC incluye Directed Refresh Management «for improved row-hammer mitigation and Reliability, Availability, and Serviceability (RAS)» [2]. Estas funciones atraen menos atención que los FLOPS, pero a escala de clúster pueden decidir si una run de entrenamiento termina a tiempo.
La lista de comprobación: lo que debe entregar el silicio de entrenamiento de IA next-gen
Combinando la evidencia anterior, una plataforma creíble para el entrenamiento multi-billones de parámetros necesita entregar:
- Capacidad y ancho de banda HBM que crezcan más rápido que el cómputo. Stacks de clase HBM4 [2] y capacidad por device en cientos de gigabytes [4][5], para que parámetros, estados del optimizador y activaciones puedan shardarse en menos devices [1].
- Un dominio de scale-up grande. Decenas de devices o más con ancho de banda all-to-all medido en terabytes por segundo por device [3][6], o alternativas abiertas como UALink que apuntan a hasta 1.024 aceleradores [7].
- Un fabric scale-out consciente de la topología. Que limite el coste de la sobresuscripción [1], construido sobre InfiniBand o Ethernet afinado para IA [4][8].
- Potencia y refrigeración del rack diseñadas junto con el silicio. Racks refrigerados por líquido de clase 100+ kW [9], con suavizado de potencia para oscilaciones de carga síncronas [1][9].
- Funciones de fiabilidad integradas. RAS de memoria [2], fabrics de switch resilientes [6] y software que se recupere automáticamente [1].
Conclusión
La carrera por entrenar modelos multi-billones de parámetros es una carrera por construir sistemas equilibrados. Los propios datos de la industria muestran que la capacidad de memoria, el ancho de banda de interconexión, la potencia de la instalación y el manejo de fallos pueden convertirse cada uno en el factor limitante antes que los FLOPS brutos. Los racks de clase NVL72, HBM4 y los estándares abiertos de scale-up y scale-out son las respuestas actuales de la industria. Al juzgar el próximo lanzamiento de silicio de entrenamiento de IA, mire más allá de los FLOPS del titular. Compruebe la memoria, el tamaño del dominio de scale-up, los vatios por rack y con qué gracia el sistema encaja la falla de una pieza.
Lecturas relacionadas
- Mercado de aceleradores de IA: GPU, ASIC a medida y quién gana la inferencia
- InfiniBand vs Ethernet para clústeres de IA: la guerra de fabrics dentro de la fábrica de IA
- Cómo las superfábricas de IA distribuidas estiran la red entre campus
Referencias / Fuentes
- Llama Team, AI @ Meta — «The Llama 3 Herd of Models» (arXiv:2407.21783, July 2024), §3.3. https://arxiv.org/html/2407.21783v2
- JEDEC — «JEDEC and Industry Leaders Collaborate to Release JESD270-4 HBM4 Standard» (Apr 16, 2025). https://www.jedec.org/news/pressreleases/jedec%C2%AE-and-industry-leaders-collaborate-release-jesd270-4-hbm4-standard-advancing
- NVIDIA — «GB200 NVL72» product page. https://www.nvidia.com/en-us/data-center/gb200-nvl72/
- NVIDIA — «Vera Rubin NVL72» product page. https://www.nvidia.com/en-us/data-center/vera-rubin-nvl72/
- Google Cloud Documentation — «TPU7x (Ironwood)» (last updated Oct 29, 2026). https://docs.cloud.google.com/tpu/docs/tpu7x
- NVIDIA — «NVLink and NVLink Switch» (specifications, preliminary). https://www.nvidia.com/en-us/data-center/nvlink/
- UALink Consortium — «UALink Consortium Releases the Ultra Accelerator Link 200G 1.0 Specification» (Apr 8, 2025). https://ualinkconsortium.org/wp-content/uploads/2025/04/UALink-1.0-Specification-PR_FINAL.pdf
- Ultra Ethernet Consortium — «UEC Launches Specification 1.0» (Jun 11, 2025). https://ultraethernet.org/ultra-ethernet-consortium-uec-launches-specification-1-0-transforming-ethernet-for-ai-and-hpc-at-scale/
- Vertiv — «Vertiv codevelops with NVIDIA complete power and cooling blueprint for NVIDIA GB200 NVL72 platform» (Oct 15, 2024). https://prod.vertiv.cn/en-asia/about/news-and-events/news-releases/vertiv-codevelops-with-nvidia-complete-power-and-cooling-blueprint-for–nvidia-gb200-nvl72-platform/
Imágenes: ilustraciones generadas para AndBeyond.Tech, salvo: Rack NVIDIA GB200 NVL72 en exposición — 极客湾Geekerwan, Wikimedia Commons, CC BY 3.0; Diagrama en sección de HBM — 思考的苇丛, Wikimedia Commons, CC BY-SA 4.0.