Usines de données pour l’IA physique : comment les données synthétiques accélèrent les robots industriels
Usine de données pour l’IA physique : comment les données synthétiques NVIDIA Cosmos accélèrent les robots industriels et où le sim-to-real échoue.
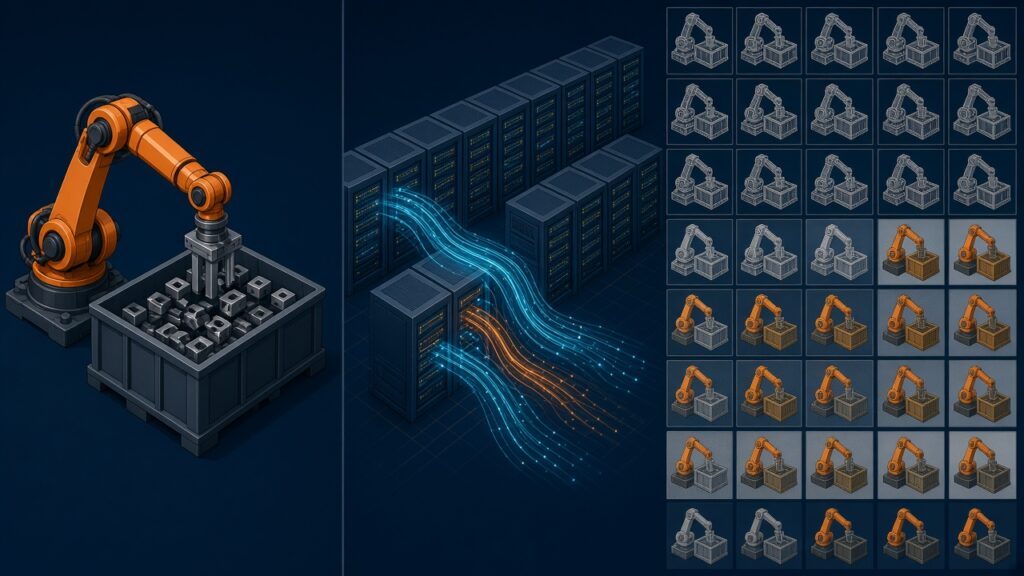
Les robots industriels n’ont jamais manqué de puissance de calcul. Ils ont manqué d’exemples. Un robot de dévracage guidé par vision doit voir des milliers de poses de pièces sous un éclairage changeant. Un modèle d’inspection a besoin de défauts qui, sur une ligne bien tenue, ne se produisent presque jamais. Une politique de manipulation pour une nouvelle étape d’assemblage exige des heures de démonstrations que quelqu’un doit téléopérer, annoter et nettoyer. Pour la plupart des industriels, c’est ce goulet de données — et non le prix d’un GPU ou d’un bras robotisé — qui transforme un pilote prometteur en projet enlisé.
C’est le problème que l’usine de données pour l’IA physique entend résoudre. L’expression, largement promue par NVIDIA tout au long de 2026, désigne une chaîne industrialisée qui transforme un volume limité d’enregistrements réels en vastes jeux d’entraînement annotés et validés pour les robots, les agents de vision IA et les machines autonomes. Lors de sa GTC de mars, NVIDIA a présenté les choses sans détour : selon Rev Lebaredian, son vice-président chargé d’Omniverse et des technologies de simulation, « le calcul, c’est de la donnée ».
Ce slogan mérite d’être examiné. Cet article décrit ce que contient réellement une usine de données, comment les flux de données synthétiques en robotique s’articulent avec des techniques sim-to-real plus anciennes comme la randomisation de domaine, ce que rapportent les premiers utilisateurs, et où l’approche se heurte encore aux limites dures de la physique, des défauts rares et de la certification de sécurité.
Ce que signifie « usine de données » pour l’apprentissage robotique
Dans l’IA logicielle, les données d’entraînement ont été collectées sur le web à une échelle gigantesque. L’IA physique n’a pas d’équivalent. Les données robotiques sont coûteuses à collecter, spécifiques à un bras, une pince, un ensemble de capteurs et une configuration de cellule donnés, et souvent dangereuses à recueillir pour les scénarios qui comptent le plus : collisions, déversements, pièces qui tombent, personnes qui entrent dans l’enveloppe de travail. Une étude récente sur l’IA incarnée pour l’industrie, publiée dans National Science Review, décrit les jeux de données industriels comme clairsemés, déséquilibrés et étroitement liés à des équipements spécifiques, les événements rares et les conditions à tolérances serrées y étant systématiquement sous-représentés.
Une usine de données traite cette rareté comme un problème de production. Plutôt que de tout collecter physiquement, les équipes font tourner une chaîne reproductible en plusieurs étapes :
- Trier et rechercher dans les vidéos et journaux de capteurs existants pour retrouver les bons extraits, les dédoublonner et les annoter.
- Augmenter et démultiplier ces extraits — en changeant l’éclairage, la météo, les textures, les arrière-plans ou l’apparence des objets tout en préservant la géométrie de la scène.
- Générer de nouveaux échantillons, soit par simulation physique d’une scène 3D, soit à partir de modèles de monde génératifs conditionnés par des entrées réelles.
- Annoter automatiquement, puisque les données synthétiques et augmentées peuvent porter une vérité terrain (boîtes englobantes, masques, poses, trajectoires) que des humains devraient sinon tracer.
- Évaluer et filtrer les sorties générées, en écartant les échantillons physiquement invraisemblables ou hors sujet avant qu’ils n’atteignent l’entraînement.
La métaphore de l’« usine » compte, car chaque étape est censée être orchestrée, mise à l’échelle et supervisée comme une ligne de production, avec un débit limité principalement par la capacité d’accélérateurs disponible. C’est pourquoi ce sujet relève autant des accélérateurs et des puces IA que de l’apprentissage robotique : l’argument économique est que des heures de GPU peuvent remplacer une partie des heures de démonstration humaine et du temps d’essais physiques.
Dans le blueprint de NVIDIA : de PAIDF à Cosmos Data Factory
NVIDIA a annoncé son Physical AI Data Factory Blueprint le 16 mars 2026, une architecture de référence ouverte pour générer, augmenter et évaluer des données d’entraînement destinées à la robotique, aux agents de vision IA et aux véhicules autonomes. Selon le communiqué de l’entreprise, le blueprint organise le travail en trois flux principaux reposant sur ses modèles de fondation de monde NVIDIA Cosmos :
- Cosmos Curator traite, affine et annote de grands jeux de données réels et synthétiques.
- Cosmos Transfer décline les données triées en versions plus variées — environnements, éclairages et conditions différents — pour couvrir les scénarios de longue traîne.
- Cosmos Evaluator, construit sur le modèle Cosmos Reason, note et filtre les données générées selon leur exactitude physique avant leur utilisation pour l’entraînement.
L’orchestration passait initialement par NVIDIA OSMO, un framework de workflows open source qui, selon NVIDIA, devait s’intégrer à des agents de code. Microsoft Azure et Nebius ont été cités comme les premières plateformes cloud proposant le blueprint, et NVIDIA comptait FieldAI, Hexagon Robotics, Linker Vision, Milestone Systems, RoboForce, Skild AI, Teradyne Robotics et Uber parmi les premiers utilisateurs.
Le projet a depuis été renommé. Le dépôt GitHub public l’appelle désormais NVIDIA Cosmos Data Factory (CDF), et son guide de migration explique deux changements simultanés : le nom, et le passage à Apache Airflow comme couche d’orchestration unique, Kubernetes étant pris en charge comme backend d’exécution pour tous les blueprints et OSMO conservé comme backend pour certains. Pour les équipes d’ingénierie qui évaluent la pile, ce détail est pratique plus que cosmétique : Airflow et Kubernetes sont des outils que de nombreuses équipes IT et data d’usine exploitent déjà.
Le dépôt recense cinq blueprints de référence :
| Blueprint | Ce qu’il fait (selon le dépôt de NVIDIA) | Intérêt pour la robotique industrielle |
|---|---|---|
| Defect Image Generation | Transforme des références de composants PCB, métal et verre en images simulées, puis y ajoute des défauts générés | Modèles d’inspection quand les échantillons réels de défauts sont rares |
| Event Video Generation | Convertit une image de départ en vidéos annotées d’événements rares comme des incendies ou des chutes | Surveillance de sécurité, détection d’anomalies en cellule et en entrepôt |
| Video Data Augmentation | Re-rend des vidéos existantes sous divers éclairages, météos et conditions environnementales en conservant la structure de la scène | Robustesse des robots mobiles et des sites extérieurs ou à éclairage mixte |
| Image Attribute Augmentation | Fait varier les attributs d’apparence de recadrages de personnes | Réidentification des personnes à proximité des robots |
| Autonomous Vehicle Dataset Generation | Retrouve des extraits de conduite similaires et en génère des variantes | Moins directement industriel ; utile pour l’autonomie en cour logistique et en intralogistique |
Au niveau inférieur se trouvent des « skills » réutilisables : génération d’anomalies à partir d’une poignée d’exemples, augmentation, annotation automatique, tri et recherche, orchestration, et un skill Simulation qui produit des images annotées à partir de scènes 3D avec Isaac Sim et Omniverse Replicator. Ce dernier composant rappelle que l’usine de données ne se limite pas à la vidéo générative : le rendu physique classique d’un jumeau numérique fait toujours partie de la boîte à outils.
Dans une mise à jour d’octobre 2026, NVIDIA a indiqué que Cosmos Data Factory était disponible via GitHub, Microsoft Azure, Nebius et CoreWeave, et que Cosmos Curator prenait désormais en charge des entrées multimodales et multicapteurs.
Des pixels au mouvement : des trajectoires synthétiques pour la manipulation
Les données de perception sont la moitié la plus facile. Apprendre à un robot comment bouger nécessite des données d’action — trajectoires articulaires ou commandes de l’effecteur associées à des observations. Le blueprint Isaac GR00T-Dreams de NVIDIA, construit sur Cosmos, s’attaque à ce problème avec un processus en cinq étapes décrit dans un blog technique de NVIDIA :
- Collecter un petit ensemble de démonstrations téléopérées d’une tâche dans un environnement, et s’en servir pour post-entraîner un modèle de monde Cosmos Predict sur le robot concerné.
- Interroger le modèle affiné avec une image initiale et de nouvelles instructions en langage naturel pour générer de nombreuses vidéos (des « rêves ») de nouvelles tâches.
- Utiliser Cosmos Reason pour écarter les rêves ratés ou défectueux.
- Exécuter un modèle de dynamique inverse qui déduit les actions entre paires d’images, convertissant la vidéo 2D en « trajectoires neuronales ».
- Entraîner une politique visuomotrice sur ces trajectoires, seules ou en co-entraînement avec des données réelles.
La recherche sous-jacente, publiée sous le nom de DreamGen, indique qu’un robot humanoïde a appris 22 nouveaux comportements, dans des environnements connus et inconnus, à partir de données de téléopération portant sur une seule tâche de pick-and-place. Le dépôt open source prend en charge plusieurs incarnations, dont le bras Franka Panda, l’humanoïde Fourier GR1 et le bras à bas coût SO-100.
Pour les lecteurs industriels, la réserve importante figure dans le propre Cosmos Cookbook de NVIDIA. Sa recette GR00T-Dreams précise que les trajectoires générées peuvent être physiquement plausibles tout en différant des données robotiques réelles ; que le critique Cosmos Reason est « un indicateur indirect » de plausibilité physique et non un oracle de vérité terrain ; et que les résultats sont meilleurs sur des configurations proches des données de manipulation ayant servi à entraîner le modèle. Ces réserves ne sont pas des notes de bas de page : elles définissent le domaine de pertinence actuel de la technique.
Sim-to-real et randomisation de domaine : les fondations plus anciennes
Les données synthétiques en robotique n’ont pas commencé avec les modèles de monde. La référence canonique est un article de 2017 de Josh Tobin et de ses collègues d’OpenAI et de l’UC Berkeley, qui a introduit la randomisation de domaine pour le transfert sim-to-real. Plutôt que de chercher à rendre un simulateur parfaitement réaliste, les auteurs ont randomisé textures, éclairage, positions de caméra et objets distracteurs si fortement que « le monde réel peut apparaître au modèle comme une simple variante de plus ». Leur détecteur d’objets, entraîné uniquement sur des images simulées non réalistes, localisait les objets réels à environ 1,5 cm près et a servi à piloter la préhension dans un environnement encombré.
Les usines de données modernes combinent les deux philosophies. Les outils physiques comme Isaac Sim avec Replicator fournissent des annotations exactes et une randomisation contrôlable. Les modèles génératifs comme Cosmos Transfer ajoutent une variation photoréaliste ancrée dans des vidéos réelles, ce qui peut réduire l’écart d’apparence que la randomisation pure laisse ouvert. Et les évaluateurs tentent de repérer les échantillons générés qui enfreignent les lois physiques.
Une étude empirique de 2026 sur la généralisation sim-to-real des modèles vision-langage-action formule précisément la question en suspens : quelle part de la performance en conditions réelles revient respectivement à la randomisation multiniveau, au rendu photoréaliste, au réalisme physique et aux mises à jour par apprentissage par renforcement ? La réponse honnête, dans l’ensemble de la littérature, est que cela dépend fortement de la tâche. Les écarts d’apparence sont de plus en plus maîtrisables. Les écarts de dynamique, non.
Ce que rapportent les premiers utilisateurs — et comment le lire
La mise à jour Cosmos d’octobre 2026 de NVIDIA recense plusieurs déploiements. Tous les chiffres ci-dessous sont communiqués par les fournisseurs et n’ont pas été vérifiés de façon indépendante par AndBeyond.Tech :
- ANYbotics a généré plus de 1 500 extraits vidéo synthétiques avec les blueprints Cosmos Data Factory, en triant des données réelles et en validant les sorties avec la plateforme d’Encord, pour entraîner ses robots d’inspection industrielle à repérer des fuites de liquide et d’autres changements entre deux rondes sur site.
- Ultralytics a réentraîné un détecteur YOLO sur des images réelles complétées par des défauts synthétiques ciblés et, selon NVIDIA, a amélioré la localisation des défauts et le rappel. Aucun chiffre n’a été publié dans l’annonce.
- Fogsphere, en collaboration avec ADNOC, utilise l’usine de données pour générer des données d’entraînement synthétiques sur des dangers rares, afin de ne pas avoir à les mettre en scène physiquement.
- Dans l’automobile, Porsche construit un « data flywheel » partagé pour la conduite autonome entre les marques du groupe Volkswagen ; NVIDIA indique que cela devrait réduire jusqu’à 90 % les essais routiers physiques répétés et raccourcir les cycles de développement jusqu’à 85 %. Ce sont des projections, pas des résultats mesurés.
Le schéma est révélateur. Les cas industriels les plus concrets concernent des tâches de perception — inspection, détection d’anomalies, reconnaissance de dangers — où des images ou extraits synthétiques complètent une base réelle. Cela correspond au domaine où les données synthétiques ont le plus long historique. Les affirmations sur des politiques de manipulation généralistes entraînées en grande partie sur des données générées restent surtout du ressort de la recherche et des premiers pilotes.
Les réalités du déploiement industriel
Pour une équipe d’ingénierie d’usine, adopter une usine de données relève moins des modèles que de la tuyauterie et de la gouvernance.
Les actifs numériques sont le ticket d’entrée. La génération physique exige une CAO, des matériaux et des configurations de cellules précis ; l’augmentation générative a besoin de vidéos réelles représentatives. Beaucoup de sites existants n’ont ni l’un ni l’autre sous une forme exploitable.
Le calcul est un poste budgétaire, pas une ressource gratuite. L’argument « le calcul, c’est de la donnée » suppose un accès à des clusters de GPU, sur site ou via des clouds comme Azure, Nebius ou CoreWeave. Une génération best-of-N suivie d’un filtrage par critique, comme le note le Cosmos Cookbook, multiplie le coût de calcul. Les équipes doivent le comparer au coût d’une simple collecte de données réelles supplémentaires sur une ligne mise en scène.
La traçabilité des données doit être assurée. Quand un modèle échoue en atelier, les ingénieurs doivent savoir quels lots synthétiques, quels prompts et quelles versions de modèle l’ont façonné. Des outils de pipeline comme Airflow y aident, mais seulement si le versionnage est imposé.
Les données réelles ne disparaissent jamais. Tous les flux crédibles — des travaux de randomisation de Tobin au co-entraînement GR00T-Dreams — conservent les données réelles comme ancrage, comme jeu de test, ou les deux. Les recherches qui relient scènes réelles et génération synthétique aboutissent à la même conclusion : les données synthétiques fonctionnent mieux en complément d’une capture réelle.
Les limites des données synthétiques : une check-list pratique
Avant de miser une ligne sur les données synthétiques, vérifiez ces modes de défaillance.
L’écart de domaine sur le contact et la dynamique
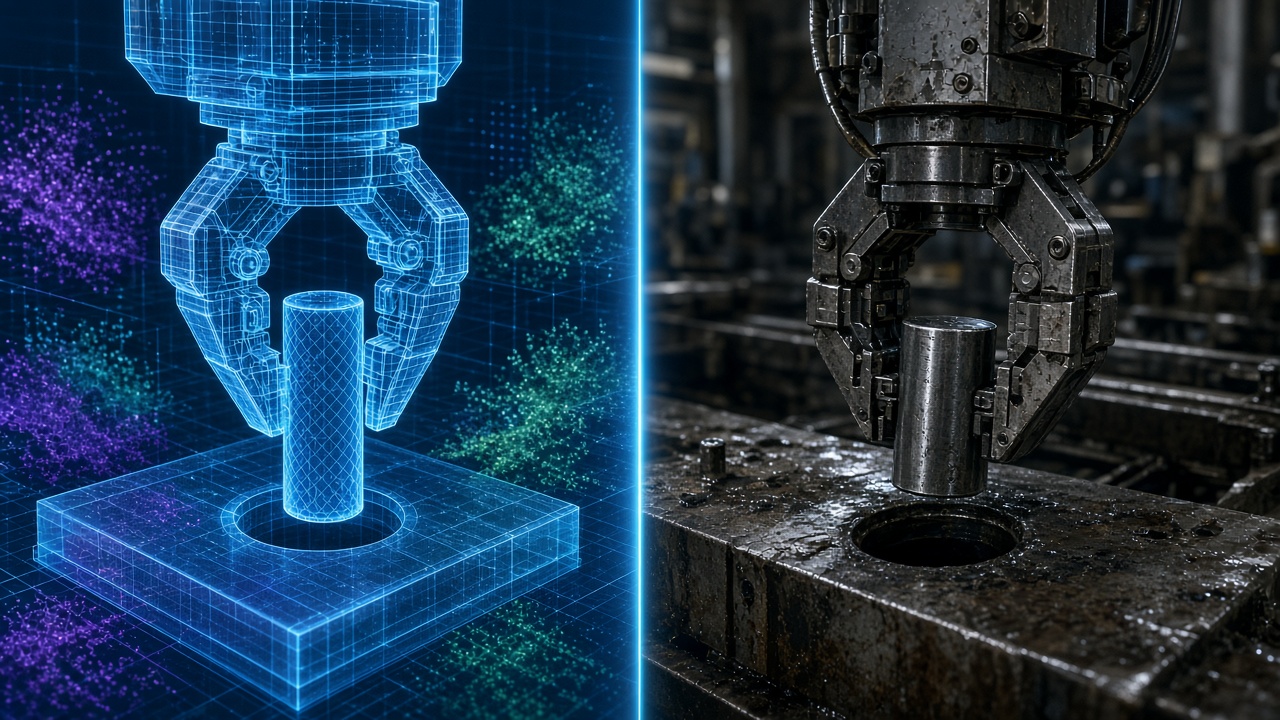
Le rendu a progressé plus vite que la physique. Un article de position de 2020 sur la simulation du contact soulignait que les simulateurs robotiques courants modélisent le contact comme des points uniques, alors que le contact réel est distribué, et que le frottement, les matériaux déformables et les corps mous restent difficiles à capturer. La recherche sur l’insertion industrielle montre pourquoi c’est important : les jeux d’assemblage serrés peuvent descendre sous 0,1 mm, là où de petites erreurs de modélisation décident entre réussite et blocage. La vidéo générative ne règle pas ce problème : elle apprend à quoi ressemble un mouvement, pas les forces en jeu. Attendez-vous à ce que les tâches riches en contacts nécessitent un affinage en conditions réelles, un contrôle en compliance ou une identification de système.
Défauts rares et « inconnues inconnues »
Les générateurs peuvent démultiplier des types de défauts qu’on leur a déjà montrés. Ils ne peuvent pas inventer le mode de défaillance que personne n’a vu, et ils peuvent introduire des artefacts qu’un modèle apprendra à exploiter. Conservez un jeu de défauts réels mis de côté pour la validation, mesurez les défauts échappés sur ce jeu et accueillez avec méfiance les gains obtenus uniquement sur données synthétiques. La maintenance de la chaîne représente aussi un vrai travail : l’étude sur l’IA incarnée industrielle note que les modèles de contact et de matériaux haute fidélité sont coûteux à tenir à jour à mesure que les produits, les montages et les états d’usure évoluent.
Les évaluateurs filtrent, ils ne certifient pas
Les critiques automatiques comme Cosmos Evaluator et Cosmos Reason améliorent la qualité des jeux de données, mais la documentation de NVIDIA elle-même qualifie le critique d’indicateur indirect, susceptible de manquer des détails physiques fins. Un extrait plausible n’est pas un extrait validé.
La validation de sécurité reste physique
Les données synthétiques peuvent élargir la couverture d’entraînement et soutenir les tests de scénarios, mais elles ne changent pas qui est responsable de la sécurité. L’ISO 10218-1 :2025 et l’ISO 10218-2 :2025, normes révisées de sécurité des robots industriels publiées en 2025, couvrent la conception des robots et l’intégration des cellules robotisées, y compris la sécurité fonctionnelle et les applications collaboratives auparavant traitées par l’ISO/TS 15066. L’analyse de risques, la vérification des fonctions de sécurité et la mise en service se font toujours sur du matériel réel. Un composant appris de perception ou de mouvement doit disposer de ses propres preuves de validation sur données réelles, séparées de toute couche de sécurité certifiée.
Perspectives : une discipline de production, pas un raccourci
L’usine de données pour l’IA physique se comprend le mieux comme une discipline de production en voie de maturité pour les données d’entraînement robotiques. NVIDIA a assemblé une chaîne d’outils ouverte et cohérente — Cosmos Curator, Transfer, Reason et Evaluator, Isaac Sim et Replicator, GR00T-Dreams — et l’a portée sur des outils d’orchestration familiers aux équipes des entreprises. Les premiers usages industriels en inspection et en détection d’anomalies paraissent sensés et peu risqués.
Ce qu’elle ne fait pas, c’est supprimer l’écart avec la réalité. Pour les industriels, la voie pragmatique fin 2026 consiste à commencer là où les données synthétiques ont fait leurs preuves — perception, augmentation des défauts rares, robustesse à l’éclairage et à l’environnement —, à conserver un jeu de validation réel rigoureux, et à considérer les trajectoires de manipulation générées comme un complément prometteur aux démonstrations réelles et aux essais de sécurité physiques, et non comme leur remplaçant. Le calcul peut produire des données. Seul l’atelier peut dire si ces données étaient justes.
À lire aussi
- Sim-to-real en 2026 : combler l’écart sans données réelles à l’infini
- Cobots IA et vision : là où les usines voient le ROI en premier
- Modèles vision-langage-action : la nouvelle couche de base des robots
< !– Schema.org NewsArticle (CF_SEO) — image paths relative to draft ; replace with absolute CDN URLs at publish –>
Références / sources
- NVIDIA press release, « NVIDIA Announces Open Physical AI Data Factory Blueprint to Accelerate Robotics, Vision AI Agents and Autonomous Vehicle Development » (16 March 2026): https://investor.nvidia.com/news/press-release-details/2026/NVIDIA-Announces-Open-Physical-AI-Data-Factory-Blueprint-to-Accelerate-Robotics-Vision-AI-Agents-and-Autonomous-Vehicle-Development/default.aspx
- NVIDIA Blog, « NVIDIA GTC Showcases Virtual Worlds Powering the Physical AI Era »: https://blogs.nvidia.com/blog/gtc-2026-virtual-worlds-physical-ai/
- NVIDIA Blog, « NVIDIA Cosmos Opens New Tools to Train, Evaluate and Deploy World Models » (21 October 2026): https://blogs.nvidia.com/blog/cosmos-open-train-evaluate-deploy-world-models/
- NVIDIA Cosmos Data Factory repository (GitHub): https://github.com/NVIDIA/cosmos-data-factory
- Cosmos Data Factory migration guide (PAIDF → CDF, Airflow orchestration): https://github.com/NVIDIA/cosmos-data-factory/blob/main/MIGRATION.md
- NVIDIA Technical Blog, « Enhance Robot Learning with Synthetic Trajectory Data Generated by World Foundation Models »: https://developer.nvidia.com/blog/enhance-robot-learning-with-synthetic-trajectory-data-generated-by-world-foundation-models/
- NVIDIA GR00T-Dreams repository (GitHub): https://github.com/nvidia/GR00T-dreams
- Cosmos Cookbook, « Leveraging World Foundation Models for Synthetic Trajectory Generation in Robot Learning »: https://nvidia-cosmos.github.io/cosmos-cookbook/recipes/end2end/gr00t-dreams/post-training.html
- Jang et al., « DreamGen: Unlocking Generalization in Robot Learning through Video World Models » (arXiv 2505.12705): https://arxiv.org/html/2505.12705v2
- Tobin et al., « Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World » (arXiv 1703.06907, IROS 2017): https://arxiv.org/abs/1703.06907
- « Survey on embodied AI for industry: from the perspective of industrial robots, » National Science Review: https://academic.oup.com/nsr/advance-article/doi/10.1093/nsr/nwag505/8767815
- « Grounding Sim-to-Real Generalization in Robotic Manipulation: An Empirical Study with Vision-Language-Action Models » (arXiv 2603.22876): https://arxiv.org/html/2603.22876
- « Bridging the Sim-to-Real Gap with Dynamic Compliance Tuning for Industrial Insertion » (arXiv 2311.07499): https://arxiv.org/html/2311.07499v3
- Zhang, « Necessity for More Realistic Contact Simulation » (Sim2Real workshop, 2020): https://sim2real.github.io/assets/papers/2020/zhang2.pdf
- « Efficiently Linking Real Scenes with Synthetic Data Generation for AI-based Cognitive Robotics and Computer Vision Applications » (arXiv 2606.20272): https://arxiv.org/html/2606.20272
- ISO 10218-1:2025, Robotics — Safety requirements — Part 1: Industrial robots: https://www.iso.org/standard/73933.html
- A3, « Updated ISO 10218 — Answers to Frequently Asked Questions »: https://www.automate.org/robotics/blogs/updated-iso-10218-faq
Images : illustrations originales créées pour AndBeyond.Tech ; aucun logo ni aucune personne réelle n’y figurent.