RoboColosseum et la course à la mesure de l’intelligence physique en conditions réelles
Ce que mesure RoboColosseum en conditions réelles : volets Open et Fine-tune, progression partielle, W de Kendall entre plateformes et résultats du Unitree G1.
Les modèles de langage ont eu leur Chatbot Arena. Pour les politiques robotiques, l’exercice est plus ardu. La réponse d’un chatbot est une chaîne de caractères que l’on peut noter ; une politique robotique est une boucle fermée avec le monde physique, où chaque action modifie l’observation suivante. L’éclairage, la position de la caméra, la disposition des objets et l’usure du matériel influent tous sur le résultat. C’est pourquoi le taux de réussite d’un laboratoire isolé, sur une série figée de tâches, ne constitue qu’un faible indicateur de l’« intelligence physique ».
RoboColosseum est une tentative, en 2026, de mesurer cet indicateur à grande échelle et en conditions réelles. L’article qui l’accompagne (Nguyen, Wang, Shailesh et al., arXiv:2611.02497) est une prépublication arXiv non évaluée par les pairs [1]. Il décrit un réseau d’évaluation distribué couvrant des bureaux, des logements, des campus et des usines, avec des opérateurs à plein temps, un service partagé d’exécution des politiques et deux volets complémentaires. L’étude initiale s’est déroulée du 17 septembre au 28 octobre 2026 et porte sur cinq politiques vision-langage-action (VLA) et trois agents d’IA de pointe, répartis sur quatre plateformes matérielles [1].
Cet article explique ce que mesure réellement ce banc d’essai, en particulier la progression partielle et le W de Kendall, et lit les résultats du Unitree G1 comme le font les auteurs : comme des résultats obtenus selon ce protocole, et non comme un verdict général sur le produit.
De RoboArena à RoboColosseum
RoboColosseum s’appuie sur RoboArena, un cadre d’évaluation distribué publié en 2025 pour les politiques généralistes sur la plateforme DROID/Franka [2]. RoboArena (Atreya, Pertsch, Lee et al., arXiv:2506.18123 ; prépublication arXiv) recueillait de manière participative des comparaisons par paires en double aveugle : les évaluateurs choisissaient librement les tâches et les scènes, exécutaient successivement deux politiques anonymisées dans des conditions locales identiques et indiquaient leur préférence. Sur 612 comparaisons par paires réalisées sur robots réels dans sept établissements universitaires, les auteurs soutenaient que l’agrégation de ces préférences classait les politiques généralistes avec plus d’exactitude qu’une batterie de tests classique, figée et menée sur un seul site, par rapport à un classement « oracle » exhaustif [2].
RoboColosseum conserve le principe des comparaisons par paires en conditions réelles et l’étend selon trois axes [1] :
- Davantage de plateformes : SO-101, Franka en configuration DROID, Bimanual-YAM et l’humanoïde Unitree G1.
- Deux volets : un Open Track (sans adaptation propre à la tâche) et un Fine-tune Track (avec un budget de démonstrations fixe).
- Une échelle opérationnelle : l’article fait état de 5 699 comparaisons par paires dans l’Open Track, réparties sur 124 sites, ainsi que d’évaluations Fine-tune portant sur 20 tâches (cinq par plateforme) [1].
Parmi les contributeurs fondateurs cités dans la prépublication figurent des équipes de la NUS, de Hugging Face, du Singapore Embodied AI Centre et de BitRobot. Le projet s’engage à offrir 10 000 heures d’évaluation gratuite à ses partenaires universitaires [1].
Les deux volets, en termes simples
Open Track : la généralisation sans réglage fin
Un évaluateur imagine une tâche réalisable avec des objets disponibles sur place, rédige une instruction en langage naturel et reçoit deux modèles éligibles anonymisés. Tous deux s’exécutent sur le même robot, dans la même configuration. L’évaluateur consigne une préférence (victoire de A, victoire de B ou égalité), des scores de progression, des commentaires libres et une note de difficulté de 1 à 10 [1].
Les tâches variant considérablement en difficulté, les taux de victoire bruts seraient trompeurs. RoboColosseum classe donc les systèmes de l’Open Track à l’aide d’un modèle de Rasch calibré sur la difficulté (DCR) : chaque politique reçoit une aptitude latente, chaque tâche une difficulté latente, et les notes de difficulté attribuées par les humains servent de loi a priori sur cette difficulté. Les résultats des essais mettent ensuite à jour l’une et l’autre. Pour le classement public, les aptitudes sont converties sur une échelle de type Elo ; cette conversion est linéaire et ne modifie pas l’ordre [1].
Un appariement actif (inspiré de Chatbot Arena) concentre les nouveaux essais sur les paires de modèles dont l’ordre reste incertain. Selon l’analyse des auteurs, l’appariement actif atteint environ 90 % de concordance avec le classement établi sur l’ensemble des données après quelque 400 à 500 évaluations, contre environ 1 000 avec un échantillonnage uniforme [1].
Fine-tune Track : l’adaptation à budget de données fixe
La question est ici différente : à partir des mêmes 100 démonstrations téléopérées par tâche, dans quelle mesure chaque VLA parvient-il à s’adapter ? Chaque politique suit sa procédure officielle de réglage fin jusqu’à convergence ; les données et le protocole d’évaluation restent identiques, tandis que les détails d’entraînement peuvent varier selon l’architecture [1]. Après le réglage fin, chaque couple politique-tâche fait l’objet de N = 25 essais d’évaluation [1].
Les tâches couvrent la prise et la dépose, l’empilement, la réorientation, les objets articulés, les objets déformables, le versement de liquides, l’utilisation d’outils, la coordination à deux bras et la loco-manipulation sur le G1 [1].
Ce que signifie la « progression partielle »
Le critère binaire de réussite est sévère. Une politique qui referme presque entièrement un ordinateur portable et une autre qui ne touche jamais l’écran obtiennent toutes deux zéro si la fermeture complète est exigée. RoboColosseum définit donc des critères de progression propres à chaque tâche, c’est-à-dire une liste d’étapes intermédiaires [1].
Pour une exécution donnée, soit K le nombre de critères et s le nombre de critères satisfaits (l’ordre n’est pas nécessairement imposé). La progression normalisée de l’exécution vaut s / K. La moyenne sur les N essais donne le score de progression (PS). Par ailleurs, le taux de réussite (SR) correspond à la proportion d’essais qui satisfont la définition complète de la réussite [1] :
- le PS répond à la question : quelle part de la tâche la politique a-t-elle accomplie en moyenne ?
- le SR répond à la question : à quelle fréquence l’a-t-elle menée à terme ?
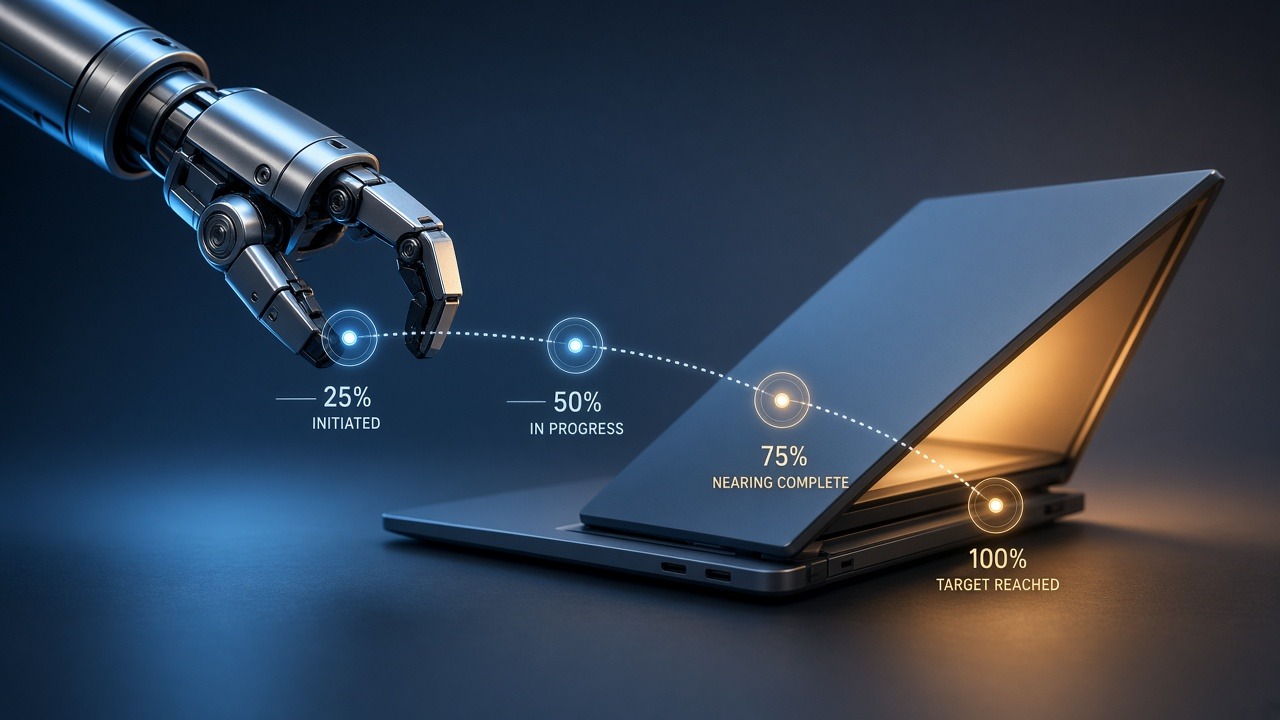
Cette distinction compte surtout sur les plateformes difficiles. Sur la série de tâches du Fine-tune Track consacrée au Unitree G1, aucune des politiques évaluées n’accomplit l’une des cinq tâches (SR = 0 % pour chaque couple modèle-tâche du tableau publié). Les scores de progression moyens permettent néanmoins de les départager : de 13,3 % à 23,2 % environ selon les cinq politiques [1]. La progression partielle est la façon dont le banc d’essai exprime que « tout le monde a échoué avant la ligne d’arrivée, mais pas tout le monde de la même manière ».
Ce que signifie le W de Kendall
Après le réglage fin, les auteurs se demandent si les mêmes politiques obtiennent des classements comparables sur les quatre séries de tâches propres à chaque plateforme. Ils font état d’un coefficient de concordance de Kendall W = 0,24 [1].
En termes simples, le W de Kendall mesure le degré d’accord entre plusieurs classements. Il va de 0 (aucun accord : les classements paraissent aléatoires les uns par rapport aux autres) à 1 (accord parfait : chaque plateforme ordonne les politiques de la même façon). Une valeur de 0,24 traduit un accord faible. Savoir quelle politique l’emporte sur SO-101 ne permet pas de prédire de manière fiable laquelle l’emportera sur Franka, Bimanual-YAM ou G1 selon ce protocole Fine-tune [1].
Quelques exemples concrets tirés des moyennes Fine-tune de la prépublication [1] :
- GR00T N1.7 arrive en tête sur SO-101 (PS moyen d’environ 89 %, SR d’environ 82 %), mais se classe en milieu de peloton sur Franka et YAM.
- π0.5 arrive en tête sur DROID/Franka (PS d’environ 91 %, SR d’environ 84 %) et sur Bimanual-YAM (PS d’environ 97 %, SR d’environ 94 %).
- Les classements s’inversent également entre l’Open Track et le Fine-tune Track sur les plateformes communes : la performance en environnement ouvert ne prédit pas de manière fiable la performance après adaptation [1].
Pour les équipes qui achètent ou affinent une politique de fondation, la leçon pratique est la suivante : l’évaluation propre à chaque plateforme et à chaque tâche reste indispensable. Un seul chiffre de classement ne suffit pas.
Lire avec prudence le résultat du Unitree G1
Le Fine-tune Track évalue cinq tâches relevant de la loco-manipulation sur un Unitree G1 configuré pour ce banc d’essai (pinces parallèles, téléopération par casque Pico VR pour les 100 démonstrations, spécifications d’observation et d’action communes à tous les sites) [1]. Scores de progression moyens publiés selon ce protocole [1] :
| Politique (Fine-tune Track, moyenne sur G1) | Score de progression (PS) | Taux de réussite (SR) |
|---|---|---|
| LingBot-VLA v2 | 23,2 % | 0 % |
| GR00T N1.7 | 22,7 % | 0 % |
| MolmoAct2 | 19,8 % | 0 % |
| π0.5 | 16,3 % | 0 % |
| G0.5 | 13,3 % | 0 % |
Ces chiffres ne constituent pas un verdict général sur le Unitree G1 en tant que produit. Ce sont les résultats de points de contrôle VLA précis, affinés pour cinq tâches de RoboColosseum, avec cette configuration matérielle, ces démonstrations, ces critères de progression et ces règles d’arrêt de sécurité [1]. Une autre pile de commande, une téléopération de qualité différente, d’autres tâches ou la pile d’autonomie propriétaire d’un fabricant pourraient donner des résultats tout autres. La lecture honnête est plus étroite : selon ce protocole Fine-tune public, les VLA généralistes actuels ne progressent que modestement sur ces tâches du G1 et ne les mènent pas à terme.
Cette lecture n’en reste pas moins utile. Elle montre pourquoi la loco-manipulation humanoïde constitue un test de résistance pour les modèles de fondation VLA, et pourquoi les indicateurs de progression ont leur place à côté des taux de réussite lorsque la ligne d’arrivée est rarement franchie.
Ce que montre par ailleurs l’Open Track
Quelques enseignements généraux de l’analyse de l’Open Track présentée dans la prépublication, chacun limité aux comparaisons recueillies [1] :
- Les agents de pointe peuvent rivaliser avec les VLA spécialisés en matière de progression en manipulation dans les comparaisons par paires, mais l’avantage dépend de l’agent et de la plateforme. Sur 901 évaluations appariées opposant un agent à un VLA, les agents ont davantage progressé dans 394 comparaisons, les VLA dans 265, avec 242 égalités [1].
- Une force relative ne garantit pas l’achèvement des tâches. Même les systèmes les mieux classés affichent souvent un faible taux de réussite absolu dans les catégories en environnement ouvert ; l’article indique qu’aucun système évalué n’a dépassé 13 % de réussite dans l’une de ses six catégories de manipulation, sur la portion de l’Open Track analysée [1].
- Les tâches plus difficiles échouent plus tôt. La réussite complète passe d’environ 30,7 % pour les difficultés notées de 1 à 4 à environ 0,4 % pour les difficultés de 9 à 10, et la progression normalisée moyenne d’environ 56,6 % à environ 3,5 % sur les mêmes tranches [1].
Avec les résultats du Fine-tune Track, ce tableau correspond à ce que de nombreux laboratoires constatent au quotidien : les démonstrations impressionnent, mais l’achèvement régulier des tâches dans des environnements variés reste rare. C’est aussi pourquoi les outils de sim-to-real et les couches de RL postérieures à l’imitation continuent de retenir l’attention.
La fiabilité du classement, une grandeur elle-même mesurée
Un banc d’essai distribué ne vaut que par la concordance entre les différentes portions de son réseau. RoboColosseum la vérifie en divisant à plusieurs reprises les sites d’évaluation en deux moitiés disjointes, en ajustant le modèle DCR sur chacune d’elles et en mesurant la fréquence à laquelle l’ordre des paires de modèles concorde [1]. Sur DROID/Franka et Bimanual-YAM, la concordance moyenne des classements par paires atteint environ 85 % (ρ de Spearman moyen d’environ 0,82). Sur SO-101, elle est plus faible, autour de 59 % avec un ρ d’environ 0,30 : l’ordre de l’Open Track sur cette plateforme dépend donc davantage des sites qui y contribuent [1].
L’échelle aide. Des sous-ensembles aléatoires de l’Open Track atteignent environ 90 % de concordance moyenne avec le classement complet fondé sur 5 699 comparaisons autour de 1 123 évaluations, et environ 95 % autour de 4 755, même si la fourchette de percentiles autour de ces moyennes reste large [1]. Autrement dit, quelques centaines d’essais par paires bien choisis suffisent, en moyenne, à retrouver une grande partie du classement, mais une stabilité de haute confiance exige encore des milliers de comparaisons physiques.
Cette honnêteté statistique fait partie de ce qui distingue un programme de mesure d’une opération de communication. Elle explique aussi l’engagement du projet à offrir des heures d’évaluation gratuites aux universitaires : une plus grande diversité de sites réduit le risque que l’éclairage et l’encombrement d’un seul laboratoire définissent l’« état de l’art » [1].
Pourquoi ce type de banc d’essai compte
RoboColosseum ne remplacera pas les études rigoureuses portant sur un seul facteur. Les auteurs le reconnaissent : la couverture dépend encore des points de contrôle et des robots en mesure de participer, le Fine-tune Track ne compte pour l’instant que cinq tâches par plateforme, et le fait d’autoriser la procédure officielle de réglage fin de chaque modèle signifie que ce volet mesure une adaptation de bout en bout à partir de données communes, et non un optimiseur rigoureusement identique [1]. L’évaluation par paires en conditions réelles sacrifie aussi une part du contrôle expérimental au profit de la diversité, le même arbitrage que celui qu’avait assumé RoboArena [2].
Il offre en revanche un étalon commun, appelé à s’enrichir. L’intelligence physique a besoin d’un tel outil si le domaine veut distinguer les vidéos promotionnelles des progrès reproductibles. La progression partielle préserve un signal lorsque les taux de réussite sont proches de zéro. Le W de Kendall met en garde contre la généralisation abusive d’une victoire obtenue sur un seul bras. Et présenter les chiffres du Unitree G1 comme des résultats conditionnés par le banc d’essai, et non comme des notes de produit, est le moyen de garder cet étalon honnête.
En résumé
RoboColosseum est moins un simple classement qu’un programme de mesure : des duels par paires en environnement ouvert, des courses de réglage fin contrôlées, des listes d’étapes de progression et des tests de concordance entre plateformes. Le premier instantané (fin 2026, en prépublication) montre déjà des agents de pointe au coude-à-coude avec les VLA, un faible accord des classements d’une plateforme à l’autre (W = 0,24) et une loco-manipulation humanoïde où la progression partielle existe sans réussite complète, selon le protocole retenu. À condition de considérer chaque chiffre comme dépendant des robots, des tâches et des règles qui l’ont produit, ce banc d’essai devient utile plutôt que spectaculaire.
À lire aussi
- Modèles vision-langage-action : la nouvelle couche de base des robots
- Sim-to-real en 2026 : combler l’écart sans données réelles à l’infini
- Après l’imitation : l’apprentissage par renforcement résiduel et en conditions réelles, nouvelle couche des politiques robotiques
Références / sources
- Tan Sang Nguyen, Yi Ru Wang, Shailesh Shailesh et al. — « RoboColosseum: Evaluating Physical Intelligence at Scale In-The-Wild », arXiv:2611.02497 (prépublication arXiv, non évaluée par les pairs). Évaluations menées du 17 septembre au 28 octobre 2026. https://arxiv.org/abs/2611.02497
- Pranav Atreya, Karl Pertsch, Tony Lee et al. — « RoboArena: Distributed Real-World Evaluation of Generalist Robot Policies », arXiv:2506.18123 (prépublication arXiv). https://arxiv.org/abs/2506.18123 · https://robo-arena.github.io
- À lire aussi : AndBeyond.Tech — Modèles vision-langage-action : la nouvelle couche de base des robots.
- À lire aussi : AndBeyond.Tech — Sim-to-real en 2026 : combler l’écart sans données réelles à l’infini.
Images : illustrations originales créées pour AndBeyond.Tech ; aucun logo ni aucune personne réelle n’y figurent.