Modelos visión-lenguaje-acción: la nueva capa base de los robots
Cómo los modelos visión-lenguaje-acción (VLA) pasaron de RT-2 a Gemini Robotics 2, π0.7 y GR00T N1.6, y por qué los modelos de mundo son la próxima capa.
Durante la mayor parte de su historia, los robots han sido especialistas brillantes y generalistas desastrosos. Un brazo de soldadura puede repetir el mismo cordón millones de veces, pero pídale que ordene una cocina que nunca ha visto y no tendrá nada que ofrecer. En los últimos tres años eso ha empezado a cambiar, y la razón tiene nombre: el modelo visión-lenguaje-acción, o VLA.
Un VLA toma los mismos ingredientes que impulsan los chatbots multimodales actuales —un modelo preentrenado con imágenes y texto a escala de internet— y le enseña a producir algo nuevo: órdenes motoras. En 2026, la idea ha pasado de ser una curiosidad de investigación a convertirse en la arquitectura por defecto de los programas robóticos más ambiciosos del sector, desde Gemini Robotics 2 de Google DeepMind hasta π0.7 de Physical Intelligence y el modelo abierto GR00T N1.6 de NVIDIA. Este artículo explica qué es la robótica VLA, cómo ha llegado hasta aquí el sector, qué papel desempeñan los modelos de mundo y qué separa todavía a un modelo fundacional para robots de un robot en el que confiaría dentro de su casa.
¿Qué es un modelo visión-lenguaje-acción?
El término lo popularizó Google DeepMind en julio de 2023 con RT-2 (Robotic Transformer 2), que DeepMind describió como un modelo VLA que «aprende tanto de datos de la web como de datos robóticos» y traduce ese conocimiento en control del robot [1]. El truco central era de una sencillez desarmante. Los modelos visión-lenguaje (VLM) ya reciben imágenes y texto y producen tokens de texto. RT-2 representaba las acciones del robot también como tokens —cadenas de números que indican si detenerse, cómo mover y girar el efector final y cuánto abrir la pinza—, de modo que un VLM podía ajustarse para «hablar» en acciones sin cambiar sus espacios de entrada ni de salida [1].
Ese planteamiento tiene tres consecuencias que siguen marcando el sector:
- Transferencia de conocimiento. Un modelo que ha visto miles de millones de imágenes de la web ya sabe cómo es un plátano, un contenedor de reciclaje o la foto de un famoso. RT-2 podía ejecutar órdenes con objetos y conceptos ausentes de sus datos robóticos, como mover un objeto sobre un número expresado como una suma («dos más uno») [1].
- Razonamiento dentro del bucle. DeepMind demostró que añadir un breve paso de «plan» en lenguaje natural antes de las acciones —una forma de cadena de pensamiento— permitía a RT-2 gestionar instrucciones de varias fases, por ejemplo elegir una piedra como martillo improvisado [1].
- Escala heredada del mundo de los modelos de lenguaje. Como un VLA es, en su arquitectura, un VLM, hereda la infraestructura de entrenamiento, las recetas de escalado y el rápido progreso del ecosistema más amplio de modelos fundacionales [2].
Los resultados fueron llamativos para la época. En más de 6.000 ensayos con robots, DeepMind informó de que RT-2 multiplicaba aproximadamente por tres el rendimiento de generalización en pruebas de habilidades emergentes frente a las referencias anteriores, y elevaba el éxito en escenarios nunca vistos del 32 % (RT-1) al 62 % [1].
De gigantes cerrados a modelos abiertos: OpenVLA
RT-2 y su sucesor multirrobot RT-2-X eran cerrados. En junio de 2024, una coalición de investigadores de Stanford, UC Berkeley, Toyota Research Institute, Google DeepMind, Physical Intelligence y el MIT publicó OpenVLA, un VLA de código abierto de 7.000 millones de parámetros entrenado con 970.000 demostraciones robóticas reales procedentes del conjunto de datos Open X-Embodiment [2].
OpenVLA se basa en un modelo de lenguaje Llama 2 con un codificador visual que fusiona características de DINOv2 y SigLIP; la parte de DINOv2 ayudaría, según los autores, con el razonamiento espacial del que depende la manipulación [2]. Su resultado principal fue que superaba en 16,5 puntos porcentuales de éxito absoluto al RT-2-X de 55.000 millones de parámetros en 29 tareas, con unas siete veces menos parámetros [2].
Igual de importantes fueron las conclusiones prácticas. Los autores demostraron que OpenVLA podía ajustarse con LoRA entrenando solo alrededor del 1,4 % de sus parámetros e igualar aun así el ajuste completo, y que la cuantización a 4 bits mantenía la tasa de éxito reduciendo la memoria de GPU a unos 7 GB [2]. El modelo completo funcionaba a unos 6 Hz en una sola RTX 4090 de consumo [2]. Dicho de otro modo, un modelo fundacional para robots competente pasaba de repente a estar al alcance de un laboratorio universitario o una start-up con hardware modesto.
El artículo de OpenVLA también era sincero sobre sus límites: solo una imagen como entrada, una inferencia demasiado lenta para un control diestro a 50 Hz y una fiabilidad normalmente inferior al 90 % en las tareas probadas [2]. Esas limitaciones se convirtieron en la hoja de ruta de la siguiente generación.
Physical Intelligence y la serie π: de los tokens al flow
Si OpenVLA democratizó los VLA, la start-up de San Francisco Physical Intelligence es probablemente la que más ha impulsado su capacidad de generalización. Su modelo π0, seguido de π0.5 en abril de 2025, se alejó de los tokens de acción puramente discretos. π0.5 combina la decodificación autorregresiva de tokens para las decisiones de alto nivel con un «experto de acción» de flow matching continuo que genera «bloques de acción» de un segundo y 50 pasos en órdenes articulares [3]. En la práctica, el modelo primero se dice a sí mismo con palabras qué hacer a continuación («coger la almohada») y luego genera trayectorias motoras suaves para hacerlo; el mismo modelo gestiona ambos niveles [3].
La lección central de π0.5 tenía que ver con la mezcla de datos más que con la arquitectura. Physical Intelligence coentrenó con datos de la web, etiquetas de subtareas de alto nivel, indicaciones verbales de personas y datos robóticos de muchos robots y entornos distintos [3]. Sus estudios de ablación mostraron que eliminar los datos de la web empeoraba el rendimiento con objetos fuera de distribución, mientras que eliminar los datos de otros robots lo empeoraba en todo [3]. Llama la atención que, a partir de unos 100 entornos de entrenamiento distintos, el rendimiento de π0.5 en viviendas completamente nuevas se acercaba al de una referencia entrenada directamente en el entorno de prueba [3].
El trabajo de la compañía en 2026 prolonga esa trayectoria. En marzo presentó Multi-Scale Embodied Memory (MEM) para tareas de más de diez minutos y un enfoque «RL Token» para un aprendizaje por refuerzo en línea más rápido en tareas de precisión [4]. En abril de 2026 lanzó π0.7, descrito como un modelo generalista «dirigible». π0.7 tiene unos 5.000 millones de parámetros: una base visión-lenguaje inicializada a partir del modelo Gemma 3 4B de Google (con un codificador visual de 400 millones de parámetros), un codificador de historial de vídeo de tipo MEM y un experto de acción de flow matching de 860 millones de parámetros. Está condicionado no solo por una orden en lenguaje natural, sino también por metadatos e imágenes de subobjetivos visuales que describen cómo realizar una tarea [5]. Physical Intelligence informa de los primeros indicios de generalización composicional: con indicaciones verbales paso a paso, π0.7 manejó electrodomésticos de cocina para los que no tenía demostraciones, como meter un boniato en una freidora de aire, y dobló ropa con un sistema bimanual de brazos industriales UR5e para el que no se habían recopilado datos de doblado [5]. La compañía afirma que un único modelo π0.7 igualó o superó a sus modelos especialistas π*0.6 entrenados con RL en doblar ropa, preparar espresso y montar cajas [5]. El 13 de octubre de 2026 abrió una beta de la Pi API, que permite a los desarrolladores subir datos, ajustar sus últimos modelos con cómputo gestionado por la empresa y ejecutar inferencia alojada en la nube en sus propios robots; los socios de acceso anticipado van desde maquinaria pesada autónoma hasta un fabricante de robots de dos brazos [6], señal de que el modelo fundacional para robots se está convirtiendo en un producto de plataforma y no solo en un artículo científico.
Gemini Robotics 2 de Google DeepMind: control de cuerpo completo
Google DeepMind, que acuñó la etiqueta VLA, ha reconstruido desde entonces su pila robótica sobre Gemini. El 30 de julio de 2026 presentó Gemini Robotics 2, una familia de tres modelos [7]:
- Gemini Robotics 2, su VLA más avanzado, que convierte entradas visuales y de lenguaje en control motor y puede dirigir humanoides completos «de los pies a la punta de los dedos», así como robots de dos brazos [7].
- Gemini Robotics ER 2, un VLM de razonamiento encarnado que actúa como planificador: entiende la escena, se comunica con las personas y planifica tareas de varios pasos que duran varios minutos e implican cientos de decisiones. También coordina varios robots que trabajan en equipo [7].
- Gemini Robotics On-Device 2, un VLA eficiente diseñado para ejecutarse localmente en el robot; DeepMind afirma que puede adaptarse a nuevos robots de dos brazos en pocas horas, normalmente con menos de 200 ejemplos [7].
Esta separación entre un modelo de razonamiento que «piensa» y un VLA que «actúa» refleja la estructura de alto y bajo nivel de π0.5, pero empaquetada como productos independientes. DeepMind mostró un único checkpoint controlando tres robots: el humanoide Apollo 2 de Apptronik con manos SharpaWave, el mismo humanoide con manos Inspire y un Franka Duo con pinzas Robotiq [7]. DeepMind afirma que el modelo puede manejar la mano SharpaWave de cinco dedos y 22 grados de libertad en tareas como hacer nudos o cerrar una bolsa con cierre zip [7]. También fue especialmente franca: la compañía reconoce que las tareas diestras de cuerpo completo y con pinza alcanzan tasas de éxito de medias a altas, mientras que la manipulación diestra con varios dedos «sigue siendo un reto» [7]. La disponibilidad es limitada: ER 2 está disponible en Google AI Studio y en versión preliminar privada en Gemini Enterprise Agent Platform, mientras que los modelos VLA y On-Device están restringidos a socios de acceso anticipado [7][8].
NVIDIA GR00T N1.6: un modelo fundacional abierto para humanoides
El enfoque de NVIDIA consiste en ofrecer la «plataforma de referencia» abierta para los fabricantes de humanoides. Su programa Isaac GR00T reúne canalizaciones de datos, simulación, bibliotecas de ejecución y el ordenador Jetson Thor en torno a un modelo fundacional abierto para robots [9]. La versión actual, GR00T N1.6, es un VLA abierto de 3.000 millones de parámetros publicado en Hugging Face [10].
GR00T N1.6 combina un modelo visión-lenguaje NVIDIA Cosmos (una variante de Cosmos-Reason-2B) con un cabezal transformer de difusión/flow matching el doble de profundo que el de su predecesor —32 capas frente a 16— y predice bloques de acción relativos al estado en lugar de ángulos articulares absolutos [11][12]. Su mezcla de preentrenamiento añadió varios miles de horas de datos teleoperados de brazos bimanuales, del AgiBot Genie-1, de robots simulados y de locomanipulación de cuerpo completo en el Unitree G1, y NVIDIA afirma que supera a N1.5 tanto en simulación como en robots reales [11]. La descripción que hace la propia compañía de su receta de datos es reveladora: vídeo humano a escala de internet para el conocimiento del mundo, teleoperación real para el anclaje físico y datos sintéticos para escalar de forma segura [9].
La apertura importa. NVIDIA indica que los modelos GR00T están disponibles en la biblioteca LeRobot de Hugging Face para su ajuste y evaluación, y que el humanoide de código abierto Reachy 2 de Hugging Face ejecutará VLA, entre ellos GR00T N1.6, en Jetson Thor [13]. Para las start-ups de humanoides que no pueden entrenar un modelo de vanguardia desde cero, esto equivale a partir de un LLM de pesos abiertos.
Qué papel desempeñan los modelos de mundo
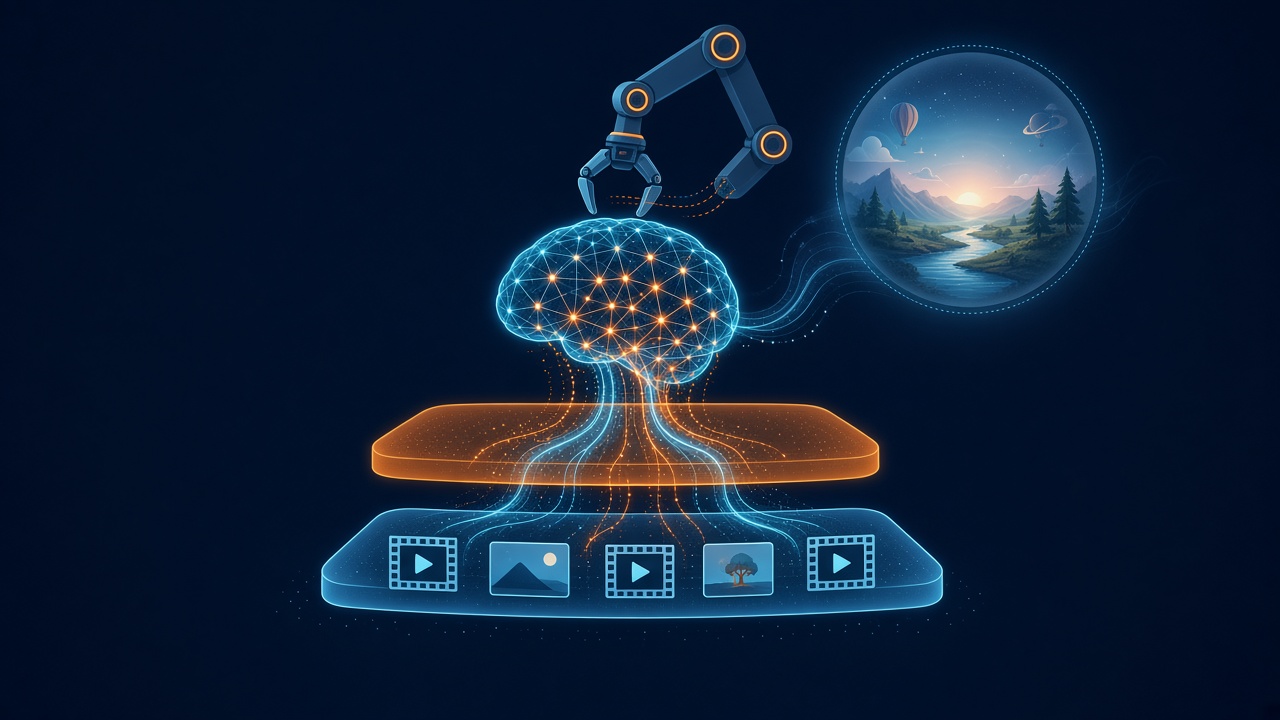
Los VLA asignan observaciones directamente a acciones. Los modelos de mundo siguen un camino complementario: aprenden a predecir cómo cambiará el mundo y permiten al robot planificar imaginando las consecuencias antes de actuar.
V-JEPA 2 de Meta, publicado en 2025, es un ejemplo claro. Se preentrenó de forma autosupervisada con más de un millón de horas de vídeo de internet y después se postentrenó como modelo condicionado por la acción (V-JEPA 2-AC, un transformer de 300 millones de parámetros) con menos de 62 horas de vídeo robótico sin etiquetar del conjunto de datos DROID [14]. Desplegado en modo zero-shot en brazos Franka de dos laboratorios que no figuraban en sus datos de entrenamiento, planificó agarres y tareas de pick-and-place a partir de imágenes objetivo, sin entrenamiento específico para la tarea ni recompensas [14]. Meta informa de un éxito del 65-80 % en pick-and-place de objetos nuevos en entornos desconocidos, mediante control predictivo: el robot imagina acciones candidatas, las puntúa frente a la imagen objetivo, ejecuta la mejor y vuelve a planificar [15].
NVIDIA aborda los modelos de mundo desde la simulación. Sus Cosmos Predict 2.5 y Cosmos Transfer 2.5 son modelos de mundo abiertos para la generación de datos sintéticos basados en la física y para evaluar políticas robóticas en simulación, junto al VLM Cosmos Reason 2, que también alimenta a GR00T [13]. En el flujo sim-to-real de NVIDIA para GR00T N1.6, el aprendizaje por refuerzo de cuerpo completo en Isaac Lab produce primitivas de movimiento que se transfieren en modo zero-shot a humanoides físicos, mientras el VLA las coordina [12].
El patrón que emerge es de convergencia más que de competencia. Los modelos de mundo aportan experiencia barata y escalable y una forma de «pensar por adelantado»; los VLA aportan un control rápido y reactivo anclado en el lenguaje. Cabe esperar que la frontera entre ambos se difumine aún más a medida que los VLA ganen memoria y planificación (como en el trabajo MEM de π [4]) y los modelos de mundo incorporen cabezales de acción.
Por qué los VLA se están convirtiendo en la capa base
En conjunto, el panorama de 2026 explica por qué «capa base» es la metáfora adecuada:
- Un modelo, muchos cuerpos. El entrenamiento con múltiples plataformas físicas ya es la norma. Gemini Robotics 2 ejecuta un solo checkpoint en humanoides y brazos [7]; GR00T N1.6 cubre el Unitree G1, el AgiBot Genie-1, el Fourier GR-1 y configuraciones bimanuales [9]; π0.5 ganó sobre todo con datos recopilados en otros robots [3].
- Adaptación en lugar de programación. OpenVLA demostró el ajuste con LoRA en una sola GPU [2]; Gemini Robotics On-Device 2 asegura adaptarse a nuevos robots de dos brazos en pocas horas, normalmente con menos de 200 ejemplos [7]; la Pi API convierte el ajuste en un servicio alojado [6].
- El lenguaje como interfaz. Todos los grandes modelos aceptan instrucciones en lenguaje natural, desde objetivos de alto nivel («limpia el dormitorio») hasta movimientos concretos [3].
- Jerarquía. Una capa de razonamiento que planifica y una capa motora que actúa: explícita en Gemini Robotics ER 2 más el VLA [7], implícita en las subtareas que π0.5 se genera a sí mismo [3] y en el uso de Cosmos Reason por parte de GR00T para descomponer tareas [12].
Qué sigue frenando la robótica VLA
Las advertencias más honestas proceden de los propios desarrolladores:
- Fiabilidad. OpenVLA solía quedarse por debajo del 90 % de éxito [2]; Physical Intelligence admite que π0.5 «comete errores a menudo», tanto en el plano semántico como en el motor [3]; DeepMind considera que la destreza con varios dedos sigue siendo un reto [7]. En hogares, hospitales o fábricas, una tasa de fallos del 10 % no es un error de redondeo.
- Datos. Incluso los grandes conjuntos de datos de manipulación contienen entre unos 100.000 y un millón de ejemplos, órdenes de magnitud por debajo del texto y las imágenes a escala web [2]. Por eso los datos sintéticos, los modelos de mundo y la puesta en común de datos de distintos robots son tan centrales.
- Velocidad y cómputo. El control de alta frecuencia (los autores de OpenVLA citan sistemas bimanuales a 50 Hz) exige una inferencia más rápida que la de los primeros VLA [2], lo que empuja al sector hacia los bloques de acción, el flow matching y los modelos en el dispositivo.
- Acceso. Los modelos propietarios más capaces, como Gemini Robotics 2, siguen en versión preliminar privada [8], mientras que los modelos abiertos van por detrás en algunas capacidades.
Conclusión
En poco más de tres años, el modelo visión-lenguaje-acción ha pasado de ser un replanteamiento ingenioso —«tratar las acciones como palabras»— a convertirse en el principio organizador del aprendizaje robótico moderno. RT-2 demostró que el conocimiento de la web podía llegar a la pinza; OpenVLA hizo el enfoque abierto y asequible; π0.5 y π0.7 mostraron que unos datos variados y unas indicaciones dirigibles desbloquean la generalización a nuevas viviendas y tareas; Gemini Robotics 2 y GR00T N1.6 lo extendieron al cuerpo completo de los humanoides. Modelos de mundo como V-JEPA 2 y Cosmos añaden por debajo imaginación y experiencia sintética.
Ninguno de estos sistemas es todavía un ayudante doméstico fiable. Pero la arquitectura del modelo fundacional para robots ya está clara, las herramientas son cada vez más abiertas y los problemas pendientes —fiabilidad, datos y velocidad— son de los que la escala, la ingeniería y el tiempo suelen ir resolviendo. Para quien siga la autonomía, la robótica VLA ya no es un nicho que vigilar: es la capa sobre la que se construirá todo lo demás.
Lecturas relacionadas
- Sim-to-real en 2026: cerrar la brecha sin datos reales infinitos
- Edge encarnado: IA sin conexión para robots y vehículos
- Humanoides en la fábrica: de los vídeos de demostración a turnos completos
Referencias / fuentes
- Google DeepMind — «RT-2: New model translates vision and language into action» (28 July 2023). https://deepmind.google/discover/blog/rt-2-new-model-translates-vision-and-language-into-action/
- Kim, Pertsch, Karamcheti et al. — «OpenVLA: An Open-Source Vision-Language-Action Model», arXiv:2406.09246. https://arxiv.org/abs/2406.09246
- Physical Intelligence — «π0.5: a VLA with Open-World Generalization» (22 April 2025). https://www.physicalintelligence.company/blog/pi05
- Physical Intelligence — homepage research updates (MEM, RL Token, 2026). https://www.pi.website/
- Physical Intelligence — «π0.7: a Steerable Model with Emergent Capabilities», blog (16 April 2026), and technical paper arXiv:2604.15483. https://arxiv.org/html/2604.15483 · https://www.pi.website/blog/pi07
- Physical Intelligence — «Frontier Models for Every Robot: Announcing our API beta» (13 October 2026). https://www.pi.website/blog/api-beta
- Google DeepMind — «Gemini Robotics 2 brings whole body intelligence to robots» (30 July 2026). https://deepmind.google/blog/gemini-robotics-2-brings-whole-body-intelligence-to-robots/
- Google DeepMind — Gemini Robotics 2 model page. https://deepmind.google/models/gemini-robotics/vla/
- NVIDIA Developer — Isaac GR00T. https://developer.nvidia.com/isaac/GR00t
- Hugging Face — nvidia/GR00T-N1.6-3B model card. https://huggingface.co/nvidia/GR00T-N1.6-3B
- NVIDIA GEAR Lab — «GR00T N1.6: An Improved Open Foundation Model for Generalist Humanoid Robots» (15 December 2025). https://research.nvidia.com/labs/gear/gr00t-n1_6/index.html
- NVIDIA Technical Blog — «Building Generalist Humanoid Capabilities with NVIDIA Isaac GR00T N1.6 Using a Sim-to-Real Workflow» (8 January 2026). https://developer.nvidia.com/blog/building-generalist-humanoid-capabilities-with-nvidia-isaac-gr00t-n1-6-using-a-sim-to-real-workflow/
- NVIDIA — «NVIDIA Releases New Physical AI Models as Global Socios Unveil Next-Generation Robots» (press release). https://investor.nvidia.com/news/press-release-details/2026/NVIDIA-Releases-New-Physical-AI-Models-as-Global-Partners-Unveil-Next-Generation-Robots/
- Meta FAIR — «V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning», arXiv:2506.09985. https://arxiv.org/html/2506.09985
- Meta AI — «Introducing the V-JEPA 2 world model and new benchmarks for physical reasoning». https://ai.fb.com/blog/v-jepa-2-world-model-benchmarks/
Créditos de imagen: ambas ilustraciones (vla-hero.jpg, vla-stack.jpg) se han generado con IA para AndBeyond.Tech, conforme al BP §5.2. Texto original; cifras parafraseadas y atribuidas conforme al §5.1.
Imágenes: ilustraciones originales creadas para AndBeyond.Tech; no aparecen logotipos ni personas reales.