Fábricas de datos para la IA física: cómo los datos sintéticos aceleran los robots industriales
Qué es una fábrica de datos de IA física, cómo los datos sintéticos de NVIDIA Cosmos aceleran los robots industriales y dónde falla el sim-to-real.
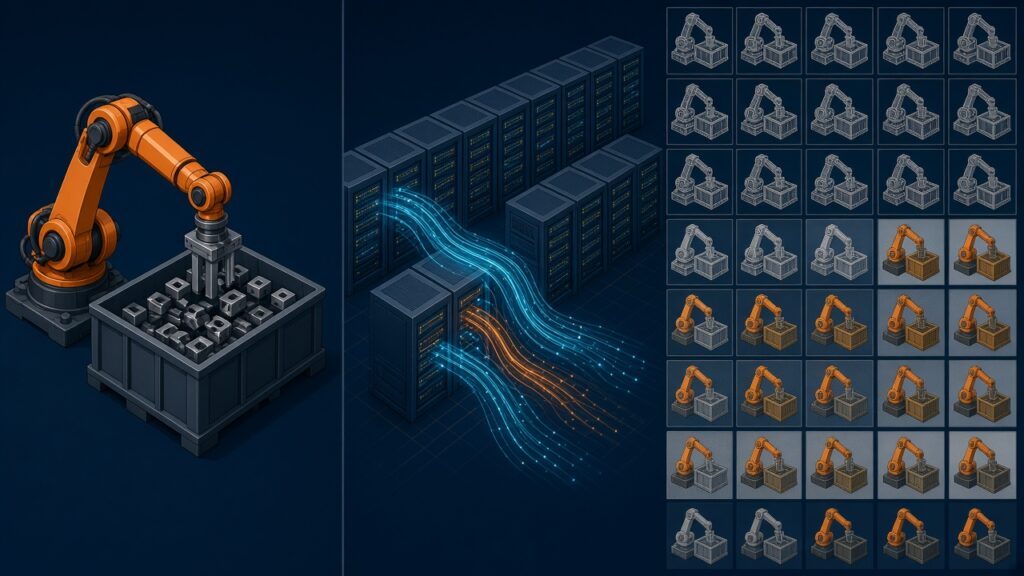
A los robots industriales nunca les ha faltado capacidad de cómputo. Les han faltado ejemplos. Un sistema de bin picking guiado por visión necesita ver miles de posiciones de piezas con una iluminación cambiante. Un modelo de inspección necesita defectos que, en una línea bien gestionada, casi nunca se producen. Una política de manipulación para un nuevo paso de montaje requiere horas de demostraciones que alguien tiene que teleoperar, etiquetar y depurar. Para la mayoría de los fabricantes, es ese cuello de botella de datos —y no el precio de una GPU o de un brazo robótico— lo que convierte un piloto prometedor en un proyecto estancado.
Ese es el problema que pretende resolver la fábrica de datos de IA física. La expresión, impulsada con fuerza por NVIDIA a lo largo de 2026, describe una cadena industrializada que toma un número limitado de grabaciones reales y las convierte en grandes conjuntos de entrenamiento etiquetados y validados para robots, agentes de visión con IA y máquinas autónomas. En su GTC de marzo, NVIDIA lo planteó sin rodeos: en palabras de Rev Lebaredian, su vicepresidente de Omniverse y tecnologías de simulación, «el cómputo es datos».
Ese eslogan merece un análisis. Este artículo examina qué contiene realmente una fábrica de datos, cómo encajan los flujos de datos sintéticos en robótica con técnicas sim-to-real más antiguas como la aleatorización de dominio, qué cuentan los primeros usuarios y dónde el enfoque sigue chocando con los límites duros de la física, los defectos raros y la certificación de seguridad.
Qué significa «fábrica de datos» para el aprendizaje robótico
En la IA de software, los datos de entrenamiento se extrajeron de la web a una escala enorme. La IA física no tiene un equivalente. Los datos robóticos son caros de recopilar, específicos de un brazo, una pinza, un conjunto de sensores y una disposición de célula concretos, y a menudo peligrosos de obtener en los escenarios que más importan: colisiones, derrames, piezas que caen, personas que entran en la zona de trabajo. Un estudio reciente sobre IA encarnada para la industria publicado en National Science Review describe los conjuntos de datos industriales como escasos, desequilibrados y estrechamente ligados a equipos concretos, con los eventos raros y las condiciones de tolerancias estrictas sistemáticamente infrarrepresentados.
Una fábrica de datos trata esa escasez como un problema de producción. En lugar de recopilarlo todo físicamente, los equipos ejecutan una cadena repetible con etapas diferenciadas:
- Seleccionar y buscar en grabaciones y registros de sensores existentes para encontrar los fragmentos adecuados, eliminar duplicados y anotarlos.
- Aumentar y multiplicar esos fragmentos, cambiando la iluminación, la meteorología, las texturas, los fondos o el aspecto de los objetos sin alterar la geometría de la escena.
- Generar nuevas muestras, ya sea mediante simulación física de una escena 3D o con modelos de mundo generativos condicionados por entradas reales.
- Etiquetar automáticamente, ya que los datos sintéticos y aumentados pueden incluir una verdad de referencia (cajas delimitadoras, máscaras, poses, trayectorias) que, de otro modo, tendrían que dibujar personas.
- Evaluar y filtrar la salida generada, descartando las muestras físicamente inverosímiles o irrelevantes antes de que lleguen al entrenamiento.
La metáfora de la «fábrica» es importante porque cada etapa debe orquestarse, escalarse y supervisarse como una línea de producción, con un rendimiento limitado sobre todo por la capacidad de aceleradores disponible. Por eso este tema pertenece tanto a los aceleradores y chips de IA como al aprendizaje robótico: el argumento económico es que las horas de GPU pueden sustituir una parte de las horas de demostración humana y del tiempo de pruebas físicas.
Dentro del blueprint de NVIDIA: de PAIDF a Cosmos Fábrica de datos
NVIDIA anunció su Physical AI Fábrica de datos Blueprint el 16 de marzo de 2026 como una arquitectura de referencia abierta para generar, aumentar y evaluar datos de entrenamiento para robótica, agentes de visión con IA y vehículos autónomos. Según el comunicado de la compañía, el blueprint organiza el trabajo en tres flujos principales basados en sus modelos fundacionales de mundo NVIDIA Cosmos:
- Cosmos Curator procesa, depura y anota grandes conjuntos de datos reales y sintéticos.
- Cosmos Transfer amplía los datos seleccionados en versiones más variadas —distintos entornos, iluminaciones y condiciones— para cubrir los escenarios de cola larga.
- Cosmos Evaluator, basado en el modelo Cosmos Reason, puntúa y filtra los datos generados según su exactitud física antes de usarlos para entrenar.
La orquestación funcionaba inicialmente con NVIDIA OSMO, un marco de flujos de trabajo de código abierto que, según NVIDIA, se integraría con agentes de programación. Microsoft Azure y Nebius figuraban como las primeras plataformas en la nube que ofrecían el blueprint, y NVIDIA citaba a FieldAI, Hexagon Robotics, Linker Vision, Milestone Systems, RoboForce, Skild AI, Teradyne Robotics y Uber entre los primeros usuarios.
Desde entonces, el proyecto ha cambiado de nombre. El repositorio público de GitHub lo denomina ahora NVIDIA Cosmos Fábrica de datos (CDF), y su guía de migración explica dos cambios simultáneos: el nombre y el paso a Apache Airflow como capa única de orquestación, con Kubernetes como backend de ejecución para todos los blueprints y OSMO conservado como backend para algunos. Para los equipos de ingeniería que evalúan la pila, este detalle es práctico más que estético: Airflow y Kubernetes son herramientas que muchos equipos de TI y de datos de planta ya utilizan.
El repositorio enumera cinco blueprints de referencia:
| Blueprint | Qué hace (según el repositorio de NVIDIA) | Relevancia para la robótica industrial |
|---|---|---|
| Defect Image Generation | Convierte referencias de componentes de PCB, metal y vidrio en imágenes simuladas y luego añade defectos generados | Modelos de inspección cuando escasean las muestras reales de defectos |
| Event Video Generation | Convierte una imagen semilla en vídeos anotados de eventos raros como incendios o caídas | Supervisión de seguridad, detección de anomalías en células y almacenes |
| Video Data Augmentation | Vuelve a renderizar grabaciones existentes con distintas iluminaciones, meteorologías y condiciones ambientales manteniendo la estructura de la escena | Robustez de robots móviles y de emplazamientos exteriores o con iluminación mixta |
| Image Attribute Augmentation | Varía los atributos de apariencia de recortes de personas | Reidentificación de personas cerca de los robots |
| Autonomous Vehicle Dataset Generation | Recupera fragmentos de conducción similares y genera variantes | Menos directamente industrial; útil para la autonomía en patios y logística |
Por debajo hay «skills» reutilizables: generación de anomalías a partir de unos pocos ejemplos, aumento, etiquetado automático, selección y recuperación, orquestación y un skill de Simulation que renderiza imágenes etiquetadas a partir de escenas 3D con Isaac Sim y Omniverse Replicator. Este último componente recuerda que la fábrica de datos no se limita al vídeo generativo: el renderizado físico clásico de un gemelo digital sigue formando parte del conjunto de herramientas.
En una actualización de octubre de 2026, NVIDIA indicó que Cosmos Fábrica de datos estaba disponible a través de GitHub, Microsoft Azure, Nebius y CoreWeave, y que Cosmos Curator admitía ya entradas multimodales y multisensor.
De los píxeles al movimiento: trayectorias sintéticas para la manipulación
Los datos de percepción son la mitad fácil. Enseñar a un robot cómo moverse requiere datos de acción: trayectorias articulares o comandos del efector final emparejados con observaciones. El blueprint Isaac GR00T-Dreams de NVIDIA, basado en Cosmos, aborda ese problema con un proceso de cinco pasos descrito en un blog técnico de NVIDIA:
- Recopilar un pequeño conjunto de demostraciones teleoperadas de una tarea en un entorno y usarlas para postentrenar un modelo de mundo Cosmos Predict con el robot concreto.
- Indicar al modelo ajustado una imagen inicial y nuevas instrucciones en lenguaje natural para generar muchos vídeos («sueños») de tareas nuevas.
- Usar Cosmos Reason para descartar los sueños fallidos o defectuosos.
- Ejecutar un modelo de dinámica inversa que infiere las acciones entre pares de fotogramas y convierte el vídeo 2D en «trayectorias neuronales».
- Entrenar una política visomotora con esas trayectorias, solas o en coentrenamiento con datos reales.
La investigación en la que se basa, publicada como DreamGen, informa de que un robot humanoide aprendió 22 comportamientos nuevos en entornos conocidos y desconocidos usando datos de teleoperación de una única tarea de pick-and-place. El repositorio de código abierto admite varias plataformas físicas, entre ellas el brazo Franka Panda, el humanoide Fourier GR1 y el brazo de bajo coste SO-100.
Para los lectores del sector industrial, el matiz importante está en el propio Cosmos Cookbook de NVIDIA. Su receta de GR00T-Dreams señala que las trayectorias generadas pueden ser físicamente plausibles y aun así diferir de los datos de robots reales; que el crítico Cosmos Reason es «un indicador aproximado» de la plausibilidad física y no un oráculo de verdad de referencia; y que los resultados son mejores en configuraciones parecidas a los datos de manipulación con los que se entrenó el modelo. Estas salvedades no son notas al pie: definen dónde encaja hoy la técnica.
Sim-to-real y aleatorización de dominio: los cimientos más antiguos
Los datos sintéticos en robótica no empezaron con los modelos de mundo. La referencia canónica es un artículo de 2017 de Josh Tobin y sus colegas de OpenAI y UC Berkeley, que introdujo la aleatorización de dominio para la transferencia sim-to-real. En lugar de intentar que un simulador fuera perfectamente realista, los autores aleatorizaron texturas, iluminación, posiciones de cámara y objetos de distracción de forma tan intensa que «el mundo real puede parecerle al modelo una variante más». Su detector de objetos, entrenado solo con imágenes simuladas no realistas, localizaba objetos reales con un margen de aproximadamente 1,5 cm y se utilizó para guiar el agarre en entornos desordenados.
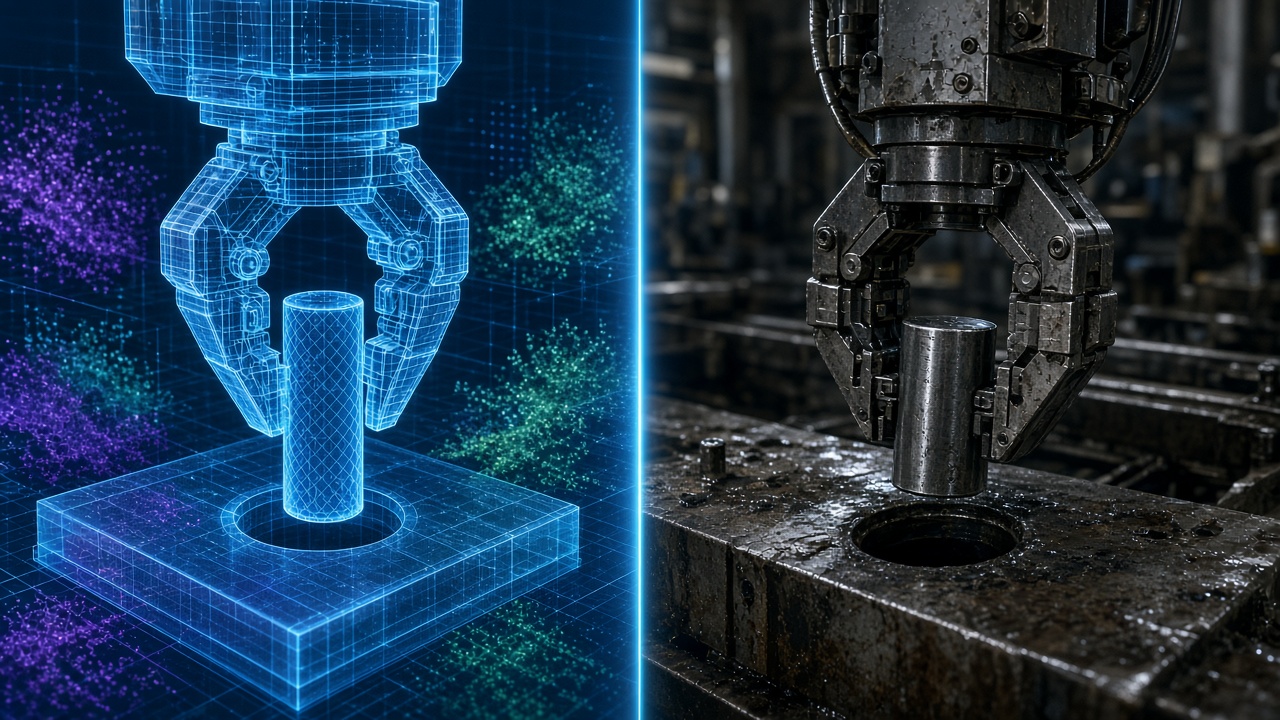
Las fábricas de datos modernas combinan ambas filosofías. Las herramientas basadas en física, como Isaac Sim con Replicator, proporcionan etiquetas exactas y una aleatorización controlable. Los modelos generativos, como Cosmos Transfer, añaden variación fotorrealista anclada en grabaciones reales, lo que puede reducir la brecha de apariencia que deja abierta la aleatorización pura. Y los evaluadores intentan detectar las muestras generadas que incumplen las leyes físicas.
Un estudio empírico de 2026 sobre la generalización sim-to-real de los modelos visión-lenguaje-acción formula con precisión la pregunta pendiente: ¿cuánto aportan al rendimiento en el mundo real la aleatorización multinivel, el renderizado fotorrealista, el realismo físico y las actualizaciones por aprendizaje por refuerzo? La respuesta honesta, en el conjunto de la literatura, es que depende mucho de la tarea. Las brechas de apariencia son cada vez más abordables. Las brechas de dinámica, no.
Qué cuentan los primeros usuarios y cómo interpretarlo
La actualización de Cosmos de octubre de 2026 de NVIDIA recoge varios despliegues. Todas las cifras que siguen proceden de los proveedores y AndBeyond.Tech no las ha verificado de forma independiente:
- ANYbotics generó más de 1.500 vídeos sintéticos con los blueprints de Cosmos Fábrica de datos, seleccionando datos reales y validando los resultados con la plataforma de Encord, para entrenar a sus robots de inspección industrial a detectar derrames de líquidos y otros cambios entre rondas por las instalaciones.
- Ultralytics volvió a entrenar un detector YOLO con imágenes reales y defectos sintéticos específicos y, según NVIDIA, mejoró la localización de defectos y la exhaustividad. El anuncio no publicó cifras.
- Fogsphere, en colaboración con ADNOC, utiliza la fábrica de datos para generar datos de entrenamiento sintéticos sobre riesgos de seguridad poco frecuentes, de modo que no haya que recrearlos físicamente.
- En automoción, Porsche está construyendo un ciclo de datos (data flywheel) compartido para la conducción autónoma entre las marcas del Grupo Volkswagen; NVIDIA afirma que se espera que reduzca hasta un 90 % las pruebas de conducción físicas repetidas y acorte los ciclos de desarrollo hasta un 85 %. Son proyecciones, no resultados medidos.
El patrón es revelador. Los casos industriales más concretos son tareas de percepción —inspección, detección de anomalías, reconocimiento de riesgos— en las que imágenes o vídeos sintéticos complementan una base real. Eso coincide con el ámbito en el que los datos sintéticos tienen una trayectoria más larga. Las afirmaciones sobre políticas de manipulación generalistas entrenadas en gran medida con datos generados siguen perteneciendo sobre todo a la investigación y a los primeros pilotos.
Las realidades del despliegue industrial
Para un equipo de ingeniería de planta, adoptar una fábrica de datos tiene menos que ver con los modelos que con la infraestructura y la gobernanza.
Los activos digitales son el billete de entrada. La generación basada en física necesita CAD, materiales y disposiciones de célula precisos; el aumento generativo necesita grabaciones reales representativas. Muchas plantas existentes no disponen de ninguna de las dos cosas en un formato limpio.
El cómputo es una partida presupuestaria, no un recurso gratuito. El argumento de que «el cómputo es datos» presupone acceso a clústeres de GPU, ya sea en las propias instalaciones o a través de nubes como Azure, Nebius o CoreWeave. La generación best-of-N seguida de un filtrado por crítico, como señala el Cosmos Cookbook, multiplica el coste de cómputo. Los equipos deben compararlo con el coste de, simplemente, recopilar más datos reales en una línea preparada para ello.
La trazabilidad de los datos debe estar garantizada. Cuando un modelo falla en planta, los ingenieros necesitan saber qué lotes sintéticos, qué prompts y qué versiones de modelo lo condicionaron. Las herramientas de pipeline como Airflow ayudan, pero solo si se impone el control de versiones.
Los datos reales nunca desaparecen. Todos los flujos creíbles —desde el trabajo de aleatorización de Tobin hasta el coentrenamiento de GR00T-Dreams— mantienen los datos reales como ancla, como conjunto de prueba o como ambas cosas. La investigación que vincula escenas reales con generación sintética llega a la misma conclusión: los datos sintéticos funcionan mejor como fuente complementaria de la captura real.
Los límites de los datos sintéticos: una lista de comprobación práctica
Antes de apostar una línea por los datos sintéticos, compruebe estos modos de fallo.
La brecha de dominio en el contacto y la dinámica
El renderizado ha mejorado más deprisa que la física. Un artículo de posición de 2020 sobre simulación de contacto señalaba que los simuladores robóticos habituales modelan el contacto como puntos únicos, mientras que el contacto real es distribuido, y que la fricción, los materiales deformables y los cuerpos blandos siguen siendo difíciles de reproducir. La investigación sobre inserción industrial muestra por qué importa: las holguras de montaje estrictas pueden bajar de 0,1 mm, donde pequeños errores de modelado deciden entre el éxito y el atasco. El vídeo generativo no resuelve esto: aprende cómo se ve el movimiento, no las fuerzas implicadas. Cuente con que las tareas con mucho contacto requerirán ajuste fino en el mundo real, control por complianza o identificación del sistema.
Defectos raros y los «desconocidos desconocidos»
Los generadores pueden multiplicar los tipos de defectos que alguien ya les ha mostrado. No pueden inventar el modo de fallo que nadie ha visto, y pueden introducir artefactos que un modelo aprenda a explotar. Reserve un conjunto de defectos reales para la validación, mida los defectos escapados en ese conjunto y desconfíe de las mejoras obtenidas solo con datos sintéticos. El mantenimiento de la cadena también supone un trabajo real: el estudio sobre IA encarnada industrial señala que los modelos de contacto y de materiales de alta fidelidad son costosos de mantener actualizados a medida que cambian los productos, los utillajes y los estados de desgaste.
Los evaluadores filtran, no certifican
Los críticos automáticos como Cosmos Evaluator y Cosmos Reason mejoran la calidad de los conjuntos de datos, pero la propia documentación de NVIDIA define al crítico como un indicador aproximado que puede pasar por alto detalles físicos finos. Un vídeo verosímil no es un vídeo validado.
La validación de seguridad sigue siendo física
Los datos sintéticos pueden ampliar la cobertura del entrenamiento y apoyar las pruebas de escenarios, pero no cambian quién es responsable de la seguridad. La ISO 10218-1:2025 y la ISO 10218-2:2025, las normas revisadas de seguridad de robots industriales publicadas en 2025, abarcan el diseño de robots y la integración de células robotizadas, incluida la seguridad funcional y las aplicaciones colaborativas antes tratadas en la ISO/TS 15066. La evaluación de riesgos, la verificación de las funciones de seguridad y la puesta en marcha siguen realizándose con hardware real. Un componente aprendido de percepción o de movimiento necesita sus propias pruebas de validación con datos reales, separadas de cualquier capa de seguridad certificada.
Perspectivas: una disciplina de producción, no un atajo
La fábrica de datos de IA física se entiende mejor como una disciplina de producción en plena maduración para los datos de entrenamiento de robots. NVIDIA ha reunido una cadena de herramientas abierta y coherente —Cosmos Curator, Transfer, Reason y Evaluator, Isaac Sim y Replicator, GR00T-Dreams— y la ha trasladado a herramientas de orquestación que los equipos empresariales ya conocen. Los primeros usos industriales en inspección y detección de anomalías parecen sensatos y de bajo riesgo.
Lo que no hace es eliminar la brecha con la realidad. Para los fabricantes, el camino pragmático a finales de 2026 consiste en empezar donde los datos sintéticos han demostrado su valor —percepción, aumento de defectos raros, robustez ante la iluminación y el entorno—, mantener un conjunto de validación real riguroso y tratar las trayectorias de manipulación generadas como un complemento prometedor de las demostraciones reales y de las pruebas físicas de seguridad, no como su sustituto. El cómputo puede producir datos. Solo la planta puede decir si esos datos eran correctos.
Lecturas relacionadas
- Sim-to-real en 2026: cerrar la brecha sin datos reales infinitos
- Cobots con IA y visión: donde las fábricas ven antes el ROI
- Modelos visión-lenguaje-acción: la nueva capa base de los robots
Referencias / fuentes
- NVIDIA press release, «NVIDIA Announces Open Physical AI Fábrica de datos Blueprint to Accelerate Robotics, Vision AI Agents and Autonomous Vehicle Development» (16 March 2026): https://investor.nvidia.com/news/press-release-details/2026/NVIDIA-Announces-Open-Physical-AI-Data-Factory-Blueprint-to-Accelerate-Robotics-Vision-AI-Agents-and-Autonomous-Vehicle-Development/default.aspx
- NVIDIA Blog, «NVIDIA GTC Showcases Virtual Worlds Powering the Physical AI Era»: https://blogs.nvidia.com/blog/gtc-2026-virtual-worlds-physical-ai/
- NVIDIA Blog, «NVIDIA Cosmos Opens New Tools to Train, Evaluate and Deploy World Models» (21 October 2026): https://blogs.nvidia.com/blog/cosmos-open-train-evaluate-deploy-world-models/
- NVIDIA Cosmos Fábrica de datos repository (GitHub): https://github.com/NVIDIA/cosmos-data-factory
- Cosmos Fábrica de datos migration guide (PAIDF → CDF, Airflow orchestration): https://github.com/NVIDIA/cosmos-data-factory/blob/main/MIGRATION.md
- NVIDIA Technical Blog, «Enhance Robot Learning with Synthetic Trajectory Data Generated by World Foundation Models»: https://developer.nvidia.com/blog/enhance-robot-learning-with-synthetic-trajectory-data-generated-by-world-foundation-models/
- NVIDIA GR00T-Dreams repository (GitHub): https://github.com/nvidia/GR00T-dreams
- Cosmos Cookbook, «Leveraging World Foundation Models for Synthetic Trajectory Generation in Robot Learning»: https://nvidia-cosmos.github.io/cosmos-cookbook/recipes/end2end/gr00t-dreams/post-training.html
- Jang et al., «DreamGen: Unlocking Generalization in Robot Learning through Video World Models» (arXiv 2505.12705): https://arxiv.org/html/2505.12705v2
- Tobin et al., «Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World» (arXiv 1703.06907, IROS 2017): https://arxiv.org/abs/1703.06907
- «Survey on embodied AI for industry: from the perspective of industrial robots,» National Science Review: https://academic.oup.com/nsr/advance-article/doi/10.1093/nsr/nwag505/8767815
- «Grounding Sim-to-Real Generalization in Robotic Manipulation: An Empirical Study with Vision-Language-Action Models» (arXiv 2603.22876): https://arxiv.org/html/2603.22876
- «Bridging the Sim-to-Real Gap with Dynamic Compliance Tuning for Industrial Insertion» (arXiv 2311.07499): https://arxiv.org/html/2311.07499v3
- Zhang, «Necessity for More Realistic Contact Simulation» (Sim2Real workshop, 2020): https://sim2real.github.io/assets/papers/2020/zhang2.pdf
- «Efficiently Linking Real Scenes with Synthetic Data Generation for AI-based Cognitive Robotics and Computer Vision Applications» (arXiv 2606.20272): https://arxiv.org/html/2606.20272
- ISO 10218-1:2025, Robotics — Safety requirements — Part 1: Industrial robots: https://www.iso.org/standard/73933.html
- A3, «Updated ISO 10218 — Answers to Frequently Asked Questions»: https://www.automate.org/robotics/blogs/updated-iso-10218-faq
Imágenes: ilustraciones originales creadas para AndBeyond.Tech; no aparecen logotipos ni personas reales.