Sim-to-real en 2026: cerrar la brecha sin datos reales infinitos
Sim-to-real en robótica en 2026: aleatorización de dominio, MuJoCo e Isaac Lab, gemelos digitales y datos sintéticos de modelos de mundo como Cosmos.
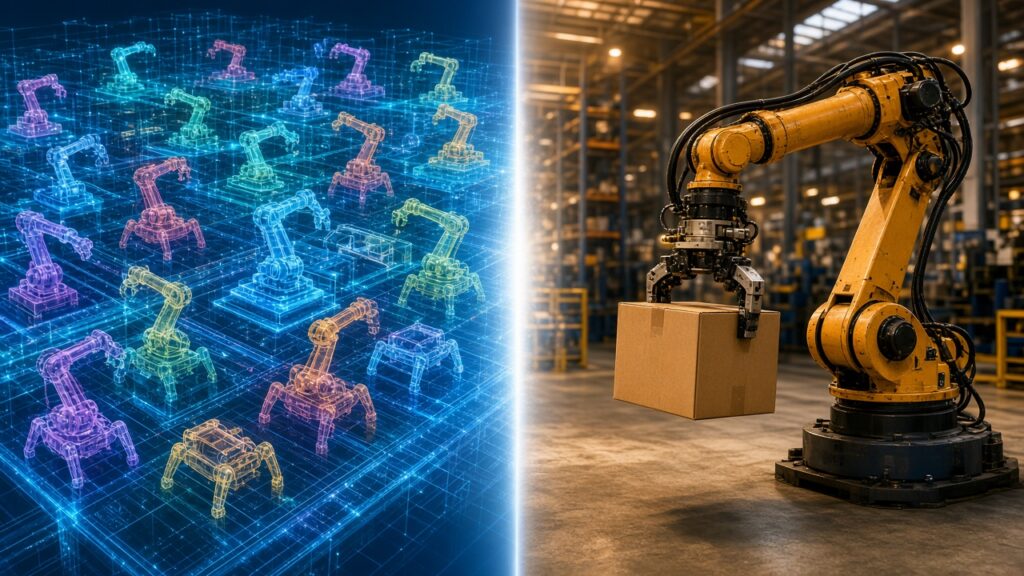
Todo equipo de aprendizaje robótico acaba chocando con el mismo muro: los datos. Los modelos de lenguaje pueden entrenarse con una gran parte del internet público, pero nadie tiene un archivo del tamaño de internet con robots que agarran, caminan, se caen y se recuperan. Reunir esa experiencia en hardware físico es lento, caro y a veces peligroso. La simulación ofrece una salida evidente: entrenar en un mundo virtual donde los datos son baratos y luego desplegar en la máquina real. El problema tiene nombre, la brecha de realidad (reality gap), y cerrarla es de lo que trata la robótica sim-to-real.
Esta guía explica de dónde viene la brecha, qué técnicas la han reducido (aleatorización de dominio, simulación rápida en GPU, gemelos digitales) y cómo encajan en el aprendizaje robótico y la autonomía actuales los datos sintéticos para robots, cada vez más producidos por modelos de mundo generativos.
¿Qué es la brecha de realidad?
En su artículo de 2017 sobre aleatorización de dominio, investigadores de OpenAI y UC Berkeley describieron el problema con claridad. Los simuladores físicos difieren de la realidad de formas difíciles de eliminar. La identificación del sistema, es decir, ajustar los parámetros de un simulador para que coincida con un robot físico, es «lenta y propensa a errores». Incluso un simulador bien ajustado pasa por alto efectos como los materiales no rígidos, la holgura de los engranajes, el desgaste o la dinámica de fluidos. Las imágenes de cámara renderizadas tampoco tienen la riqueza ni el ruido de los sensores reales [1]. En conjunto, estas diferencias forman la brecha de realidad y explican por qué una política que parece perfecta en simulación puede fallar en un robot real.
El mismo artículo expone por qué la simulación sigue mereciendo la pena. El aprendizaje por refuerzo profundo (RL) se basa en la exploración aleatoria, que puede ser peligrosa en hardware. Además, a menudo necesita cientos de miles o millones de muestras, cuya recogida en un robot físico podría llevar miles de horas [1].
Técnica 1: aleatorización de dominio, o convertir la realidad en «una variante más»
La primera respuesta ampliamente adoptada era contraintuitiva. En lugar de hacer el simulador perfectamente realista, hacerlo enormemente variado. Si un modelo ve suficiente variación aleatoria durante el entrenamiento, argumentaban los autores, «el mundo real puede parecerle al modelo una variante más» [1].
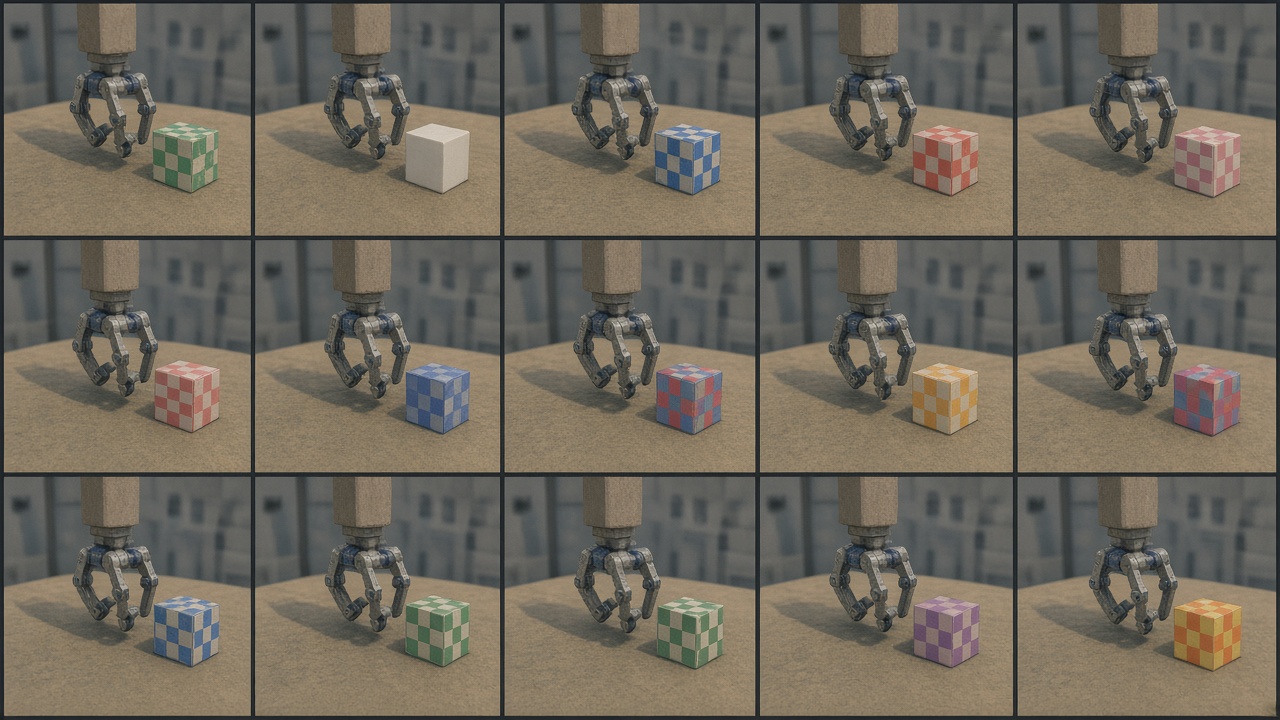
Su experimento entrenó un detector de objetos únicamente con imágenes simuladas renderizadas con texturas aleatorias deliberadamente irreales: colores planos, degradados y patrones de cuadros, mostrados con iluminación, posiciones de cámara y objetos de distracción aleatorizados, y renderizados con el sencillo motor de renderizado integrado en MuJoCo [1]. El detector localizaba objetos en el mundo real con un margen medio de unos 1,5 cm, y un robot Fetch que lo utilizaba cogió el objeto objetivo en 38 de 40 intentos en escenas desordenadas [1]. Los autores lo describieron como la primera transferencia satisfactoria al control de un robot real de una red profunda entrenada solo con imágenes RGB simuladas, sin preentrenamiento con imágenes reales [1].
Los estudios de ablación siguen siendo útiles hoy. El rendimiento caía notablemente con menos de unas 1.000 texturas únicas. Quitar los objetos de distracción del entrenamiento elevaba el error medio en escenas desordenadas de unos 1,8 cm a 7,2 cm [1]. La propia variedad era la señal de entrenamiento.
Aleatorización de dominio automática
Elegir a mano los rangos de aleatorización es difícil: demasiada aleatorización dificulta el aprendizaje y demasiado poca entorpece la transferencia [2]. OpenAI abordó esta cuestión en 2019, en su proyecto del cubo de Rubik, con la Automatic Domain Randomization (ADR). El entrenamiento empieza en un único entorno sin aleatorizar. Cada vez que la política alcanza un umbral de rendimiento, los rangos de aleatorización se amplían automáticamente, abarcando parámetros como el tamaño y la masa del cubo, la fricción de los dedos y el aspecto visual de la mano [2].
Las redes neuronales se entrenaron por completo en simulación y después controlaron una mano robótica real de aspecto humano para resolver el cubo [2]. OpenAI fue transparente sobre los límites: el sistema tenía éxito el 60 % de las veces con mezclas que requerían 15 giros, y el 20 % con las mezclas más difíciles, que requerían 26 [2]. En una tarea más sencilla de voltear un bloque, la ADR acabó duplicando el rendimiento de transferencia al robot real frente a la aleatorización ajustada manualmente, sin ajuste humano [2]. La política también resistió perturbaciones que nunca había visto durante el entrenamiento [2].
Técnica 2: velocidad, con simulación en GPU e iteración rápida
La aleatorización de dominio multiplica la cantidad de experiencia que necesita una política. Eso convierte la velocidad del simulador en una cuestión de ingeniería central, no en una simple comodidad.
MuJoCo Playground, publicado en 2025 por investigadores de UC Berkeley, Google DeepMind y otras instituciones, muestra cuánto se ha avanzado. Es un marco totalmente de código abierto basado en MJX, una versión del motor físico MuJoCo basada en JAX que se ejecuta en GPU. Los investigadores pueden instalarlo con un simple pip install playground y entrenar muchas políticas en minutos con una sola GPU [3]. Los autores describen la receta sim-to-real estándar en cuatro pasos: construir un entorno simulado que se corresponda con el mundo real (el «gemelo digital»), codificar el comportamiento deseado como recompensa, entrenar en simulación y desplegar [3]. Sostienen que la velocidad importa porque el diseño de recompensas es iterativo. El RL es bueno maximizando la recompensa, pero a menudo produce comportamientos extraños, de modo que el tiempo entre pedir un comportamiento y verlo en el robot se convierte en el cuello de botella [3].
Algunos de los resultados publicados:
- Locomoción: políticas de marcha controladas con joystick para el Berkeley Humanoid, entrenadas en suelo plano en menos de 15 minutos. Las políticas para los humanoides Unitree G1 y Booster T1 tardaron menos de 30 minutos en dos GPU RTX 4090 y se transfirieron en modo zero-shot a una marcha y unos giros estables [3].
- Manipulación a partir de píxeles: con propiedades visuales aleatorizadas (iluminación, sombras, posición de la cámara, colores de los objetos), un brazo Franka aprendió a coger un pequeño bloque a partir de imágenes RGB de 64×64 tras diez minutos de entrenamiento en una sola RTX 4090. Después tuvo éxito en los 12 ensayos en el mundo real [3].
- Control con mucho contacto: una política controlada por par para empujar y reorientar un bloque de yoga, entrenada con retardos aleatorizados y un currículo, alcanzó una tasa media de éxito en el mundo real de alrededor del 86 % en 35 ensayos con hardware [3].
- Ritmo de iteración: el equipo desplegó políticas basadas en el estado y en la visión en seis plataformas robóticas en menos de ocho semanas [3].
El artículo también ofrece una visión honesta de la brecha que queda. Su política de reorientación de un cubo con la mano LEAP solo logró una mediana de 3,5 rotaciones consecutivas en ensayos reales, con fallos como el cubo encajado entre los dedos y la palma [3]. La manipulación diestra con mucho contacto sigue siendo el punto más débil del sim-to-real.
La pila competidora de NVIDIA funciona con su motor GPU PhysX a través de Isaac Lab e Isaac Sim. Los autores de MuJoCo Playground reconocen que este ecosistema ha producido una amplia gama de resultados sim-to-real en robótica, aunque señalan que la implementación GPU de PhysX es de código cerrado [3].
Técnica 3: sim-to-real por capas para humanoides
En 2026, el sim-to-real es menos un truco aislado que una arquitectura. La explicación técnica publicada por NVIDIA en enero de 2026 sobre su modelo humanoide Isaac GR00T N1.6 muestra el patrón [4]:
- Nivel bajo: un controlador de cuerpo completo entrenado con RL en Isaac Lab produce primitivas de movimiento dinámicamente estables para locomoción, manipulación y comportamientos con múltiples contactos. Estas políticas se someten a pruebas de estrés a gran escala en Isaac Lab e Isaac Sim y luego se transfieren en modo zero-shot a humanoides físicos [4].
- Nivel medio: una política de navegación entrenada con grandes conjuntos de datos sintéticos generados con el flujo COMPASS de NVIDIA envía órdenes de velocidad a ese controlador. NVIDIA informa de una transferencia sim-to-real zero-shot, incluido el despliegue en nuevos entornos físicos, sin recopilar datos adicionales específicos de la tarea [4].
- Nivel alto: el modelo visión-lenguaje-acción GR00T N1.6 razona sobre la tarea y encadena habilidades. Su mezcla de entrenamiento combina entornos simulados (BEHAVIOR, RoboCasa y un entorno GR-1 a medida) con demostraciones reales de varias plataformas robóticas [4].
La decisión de diseño importa. La física más difícil, el equilibrio y el contacto, la gestiona una política entrenada en gran medida en simulación, donde las caídas no cuestan nada. El modelo grande puede entonces centrarse en qué hacer y no en cómo mantenerse en pie [4]. Antes del despliegue, la pila completa se valida en simulación [4].
Técnica 4: datos sintéticos de cola larga a partir de modelos de mundo
Los simuladores clásicos son motores físicos con un renderizador acoplado. En 2026 madura un segundo tipo de simulador: los modelos de mundo generativos, que producen vídeo y datos de sensores físicamente plausibles.
En el CES de enero de 2026, NVIDIA lanzó Cosmos Transfer 2.5 y Cosmos Predict 2.5, que describe como modelos de mundo abiertos y totalmente personalizables para la generación de datos sintéticos basados en la física y para evaluar políticas robóticas en simulación. También lanzó Cosmos Reason 2, un modelo visión-lenguaje de razonamiento abierto, todos ellos disponibles en Hugging Face [5]. El atractivo está en la cola larga: condiciones de iluminación poco habituales, objetos inusuales y escenas límite que son caras o peligrosas de recrear físicamente, pero con las que un robot desplegado acabará encontrándose.
El mismo anuncio muestra cómo las herramientas en torno a la simulación se están convirtiendo en infraestructura industrial [5]:
- Evaluación: Isaac Lab-Arena, un marco de código abierto para evaluar y comparar a gran escala políticas robóticas en simulación, se conecta con benchmarks como Libero y RoboCasa.
- Orquestación: NVIDIA OSMO coordina la generación de datos sintéticos, el entrenamiento y las pruebas software-in-the-loop entre estaciones de trabajo y la nube.
- Sanidad: LEM Surgical utiliza Isaac for Healthcare y Cosmos Transfer para entrenar los brazos autónomos de su robot quirúrgico Dynamis.
- Socios: AGIBOT presentó Genie Sim 3.0, una plataforma de simulación integrada con Isaac Sim, y Franka Robotics, NEURA Robotics y Humanoid utilizan flujos de trabajo compatibles con GR00T para simular, entrenar y validar nuevos comportamientos.
Por qué importa el edge: de la simulación a la autonomía en el dispositivo
El sim-to-real no termina cuando acaba el entrenamiento. Una política entrenada en la nube tiene que ejecutarse en tiempo real en el robot, a menudo con una potencia limitada. Las políticas de locomoción de MuJoCo Playground, por ejemplo, funcionan a 50 Hz mediante ONNX Runtime dentro de una pila de control en tiempo real en C++ [3]. La política por par del Franka emite órdenes cada 5 ms [3].
Los fabricantes de hardware se están preparando para ello. El módulo Jetson T4000 de NVIDIA, anunciado en enero de 2026, lleva su arquitectura Blackwell a las máquinas autónomas. NVIDIA cita 1.200 TFLOPS en FP4 y 64 GB de memoria en una envolvente configurable de 70 vatios, a 1.999 $ por unidad en lotes de 1.000 unidades [5]. Para la robótica industrial, la conclusión es que la cadena de entrenar en simulación y desplegar en el borde cuenta ya con piezas específicas en ambos extremos.
Lo que todavía no se transfiere
La simulación no ha hecho innecesarios los datos reales. Las fuentes citadas señalan puntos débiles recurrentes:
- Destreza con mucho contacto. OpenAI comprobó que la aleatorización de dominio por sí sola «no bastaba» para la física de un cubo de Rubik en una mano robótica [2], y la reorientación en la mano sigue siendo frágil en frameworks abiertos más recientes [3].
- Física no modelada. La holgura, el desgaste, los materiales deformables y los fluidos siguen siendo difíciles de simular con fidelidad [1].
- Desajustes de sensores y latencia. Las transferencias satisfactorias dependen a menudo de modelar deliberadamente los retardos y el ruido. MuJoCo Playground aleatoriza los retardos de acción y observación y el retraso de la pinza, y sus autores indican que calibrar aproximadamente la escala de acción en el montaje real mejoró la transferencia «de forma drástica» [3].
- Diseño de recompensas. El entrenamiento ya es rápido, pero especificar qué debe hacer el robot sigue siendo un proceso humano e iterativo [3].
Conclusión
La pregunta ha cambiado. Antes era «¿puede funcionar en el mundo real un robot entrenado en simulación?» y, en 2026, la respuesta es claramente sí para la locomoción y para una gama creciente de tareas de manipulación. La pregunta ahora es cómo repartir el trabajo entre simulación, datos sintéticos y experiencia real. La respuesta práctica tiene varias partes:
- Entrenar las habilidades de bajo nivel, muy dependientes de la física, en simulación en GPU fuertemente aleatorizada.
- Cubrir la cola larga con datos sintéticos de modelos de mundo.
- Validar las pilas completas en gemelos digitales antes de que lleguen al hardware.
- Mantener un flujo más reducido, pero aún imprescindible, de datos reales para el contacto, la percepción y los casos límite que los simuladores todavía pasan por alto.
Para quien desarrolle aprendizaje robótico y autonomía, el sim-to-real se ha convertido en infraestructura esencial.
Lecturas relacionadas
- Modelos visión-lenguaje-acción: la nueva capa base de los robots
- Fábricas de datos para la IA física: cómo los datos sintéticos aceleran los robots industriales
- Cobots con IA y visión: donde las fábricas ven antes el ROI
Referencias / fuentes
- Tobin, Fong, Ray, Schneider, Zaremba, Abbeel, «Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World», arXiv:1703.06907 (2017). https://arxiv.org/abs/1703.06907
- OpenAI, «Solving Rubik’s Cube with a robot hand» (15 October 2019). https://openai.com/index/solving-rubiks-cube/
- Zakka, Tabanpour, Liao et al., «MuJoCo Playground», arXiv:2502.08844 (2025). https://arxiv.org/abs/2502.08844
- NVIDIA Technical Blog, «Building Generalist Humanoid Capabilities with NVIDIA Isaac GR00T N1.6 Using a Sim-to-Real Workflow» (8 January 2026). https://developer.nvidia.com/blog/building-generalist-humanoid-capabilities-with-nvidia-isaac-gr00t-n1-6-using-a-sim-to-real-workflow/
- NVIDIA, «NVIDIA Releases New Physical AI Models as Global Socios Unveil Next-Generation Robots», press release (5 January 2026). https://investor.nvidia.com/news/press-release-details/2026/NVIDIA-Releases-New-Physical-AI-Models-as-Global-Partners-Unveil-Next-Generation-Robots/
Créditos de imagen: ambas ilustraciones (sim2real-hero.jpg, sim2real-domain-randomization.jpg) son imágenes generadas con IA, conforme al BP §5.2. Texto original; cifras parafraseadas y atribuidas conforme al §5.1.
Imágenes: ilustraciones originales creadas para AndBeyond.Tech; no aparecen logotipos ni personas reales.