Microsoft Fairwater y el auge de la superfábrica de IA distribuida
Cómo Microsoft Fairwater une Wisconsin y Atlanta en una sola superfábrica de IA: refrigeración líquida, red WAN de IA y el salto multi-campus.
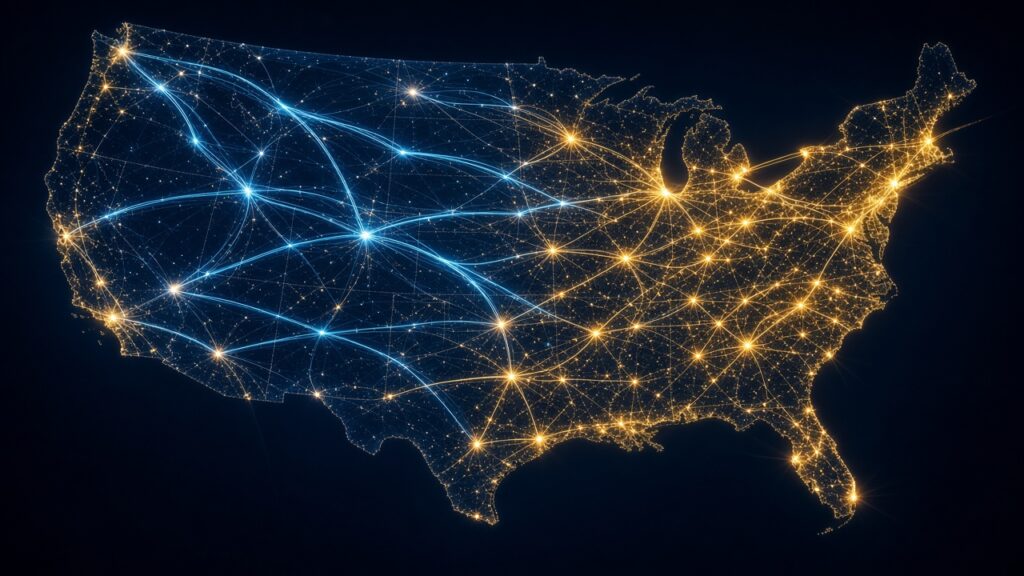
Durante la mayor parte de la era cloud, el data center era la unidad que importaba. Se construía un edificio, se llenaba de servidores, se conectaba a Internet y muchas cargas de clientes sin relación compartían el espacio. La IA de frontera rompió ese modelo una vez, cuando los clústeres de entrenamiento se convirtieron en máquinas únicas del tamaño de un edificio. Ahora lo está rompiendo de nuevo. Con Fairwater, Microsoft apuesta a que la siguiente unidad de cómputo no es un edificio, ni siquiera un campus, sino una red de campus separados por cientos de kilómetros que se comportan como una sola máquina. Microsoft la llama una superfábrica de IA.
Este artículo analiza qué es realmente Fairwater, en qué se diferencia un data center de IA distribuido de un solo campus gigante, qué hace falta para interconectar GPU entre estados y por qué el verdadero motor puede ser la electricidad más que el silicio.
Qué es Fairwater
Microsoft reveló Fairwater en septiembre de 2025 con un sitio en Mount Pleasant, Wisconsin. En una entrada del Official Microsoft Blog, Scott Guthrie, Executive Vice President of Cloud + AI, lo presentó como la fábrica de IA más grande y sofisticada construida hasta entonces por la compañía. También dijo que varios data centers Fairwater idénticos estaban en construcción en otras partes de EE. UU.
El campus de Wisconsin es grande incluso para estándares de hiperescala. Microsoft indica que cubre 315 acres, con tres edificios que suman 1,2 millones de pies cuadrados bajo techo. Construirlo requirió 46,6 millas de pilotes de cimentación profunda, 26,5 millones de libras de acero estructural, 120 millas de cable subterráneo de media tensión y 72,6 millas de tubería mecánica. Microsoft afirma que el sitio opera un clúster único de servidores NVIDIA GB200 interconectados en una red plana única que abarca cientos de miles de GPU. La compañía también afirma que ofrecerá diez veces el rendimiento del superordenador más rápido de hoy. Esa es la comparación de Microsoft, sin metodología de benchmark en la entrada.
Dos meses después, en noviembre de 2025, Microsoft anunció el segundo sitio Fairwater, en Atlanta, Georgia. La entrada de Guthrie sobre la arquitectura dice que Atlanta se conecta a Wisconsin, a generaciones anteriores de superordenadores de IA de Microsoft y a la huella más amplia de Azure, formando lo que la compañía llama «la primera superfábrica de IA a escala planetaria». Un reportaje compañero en la newsroom Source de Microsoft dice, según el extracto publicado, que la instalación de Atlanta empezó a operar en octubre de 2025. Comparte la arquitectura de Wisconsin, y otros sitios Fairwater en construcción se unirán a la misma red con el tiempo.
Microsoft también vinculó Fairwater a su despliegue de IA en el extranjero. La entrada de septiembre mencionaba un data center de IA a hiperescala previsto en Narvik, Noruega, con nScale y Aker JV, y una asociación con nScale en Loughton, Reino Unido, para construir lo que Microsoft llamó el superordenador más grande del Reino Unido. Microsoft dice que esos sitios usarán clústeres similares basados en los GB300 de NVIDIA. No llevan la marca Fairwater en esa entrada, pero pertenecen a la misma historia: capacidad de IA construida a propósito para enchufarse a una red global de más de 400 data centers en 70 regiones.
Objetivos de diseño: densidad, refrigeración y sala de dos plantas
La ingeniería de Fairwater parte de una restricción. En palabras de Guthrie, la velocidad de la luz se ha convertido en un cuello de botella clave. Cuando decenas de miles de aceleradores deben intercambiar gradientes muchas veces por segundo, cada metro de cable añade latencia. Así que la primera regla de diseño es la densidad: poner tanto cómputo como sea posible lo más cerca posible.
Eso se traduce de tres maneras.
Aceleradores a escala de rack. Cada rack Fairwater aloja hasta 72 GPU NVIDIA Blackwell en un solo dominio NVLink. Microsoft cita 1,8 TB de ancho de banda GPU a GPU por rack y más de 14 TB de memoria agrupada disponible para cada GPU. La compañía afirma que un rack GB200 puede procesar 865.000 tokens por segundo, lo que presenta como el mayor caudal de proceso de cualquier plataforma cloud. Es una afirmación del fabricante.
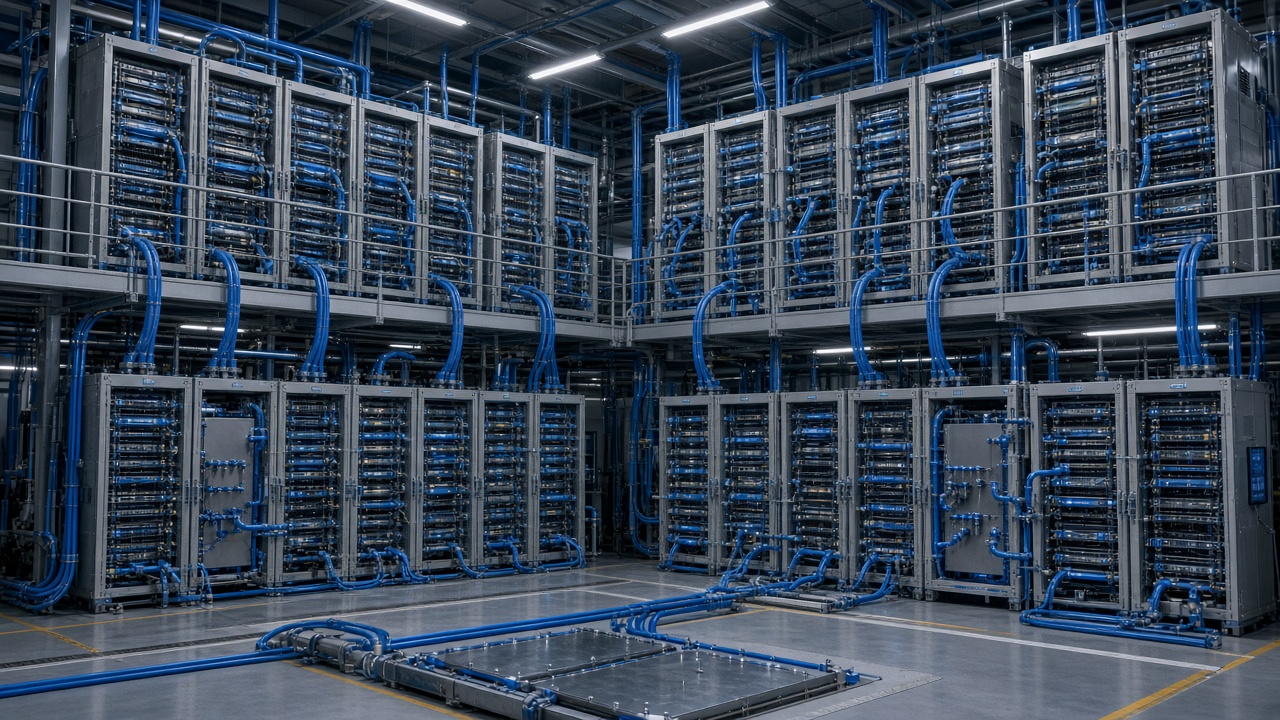
Refrigeración líquida a escala de instalación. La refrigeración por aire no puede evacuar el calor a estas densidades. Fairwater usa refrigeración líquida en bucle cerrado que lleva el refrigerante a placas frías en los servidores. Según Microsoft, el líquido se reutiliza de forma continua tras el primer llenado, sin evaporación. Ese primer llenado equivale aproximadamente al consumo anual de 20 hogares, y el sistema está diseñado para durar seis años o más antes de que la química del agua pueda requerir un cambio. La entrada de Wisconsin describe el sitio como respaldado por la segunda mayor planta de chillers refrigerados por agua del planeta, con 172 ventiladores de veinte pies en las «aletas» de refrigeración a ambos lados de los edificios. La refrigeración líquida permite a Microsoft empujar la potencia por rack hasta unos 140 kW, y la potencia por fila hasta 1.360 kW.
Construir en tres dimensiones. Las salas Fairwater tienen dos plantas. Los racks se conectan a vecinos de arriba y abajo además de a los de al lado, lo que acorta los recorridos de cable más largos. Microsoft dice que eso mejora latencia, ancho de banda, fiabilidad y coste: un recordatorio de que el plano del edificio se ha convertido en una decisión de red.
Las salas de cómputo son solo parte del cuadro. Microsoft dice que Wisconsin también se apoya en un data center separado de almacenamiento y cómputo cuyos sistemas de almacenamiento miden «cinco campos de fútbol de largo». La compañía también afirma haber reingenierizado Azure Blob Storage para que cada cuenta pueda sostener más de dos millones de transacciones de lectura/escritura por segundo. Una ejecución de entrenamiento de frontera es tanto un problema de logística de datos como de FLOPS.
Superfábrica frente a un solo mega-campus
Una estrategia de un solo campus es sencilla: encontrar un sitio con suficiente terreno, agua y, sobre todo, potencia, y construir el mayor clúster coherente posible. El modelo tiene fortalezas claras. La latencia entre dos GPU cualesquiera está acotada por el tamaño del edificio, el entrenamiento síncrono se entiende bien y las operaciones están concentradas.
Su debilidad es que la potencia, el terreno y la interconexión a la red no escalan de forma suave. La entrada de noviembre de Guthrie lo dice directamente: la demanda de cómputo para grandes trabajos de entrenamiento, ahora medida en billones de parámetros, «está superando rápidamente las restricciones de potencia y espacio de una sola instalación».
Fairwater conserva la idea de un solo campus dentro de cada sitio. Cada data center Fairwater opera un clúster coherente. La superfábrica añade luego otra capa encima. Microsoft describe tres niveles de red:
- Scale-up dentro del rack (NVLink, 72 GPU).
- Scale-out a través del sitio, en una red back-end plana que abarca cientos de miles de GPU.
- Entre sitios, sobre una WAN de IA dedicada que enlaza campus Fairwater y superordenadores anteriores.
El cambio importante es que las cargas pueden situarse en el nivel que les conviene. Microsoft señala que el «entrenamiento» ya no es un trabajo monolítico. Ahora cubre preentrenamiento, fine-tuning, aprendizaje por refuerzo, evaluación y generación de datos sintéticos, cada uno con patrones de comunicación distintos. Antes, escribe Guthrie, todo el tráfico tenía que usar la red scale-out independientemente de la necesidad. En una superfábrica, un trabajo tensor-parallel sensible a la latencia se queda dentro de un rack, un gran preentrenamiento data-parallel puede extenderse por un sitio, y trabajos más débilmente acoplados como la generación de datos sintéticos o los rollouts de RL pueden ejecutarse en otras ubicaciones. Microsoft llama al objetivo fungibility: mantener las GPU ocupadas en todo el sistema, no solo dentro de un edificio.
Eso es lo que distingue un verdadero data center de IA distribuido de un conjunto de grandes data centers que casualmente comparten dueño. Los sitios están diseñados para programarse como un solo pool.
Redes de clústeres entre sitios
Dentro del sitio: Ethernet a escala extrema
Las descripciones de Microsoft del fabric intra-sitio han cambiado entre entradas, y el cambio importa. La entrada de Wisconsin de septiembre dice que Azure usa fabrics InfiniBand y Ethernet a 800 Gbps en un fat-tree no bloqueante para conectar racks en pods. La entrada de superfábrica de noviembre, centrada en la arquitectura Fairwater, describe una red back-end Ethernet de dos niveles con conectividad GPU a GPU de 800 Gbps. Corre sobre SONiC, el sistema operativo de red abierto de Microsoft, en switches commodity. Microsoft lo presenta como una forma de evitar el dependencia del proveedor del fabricante y controlar costes, y dice que el diseño escala «más allá de los límites tradicionales de las redes Clos» con switches de generación actual.
Para que Ethernet se comporte a esa escala, Microsoft cita packet trimming, packet spraying, telemetría de alta frecuencia y un control más estrecho de las rutas de red. Juntos aportan control de congestión, detección rápida de pérdidas y retransmisión, y balanceo de carga adaptativo. Son los mismos problemas a los que apuntan los esfuerzos Ultra Ethernet de la industria. Fairwater muestra a un hiperescalador apostando a que una pila Ethernet abierta puede soportar el entrenamiento de frontera sin fabrics propietarios.
Entre sitios: la WAN de IA
La capa entre sitios es la parte novedosa. Microsoft dice haber construido una red óptica WAN de IA dedicada para extender las redes scale-up y scale-out de Fairwater entre regiones. También dice haber desplegado más de 120.000 millas nuevas de fibra en EE. UU. en el año anterior a la entrada de noviembre de 2025. El reportaje Source describe la WAN de IA, según su extracto, como permitiendo que los datos se muevan entre sitios separados por varios estados con mínimos cuellos de botella, de modo que varios sitios puedan cooperar en entrenamiento casi en tiempo real. El mismo texto dice que el diseño distribuido apunta a modelos de cientos de billones de parámetros y podría recortar algunos trabajos de entrenamiento de meses a semanas. Ambas son proyecciones de Microsoft.
Sobre el ancho de banda, las notas públicas del ingeniero HPC Glenn K. Lockwood sobre entrenamiento multiclúster citan a Guthrie diciendo que la WAN de IA soporta hasta 400 terabits de ancho de banda de red. Esa cifra está reportada vía esa fuente secundaria; la transcripción original no se localizó para este borrador.
El problema de física
Microsoft no ha publicado cifras de latencia para el enlace Wisconsin–Atlanta. Los compromisos son claros en principio. La luz en fibra cubre aproximadamente un kilómetro cada cinco microsegundos, así que sitios separados por cientos de kilómetros añaden retardos de ida y vuelta medidos en milisegundos. Dentro de un rack o una sala, los retardos se miden en microsegundos. Un briefing secundario del 311 Institute, citando The Register, sitúa la distancia entre Mount Pleasant y Atlanta en unos 1.000 km, según ese reportaje.
Esa brecha define qué puede ejecutarse entre sitios. Operaciones estrechamente síncronas como el paralelismo de tensores no toleran la latencia WAN y deben quedarse dentro de un sitio. El paralelismo de datos es más indulgente, sobre todo con reducción jerárquica de gradientes, solapamiento de comunicación y cómputo, o sincronización menos frecuente. Este es el patrón de «jerarquía de fabrics» que describe Lockwood: la comunicación intra-sitio es rápida y densa, la comunicación entre sitios es más lenta y debe usarse con parsimonia, y el software de entrenamiento tiene que construirse en torno a esa asimetría. La superfábrica solo funciona si los planificadores y frameworks respetan esos límites.
El ángulo de energía y sistemas eléctricos
Microsoft no lo formula así, pero el argumento más fuerte a favor de la distribución puede ser eléctrico. El mismo briefing del 311 Institute resume, según el reportaje, que un solo sitio lucha por obtener suficiente potencia para las ejecuciones de entrenamiento más grandes. También dice que el argumento de Microsoft es que enlazar sitios permite elegir ubicaciones con terreno más barato, climas más frescos y potencia abundante. La distribución convierte una petición de interconexión imposible en varias difíciles pero alcanzables.
El diseño eléctrico de Fairwater refleja ese pensamiento. Para Atlanta, Microsoft dice haber elegido el sitio por una potencia de utilidad resiliente capaz de entregar «disponibilidad 4×9 al coste 3×9». Como el suministro de red es tan fiable, Microsoft afirma poder prescindir de las capas de resiliencia tradicionales para la flota GPU: sin generación en sitio, sin UPS, sin distribución bi-cableada. Es una desviación significativa de la práctica convencional de data centers. También muestra cómo la selección de sitio se convierte en una decisión de ingeniería eléctrica una vez que el cómputo puede vivir en cualquier punto de la WAN. Sigue otra implicación: si un sitio tiene un problema, parte de la resiliencia puede venir de la red de sitios en lugar de generadores diésel en el patio. Microsoft no lo dice explícitamente, pero Thomas Kurian de Google hizo el mismo punto sobre el entrenamiento multi-sitio, como se discute más abajo.
Un segundo problema de potencia es menos obvio: la oscilación de carga. Los grandes trabajos de entrenamiento síncrono consumen potencia en oleadas cuando miles de GPU se mueven juntas entre fases de cómputo y comunicación. A cientos de megavatios, esos vaivenes pueden convertirse en un problema de estabilidad para la red. Microsoft dice haber codesarrollado tres mitigaciones con socios:
- un enfoque de software que lanza cargas complementarias en periodos de baja actividad para suavizar la demanda;
- un enfoque de hardware en el que las GPU imponen sus propios umbrales de potencia; y
- almacenamiento de energía en sitio para absorber fluctuaciones sin desperdiciar potencia extra.
La distribución también ayuda aquí. Los vaivenes de un trabajo de 2 GW son mucho más fáciles de gestionar para una eléctrica cuando se reparten entre varias redes. El coste es la complejidad: cada sitio sigue teniendo que gestionar su propio perfil de potencia, y la WAN se convierte en una dependencia crítica.
El agua es la tercera pieza del cuadro energético. Microsoft dice que más del 90 % de su capacidad de data centers usa el sistema de bucle cerrado, y que los servidores tradicionales restantes usan aire exterior, pasando al agua solo en los días más calurosos. Las comunidades cercanas a campus de hiperescala suelen preguntar primero por agua y potencia, y el mensaje de Fairwater lidera con ambas.
Contexto de la industria: todo el mundo va a multi-sitio
Microsoft marca la superfábrica de IA, pero no inventó el entrenamiento multi-sitio.
Google llegó pronto. En una entrevista de Data Center Dynamics, según el extracto publicado, el CEO de Google Cloud Thomas Kurian dijo que Gemini Ultra se entrenó «en múltiples sitios, y múltiples clústeres dentro de esos sitios». Explicó que la distribución aporta resiliencia si una ubicación tiene problemas de potencia y permite un clúster global mayor dadas las restricciones de espacio y potencia. DCD señala que Google enlaza TPU SuperPods de 4.096 chips mediante redes intra- e inter-clúster, usando paralelismo de modelo dentro de un SuperPod y paralelismo de datos entre SuperPods. Es la misma jerarquía que Fairwater formaliza.
OpenAI ha, según Lockwood y el 311 Institute, confirmado el entrenamiento de GPT-4.5 en múltiples clústeres. NVIDIA anunció Spectrum-XGS Ethernet en agosto de 2025 para conectar data centers entre ciudades y continentes en lo que llama gigantescas fábricas de IA, con CoreWeave entre los primeros adoptantes, según reportes. Cisco y Broadcom habrían lanzado routers diseñados para enlazar data centers de IA hasta unos 1.000 km, según The Register vía el briefing 311. No se han contrastado estas afirmaciones de fabricante con las páginas primarias de NVIDIA, Cisco o Broadcom para este borrador.
Tomado en conjunto, apunta a una dirección clara. La industria está construyendo el hardware, los protocolos y el software para ejecuciones de entrenamiento que abarcan regiones, y la WAN de IA de Microsoft es el ejemplo más visible hasta ahora.
Estado 2026: del plano al campus en vivo
Los reportajes comerciales y locales de 2026 completaron la cronología que los blogs de Microsoft de 2025 dejaron abierta. Según MLQ News e Inside the Datacenter, Microsoft declaró el primer edificio Fairwater de Mount Pleasant plenamente operativo el 23 de junio de 2026, tras unos dos años de construcción que emplearon a casi 10.000 trabajadores en el pico. Esos relatos sitúan el campus en el antiguo sitio Foxconn del condado de Racine y describen una segunda instalación adyacente prevista para 2028, con aprobaciones locales a principios de 2026 para una expansión multi-edificio mucho mayor.
El reportaje blueprint Fairwater de Data Center Frontier (actualizado tras el documento regulatorio) informó de una inversión en Wisconsin de unos 7.300 millones de dólares en documentos regulatorios estatales revisados vía Data Center Dynamics, con una demanda pico de Fase 1 cerca de 400 MW y un despliegue completo acercándose a unos 900 MW: cifras que siguen siendo secundarias a las afirmaciones del blog de Microsoft y deben tratarse como reportadas, no como divulgaciones auditadas de Microsoft. El mismo texto menciona mejoras de red prepago, generación a gas temporal para fiabilidad temprana y programas comunitarios como una Datacenter Academy con Gateway Technical College.
Por separado, Bloomberg informó en septiembre de 2026 que Microsoft planea hacer crecer la capacidad global de data centers de unos 12 GW a más de 38 GW para 2032, citando a personas familiarizadas con los planes; Reuters retransmitió la cifra el mismo día y dijo que Microsoft no comentó. Esa hoja de ruta de capacidad no es específica de Fairwater, pero es el telón corporativo sobre el que las superfábricas de IA multi-campus tienen sentido: Microsoft está dimensionando una flota, no una sola sala.
Perspectiva
Varias preguntas dirán si la superfábrica de IA se convierte en la arquitectura por defecto o permanece como un enfoque de nicho para los laboratorios más grandes.
¿Hasta qué punto pueden acoplarse los sitios? Si el entrenamiento entre sitios se limita a fases débilmente acopladas, la superfábrica es sobre todo una mejora de utilización y planificación. Si nuevos algoritmos de entrenamiento y equipos de red recortan el coste de sincronizar a 1.000 km, se convierte en un verdadero multiplicador de escala.
¿Cuántos sitios se unen? Microsoft ha dicho que hay más sitios Fairwater en construcción en EE. UU. El 311 Institute lista la llegada de más sitios al clúster enlazado, más allá de Wisconsin y Atlanta, como una señal a vigilar. Cada nuevo sitio pone a prueba si el modelo se sostiene operativamente.
¿Seguirá siendo la potencia la restricción vinculante? Si la generación en sitio o grandes nuevas conexiones de red vuelven a hacer fáciles los campus de un gigavatio únicos, parte del caso a favor de la distribución se debilita. Por ahora, las colas de interconexión y la oposición local sugieren lo contrario.
¿Quién construye la fibra de larga distancia? Las 120.000 millas nuevas de fibra reportadas por Microsoft en un año sugieren que las backbones ópticas privadas dedicadas al tráfico de IA podrían volverse tan estratégicas como las asignaciones de GPU.
El punto más amplio es que la infraestructura de IA de frontera se está convirtiendo en un sistema distribuido en el sentido informático: particionado, jerárquico, consciente de la latencia y programado como un todo. Fairwater es el primer intento serio de Microsoft de operar uno a escala continental. El data center ya no es el ordenador. Lo es la red de data centers.
Lecturas relacionadas
- La carrera de las fábricas de IA en Texas: por qué los hiperescaladores apuestan decenas de miles de millones a un solo estado
- Cómo las superfábricas de IA distribuidas estiran la red entre campus
- InfiniBand vs Ethernet para clústeres de IA
Referencias / fuentes
- Scott Guthrie, «Inside the world’s most powerful AI datacenter,» Official Microsoft Blog, 18 Sep 2025 — https://blogs.microsoft.com/blog/2025/09/18/inside-the-worlds-most-powerful-ai-datacenter/ (primary, fully read)
- Scott Guthrie, «Infinite scale: The architecture behind the Azure AI superfactory,» Official Microsoft Blog, 12 Nov 2025 — https://blogs.microsoft.com/blog/2025/11/12/infinite-scale-the-architecture-behind-the-azure-ai-superfactory/ (primary, fully read)
- «From Wisconsin to Atlanta: Microsoft connects datacenters to build its first AI superfactory,» Microsoft Source — https://news.microsoft.com/source/features/ai/from-wisconsin-to-atlanta-microsoft-connects-datacenters-to-build-its-first-ai-superfactory/ (primary; search extract only)
- «Training Google’s Gemini: TPUs, multiple data centers, and risks of cosmic rays,» Data Center Dynamics — https://www.datacenterdynamics.com/en/news/training-gemini-tpus-multiple-data-centers-and-risks-of-cosmic-rays/ (search extract)
- Glenn K. Lockwood, «Multicluster training» — https://glennklockwood.com/garden/multicluster-training (secondary; search extract)
- 311 Institute, «Multi-Site AI Training: 2026 trend briefing» — https://www.311institute.com/starburst-centre/trend/multi-site-ai-training/ (secondary tracker; search extract)
- David Chernicoff, «Inside Microsoft’s Global AI Infrastructure: The Fairwater Blueprint for Distributed Supercomputing,» Data Center Frontier, 9 Oct 2025 (with later updates) — https://www.datacenterfrontier.com/hyperscale/article/55317925/inside-microsofts-global-ai-infrastructure-the-fairwater-blueprint-for-distributed-supercomputing
- MLQ News, «Microsoft Brings First Mount Pleasant, Wisconsin Data Center Online at Former Foxconn Site» — https://mlq.ai/news/microsoft-brings-first-mount-pleasant-wisconsin-data-center-online-at-former-foxconn-site/ (secondary; search extract / 2026 ops claim)
- Inside the Datacenter, «Every Data Center in Wisconsin» — https://insidethedatacenter.com/articles/wisconsin-data-centers/ (secondary; Jun 2026 operational note)
- Bloomberg via Global Data Center Hub summary, «Microsoft Data Center Capacity Plan: 38 GW By 2032,» Sep 2026 — https://www.globaldatacenterhub.com/p/microsoft-data-center-capacity-38gw-2032 (Bloomberg/Reuters secondary; Microsoft did not confirm)
Imágenes: ilustraciones originales creadas para AndBeyond.Tech; no aparecen logotipos ni personas reales.