Ultra Ethernet 1.1: cuando el Ethernet para IA incorpora cabeceras de scale-up, operaciones colectivas y control de congestión programable
La especificación 1.1 del Ultra Ethernet Consortium añade scale-up, operaciones colectivas en la red, CSIG y control de congestión programable para redes de IA.
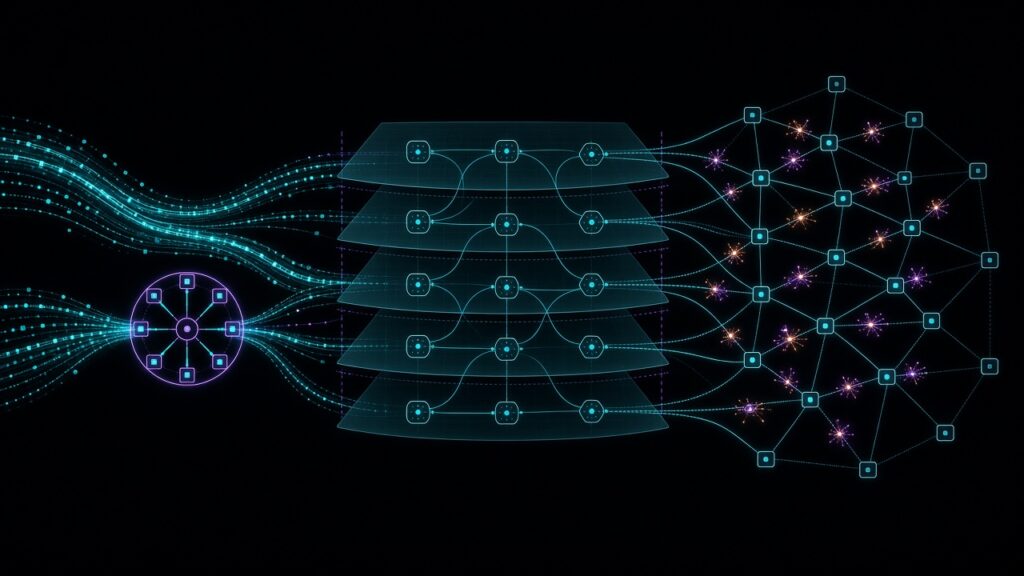
El 12 de octubre de 2026, el Ultra Ethernet Consortium (UEC) publicó la especificación Ultra Ethernet v1.1, que se apoya en los cimientos de la v1.0 publicada en junio de 2025. El propio anuncio del consorcio presenta la 1.1 como algo más que una revisión correctiva: incorpora un amplio trabajo sobre redes de scale-up, mejoras del transporte para la compatibilidad de las aplicaciones y la aceleración de las transferencias masivas, operaciones colectivas en la red (INC, In-Network Collectives), señalización de congestión (CSIG, Congestion Signaling) y gestión programable de la congestión (PCM, Programmable Congestion Management).
Esta publicación importa para las redes de clústeres de IA porque la historia de Ethernet en la IA ya no se limita a «RoCE desplegado con cuidado a escala leaf-spine». El UEC empuja de forma explícita a la misma familia de tecnologías hacia el dominio corto y sensible a la latencia que tradicionalmente ocupaban los enlaces propietarios entre aceleradores, sin dejar de apuntar al scale-out de HPC e IA. Este artículo se ciñe a la especificación v1.1 del UEC y a sus materiales de prensa, atribuye las mejoras cuantitativas al propio consorcio, recoge las primeras demostraciones de terminales (no promesas de productos comercializados) y sitúa la 1.1 junto a iniciativas abiertas afines como ESUN, en el OCP, sin mezclarlas en una sopa de siglas.
Recuadro: scale-up y scale-out (versión para no especialistas)
El scale-up conecta aceleradores dentro de un dominio compacto (a menudo un nodo, una bandeja o un pod) para que las GPU/XPU puedan intercambiar tráfico de tipo memoria con una latencia muy baja (problemas de la clase NVLink, que ahora también persiguen variantes abiertas de Ethernet).
El scale-out conecta muchos nodos a lo largo de la sala para que miles de aceleradores entrenen o sirvan modelos como un único clúster (las redes clásicas InfiniBand o Ethernet RoCE).
Ultra Ethernet nació como un proyecto de Ethernet de scale-out para IA y HPC; según el UEC, la v1.1 añade cabeceras, perfiles y descargas pensados también para el scale-up, de modo que una misma familia de normas pueda abarcar ambas tareas. Siguen siendo diseños distintos; la 1.1 intenta evitar que sean universos distintos.
Lo que ya cambió la v1.0 y por qué la 1.1 ha llegado tan pronto
El UEC presenta Ultra Ethernet como una arquitectura Ethernet abierta e interoperable para IA y HPC, desarrollada bajo el paraguas de la Joint Development Foundation con una amplia participación del sector. La especificación v1.0 (junio de 2025) fijó la orientación del transporte y del ecosistema; el anuncio de la 1.1 afirma que los despliegues de IA y HPC de nueva generación ya han adoptado muchas técnicas de la v1.0. La versión 1.1, fechada el 12 de octubre de 2026 tanto en el comunicado como en el PDF publicado, es la primera revisión importante que se adentra de lleno en el scale-up y en la computación dentro de la red.
La propia especificación subraya que Ultra Ethernet no exige cambios en la capa de red ni en las capas física y de enlace de Ethernet: una implementación conforme puede utilizar los conmutadores Ethernet habituales en la fecha de publicación, mientras que funciones opcionales mejoran el comportamiento para IA y HPC. Esa filosofía, mejorar Ethernet sin bifurcar el universo físico, es lo que diferencia políticamente al UEC de una interconexión diseñada desde cero, y lo que concentra la ingeniería más difícil en las cabeceras, el transporte, la congestión y la programabilidad de las tarjetas de red.
Compatibilidad con redes de scale-up en la 1.1
Según el UEC, el tema de mayor calado de la 1.1 es el scale-up. El consorcio destaca varios mecanismos concretos:
Paquetes más pequeños, menos sobrecarga en vacío. El UEC describe optimizaciones que reducen los bytes inactivos del intervalo entre paquetes (hasta 11 bytes ahorrados entre paquetes, según su explicación) con el fin de hacer más eficientes los mensajes pequeños. El tráfico de scale-up está lleno de operaciones pequeñas y sensibles a la latencia; desperdiciar bytes en los intervalos perjudica más que en los grandes AllReduce.
Cabecera de reenvío unificada (UFH, Unified Forwarding Header). El UEC introduce la UFH, una cabecera de red que se superpone a una cabecera Ethernet tradicional y que, según el consorcio, ahorra 20 bytes frente a un paquete IP tradicional, manteniendo la funcionalidad de enrutamiento IP y la interoperabilidad en el cable con el Ethernet tradicional. El anuncio remite a los detalles de la UFH_32 en la especificación 1.1.
Perfil «Unified Local». Pensado para terminales de scale-up, este perfil incluye un transporte simplificado que admite operaciones de escritura, lectura y atómicas con cabeceras optimizadas, y sigue siendo compatible en el cable con las normas Ultra Ethernet Transport (UET), según el UEC.
En conjunto, estos elementos no convierten Ethernet en «un NVLink más lento». Son un intento de aligerar el peaje de la paquetización de Ethernet dentro de un pod sin renunciar a la interoperabilidad: justo el tipo de compromiso que las coaliciones abiertas pueden ratificar y que los buses propietarios pueden ignorar.
Las notas de colaboración del comunicado del UEC tienen relevancia operativa: el UEC afirma que trabaja con el OCP para que la próxima especificación de ESUN incorpore las tecnologías de scale-up de la v1.1 (ESUN 1.0 ya incluía muchas ideas de la v1.0), con OCP SUE-T en la ampliación del soporte de terminales y con el IEEE en la normalización adicional de CSIG. Los compradores deben seguir esas convergencias: una tarjeta de red que hable UET combinada con una hoja de ruta de silicio de conmutación que solo siga ESUN, o al revés, genera riesgo de integración.
Mejoras del transporte: migrar sin reescribir
Uno de los objetivos declarados de la 1.1 es reducir el coste de migración. El UEC ha creado una correspondencia de Verbs para Ultra Ethernet (UET Verbs) que admite el perfil AI Base y dos funciones de la capa de transporte: una correspondencia de memoria más flexible entre servicios lógicos y grupos de sincronización que ayudan a reproducir la semántica de entrega ordenada de las finalizaciones en el respondedor, familiar en los Verbs existentes. Según el UEC, la combinación permite portar las aplicaciones existentes a Ultra Ethernet con menos modificaciones.
Para las pilas de software de IA que se apoyan en NCCL, MPI y las bibliotecas colectivas de los fabricantes, ahí está la clave de la adopción. Hay redes que naufragan en el pantano de la migración aunque sus protocolos sean elegantes. Una semántica con forma de Verbs es la manera en que el UEC intenta evitar que la infraestructura de la era PyTorch trate Ultra Ethernet como un experimento de fin de semana.
Operaciones colectivas en la red: las cuentas de ancho de banda del UEC
Las operaciones colectivas en la red (INC) son la descarga estrella. Según el UEC, las rutas tradicionales de all-reduce envían los datos a la red dos veces (reducción y, después, difusión), de modo que producir un resultado reducido de 1 GB puede obligar a cada terminal a enviar 2 GB. Con la INC, afirma el UEC, un terminal solo necesita enviar 1 GB, lo que en ese cálculo ilustrativo supone una aceleración de las comunicaciones de hasta 2 veces, porque los conmutadores reducen los datos a medida que llegan y difunden el resultado.
El UEC sostiene también que la INC puede recortar la latencia de las operaciones colectivas pequeñas al utilizar la difusión de la red en lugar de algoritmos en árbol que pagan log n saltos de latencia adicional. Esas mejoras son beneficios declarados por el UEC para ese patrón arquitectónico; presuponen conmutadores compatibles con INC y una ruta de software que invoque realmente la descarga. Los operadores deben leerlas como cotas máximas planteadas por el consorcio, a la espera del silicio y de la integración en NCCL, no como mejoras medidas del tiempo de los trabajos en un clúster concreto.
Señalización de congestión y control programable
El Ethernet para IA vive o muere según su comportamiento ante la congestión. El anuncio de la 1.1 del UEC detalla dos herramientas complementarias.
Señalización de congestión (CSIG). Según el UEC, CSIG es una etiqueta compacta de capa 2, de 4 u 8 bytes, que los conmutadores actualizan con información de alta fidelidad sobre el cuello de botella a lo largo de la ruta de un paquete. Los terminales conocen así tanto la magnitud como la ubicación de la congestión. El UEC afirma que sus algoritmos de control de congestión NSCC y RCCC ya utilizan CSIG: NSCC emplea la latencia de cola notificada en el salto que actúa como cuello de botella para mejorar la equidad; RCCC utiliza mediciones de retardo o de profundidad de cola al conceder créditos al emisor. Más allá de los bucles de control, el UEC presenta CSIG como telemetría detallada para los operadores. El anuncio remite a un artículo de ACM SIGCOMM para un análisis más profundo del diseño de CSIG.
Gestión programable de la congestión (PCM). Mirando más allá de los algoritmos integrados actuales, el UEC describe la PCM como un lenguaje y una interfaz de programación unificados que exponen los fabricantes de tarjetas de red, para que los algoritmos de control de congestión y de equilibrado de carga puedan adaptarse a una carga de trabajo y compilarse para ejecutarse en los terminales, de forma portable entre tarjetas compatibles con PCM. Es una cuestión de aceleradores de IA y chips tanto como de redes: la tarjeta de red se convierte en un ordenador programable de congestión, no solo en una descarga RoCE fija.
La entrada del blog de AMD del 11 de octubre de 2026 sobre su tarjeta de red para IA (un día antes de la publicación de la 1.1) subraya el paralelismo industrial: AMD describe una arquitectura de tarjeta de red para IA programable, utilizada para desarrollar y validar transportes Ethernet preparados para la IA; recuerda que es miembro fundador del UEC y autora del Network-Signaled Congestion Control (NSCC), ya incluido en la especificación de gestión de la congestión del UEC; y afirma haber entregado una de las primeras tarjetas de red para IA capaces de admitir la especificación de transporte del UEC para las pruebas del ecosistema. Debe tomarse como contexto del fabricante que explica por qué el vocabulario de PCM/NSCC llega a las hojas de ruta del silicio, no como una evaluación independiente de las funciones de la 1.1.
Los terminales a finales de 2026: demostraciones, no un catálogo comercial completo
La velocidad de las especificaciones solo sirve si existen terminales. A finales de octubre de 2026, los anuncios públicos de hardware siguen siendo incipientes.
En el Altera Innovators Day 2026 (San José, 28 de octubre de 2026), DYNANIC mostró el entramado y la ruta de datos de Ultra Ethernet en una tarjeta Silicom ThunderFjord con una FPGA Altera Agilex 7 de la serie M (dos puertos 400GbE y PCIe Gen5 x16), usando un bucle de retorno para emular dos terminales y mostrar en tiempo real el efecto de la congestión. La propia reseña de DYNANIC es explícita sobre la secuencia de su hoja de ruta: el entramado y la ruta de datos de Ultra Ethernet funcionan sobre hardware real en la demostración; la retransmisión, la respuesta a la congestión y el multitrayecto, elementos centrales de Ultra Ethernet Transport, son los siguientes pasos. Se trata de una demostración y de una vía de evaluación, no del anuncio de una tarjeta de red UET completa y disponible comercialmente. DYNANIC afirma además que prepara pruebas de interoperabilidad con el UEC y ofrece a socios seleccionados una evaluación anticipada de su propiedad intelectual de Ultra Ethernet.
Leer la 1.1 del UEC junto a ese calendario de demostraciones da una imagen honesta de la adopción: la tinta de las cabeceras de scale-up y de la INC ya está seca; las tarjetas de red comerciales completas en multitrayecto y gestión de la congestión todavía están convergiendo. Los hiperescaladores con silicio propio avanzarán primero; los proveedores de FPGA y de propiedad intelectual tenderán el puente para todos los demás.
Lo que cambia la 1.1 para los arquitectos
1. Planificación de doble dominio. Si su pod de aceleradores de 2027 prevé un Ethernet de scale-up abierto (vías ESUN/Ultra Ethernet) y no solo enlaces propietarios, la UFH y los perfiles Unified Local deben figurar en la solicitud de oferta de tarjetas de red y conmutadores, no como notas a pie de página.
2. La descarga de operaciones colectivas como función del conmutador. Según el UEC, la INC traslada la reducción a la red. Eso implica funciones en el silicio de conmutación y en el sistema operativo de red, enganches en NCCL y en las bibliotecas, y modos de fallo cuando un conmutador reductor se comporta mal. Presupueste pruebas de integración.
3. Telemetría útil ante las ráfagas de la IA. Las etiquetas de CSIG que señalan el cuello de botella de la ruta están diseñadas para flujos de IA sincronizados y de baja entropía, que desbaratan los supuestos clásicos del ECMP. Pregunte a los fabricantes cómo aparece CSIG en su telemetría en continuo.
4. Gobernanza de la programabilidad. La PCM permite compilar políticas de congestión a medida. Es a la vez poder y riesgo: versione los algoritmos como el firmware, pruébelos con distintas combinaciones de trabajos y evite configuraciones únicas por clúster que solo entiende un ingeniero.
5. Mantener aparte el scale-across. El impulso de la 1.1 hacia el scale-up se refiere a pods y salas, no a la interconexión coherente entre campus (DCI). Las redes Ethernet que tienen en cuenta la distancia y la óptica ZR son otro problema (véase nuestro artículo sobre redes multicampus).
Cómo encaja la 1.1 junto a RoCE, ESUN y el scale-up propietario
Ultra Ethernet no borrará RoCEv2 de la noche a la mañana. Muchas redes Ethernet para IA seguirán aplicando las recetas actuales de congestión mientras las tarjetas de red incorporan funciones UET. El relato de migración que el UEC defiende con la correspondencia de Verbs es gradual: preservar la semántica de las aplicaciones, introducir la UFH y los perfiles locales allí donde los pods los necesiten y activar la INC donde el silicio de conmutación admita la reducción. Según el UEC, la compatibilidad en el cable con el Ethernet tradicional sigue siendo una restricción de diseño, de modo que no se pide a las instalaciones leaf-spine existentes que lo renumeren todo el primer día.
ESUN (Ethernet for Scale-Up Networking), dentro del OCP, es la formulación complementaria de Ethernet para pods. El comunicado del UEC indica que ESUN 1.0 ya incorporaba muchas tecnologías de la v1.0 y que los grupos trabajan activamente para integrar el trabajo de scale-up de la v1.1 en la próxima especificación de ESUN, junto con el trabajo de SUE-T sobre terminales. Los arquitectos deberían, por tanto, someter a licitación tanto las afirmaciones del UEC sobre el transporte como las de ESUN sobre conmutadores y perfiles, y pedir a los fabricantes una única matriz de interoperabilidad en lugar de dos árboles de diapositivas que nunca se encuentran en un laboratorio.
El scale-up propietario (NVLink y sus equivalentes) seguirá dominando los dominios más densos con semántica de memoria. La 1.1 del UEC es la respuesta del bando abierto para los operadores que rechazan un pod de un solo fabricante, o que quieren que sus competencias operativas en Ethernet abarquen una mayor parte del rack. No afirma que el Ethernet abierto iguale ya todas las cifras de latencia propietarias. Afirma que el peaje de las cabeceras y las carencias en la descarga de operaciones colectivas son ahora problemas especificados con herramientas especificadas.
Seguridad, multiinquilino y salvedades operativas
Las nubes de IA comparten sus redes. La gestión programable de la congestión (PCM), tal como la plantea el UEC, permite a los operadores compilar políticas en los terminales. Ese poder exige barreras entre inquilinos: el programa PCM agresivo de un inquilino no debe dejar sin recursos el trabajo de entrenamiento de otro. Las etiquetas CSIG, al ser telemetría de ruta, amplían también lo que un observador puede deducir sobre los puntos calientes de la red. Las revisiones de seguridad deben tratar los conmutadores compatibles con INC y las tarjetas de red compatibles con PCM como infraestructura privilegiada: la firma del firmware, las listas de algoritmos permitidos y las pruebas de radio de impacto deben figurar en el mismo expediente que la política de BGP.
Los modos de fallo se multiplican cuando las operaciones colectivas pasan a la red. Si un conmutador reductor se reinicia en mitad de un AllReduce, las bibliotecas deben recurrir limpiamente a algoritmos ejecutados solo en los terminales. Las afirmaciones arquitectónicas del UEC presuponen que todo sale bien; la integración en producción con NCCL (o su sucesor) se juzgará por lo que ocurra cuando las cosas salgan mal. Exija demostraciones explícitas de recuperación en las pruebas de concepto de los fabricantes.
Una lista práctica a 180 días tras la especificación 1.1
- Inventariar qué tarjetas de red de su hoja de ruta declaran el perfil UET AI Base y la correspondencia de Verbs, y qué conmutadores declaran CSIG e INC.
- Probar en laboratorio en dos racks la reproducción de una combinación de operaciones colectivas de producción, con y sin INC (cuando el silicio lo permita), comparando no solo el ancho de banda, sino también la cola de rezagados.
- Alinear las funciones del UEC 1.1 con la revisión de OCP ESUN que su proveedor de conmutadores se comprometa realmente a entregar.
- Tratar las demostraciones de Ultra Ethernet en FPGA (como la demostración en bucle de retorno de DYNANIC en el Altera Innovators Day) como herramientas de aprendizaje del entramado y de visualización de la congestión, no como datos para planificar capacidad.
- Redactar pruebas de aceptación para el despliegue de algoritmos PCM: versiones fijadas, trabajos canario y desactivación automática ante pérdidas patológicas.
- Separar los proyectos de campus y DCI de esta línea de trabajo, para que la óptica ZR y las cabeceras UFH no compartan el mismo registro de riesgos.
Estos puntos obligan también a una clarificación organizativa: los equipos de redes, de aceleradores y de plataforma de ML deben compartir un único responsable de la hoja de ruta de Ultra Ethernet. Las especificaciones avanzan al ritmo de los calendarios de los consorcios; los clústeres, al de los calendarios de gestión de cambios. Tender un puente entre ambos es el verdadero trabajo de adopción de la 1.1.
Perspectivas
La especificación Ultra Ethernet v1.1 es el momento en que el UEC extiende públicamente el Ethernet para IA desde «un mejor sucesor de RoCE para scale-out» hacia cabeceras de scale-up, operaciones colectivas en la red y control de congestión programable, con mejoras cuantitativas presentadas como afirmaciones del propio UEC (ahorro de bytes, aceleración de las comunicaciones de hasta 2 veces en el ejemplo de all-reduce con INC, mayor equidad gracias a CSIG). Las primeras demostraciones en FPGA muestran rutas de entramado en marcha; la completitud funcional del transporte aún está llegando. Para los compradores de infraestructura de IA a hiperescala, el paso práctico no es reescribir el clúster mañana, sino exigir hojas de ruta que contemplen la 1.1 en los contratos de tarjetas de red, conmutadores y software de operaciones colectivas que se firmen en el cuarto trimestre de 2026 y el primer semestre de 2027.
El panorama estratégico es similar para los equipos de aceleradores de IA y chips: el silicio de terminal que no pueda exponer un control sensible a CSIG y una correspondencia de Ultra Ethernet con forma de Verbs quedará fuera de las licitaciones a hiperescala aunque sus velocidades SerDes brutas parezcan correctas. A la inversa, los ASIC de conmutación que implementen la INC sin una recuperación robusta suspenderán las revisiones de fiabilidad a nivel de trabajo. La especificación 1.1 eleva el listón mínimo de lo que significa «Ethernet para IA» en una orden de compra.
El Ethernet abierto para IA ya no es un simple eslogan. Es una especificación versionada, con un PDF fechado, una línea de investigación sobre congestión y un circuito de demostraciones de hardware que acaba de ponerse en marcha. Hay que tratar la v1.1 como la lista de comprobación a la que los fabricantes deben responder ahora, y seguir midiendo el tiempo de finalización de los trabajos, no solo los logotipos de conformidad.
Lecturas relacionadas
- InfiniBand vs Ethernet para clústeres de IA: la guerra de fabrics en la fábrica de IA
- Dentro del conmutador de IA: la óptica coempaquetada pasa de la demostración de laboratorio a la red refrigerada por líquido
- Superfábricas de IA distribuidas: cómo se estira la red entre campus
- El rack de 1 MW: cómo los 800 V de corriente continua y la refrigeración con agua templada reconfiguran la fábrica de IA
Fuentes
- Ultra Ethernet Consortium — “Ultra Ethernet Consortium Releases Specification 1.1…” (12 October 2026). https://ultraethernet.org/ultra-ethernet-consortium-releases-specification-1-1-advancing-ai-and-hpc-networking/
- Ultra Ethernet Consortium — Ultra Ethernet Specification v1.1 (PDF, 12 October 2026). https://ultraethernet.org/wp-content/uploads/sites/20/2026/10/UE-Specification-1.1.pdf
- AMD — “AMD AI NIC Technology Driving AI-Ready Ethernet” (11 October 2026). https://www.amd.com/en/blogs/2026/amd-ai-nic–technology-driving-ai-ready-ethernet-.html
- DYNANIC — “Why Ultra Ethernet on FPGA matters… Insights from Altera Innovators Day 2026.” https://dyna-nic.com/ultra-ethernet-fpga-altera-innovators-day-2026-dynanic/
- DYNANIC — “DYNANIC at Altera Innovators Day 2026” (evento del 28 de octubre de 2026). https://dyna-nic.com/news/dynanic-at-altera-innovators-day-2026/
Imágenes: ilustraciones originales creadas para AndBeyond.Tech; no aparecen logotipos ni personas reales.