RoboColosseum y la carrera por medir la inteligencia física en el mundo real
Qué mide RoboColosseum en el mundo real: los niveles Open y Fine-tune, el progreso parcial, la W de Kendall entre plataformas y los resultados del Unitree G1.
Los modelos de lenguaje tuvieron su Chatbot Arena. Con las políticas robóticas es más difícil. La respuesta de un chatbot es una cadena de texto que se puede puntuar; una política robótica es un bucle cerrado con el mundo físico, en el que cada acción cambia la observación siguiente. La iluminación, la posición de la cámara, la colocación de los objetos y el desgaste del hardware alteran el resultado. Por eso la tasa de éxito de un solo laboratorio en un conjunto fijo de tareas es un indicador débil de la «inteligencia física».
RoboColosseum es un intento, en 2026, de medir ese indicador a gran escala y en el mundo real. El artículo que lo acompaña (Nguyen, Wang, Shailesh et al., arXiv:2611.02497) es una prepublicación de arXiv sin revisión por pares [1]. Describe una red de evaluación distribuida que abarca oficinas, hogares, campus y fábricas, con operadores a tiempo completo, un servicio compartido de ejecución de políticas y dos niveles complementarios. El estudio inicial se llevó a cabo del 17 de septiembre al 28 de octubre de 2026 y abarca cinco políticas de visión-lenguaje-acción (VLA) y tres agentes de IA de frontera en cuatro plataformas físicas [1].
Este artículo explica qué mide realmente el banco de pruebas, en especial el progreso parcial y la W de Kendall, e interpreta los resultados del Unitree G1 como lo hacen los autores: como resultados obtenidos con este protocolo, no como un veredicto general sobre el producto.
De RoboArena a RoboColosseum
RoboColosseum se basa en RoboArena, un marco de evaluación distribuida de 2025 para políticas generalistas en la plataforma DROID/Franka [2]. RoboArena (Atreya, Pertsch, Lee et al., arXiv:2506.18123; prepublicación de arXiv) recopilaba de forma colaborativa comparaciones por pares con doble ciego: los evaluadores elegían libremente las tareas y los escenarios, ejecutaban una tras otra dos políticas anonimizadas en condiciones locales equivalentes e indicaban su preferencia. A partir de 612 comparaciones por pares con robots reales en siete instituciones académicas, los autores sostuvieron que agregar esas preferencias clasificaba las políticas generalistas con más precisión que un conjunto de pruebas convencional, fijo y de un único centro, en relación con una clasificación «oráculo» exhaustiva [2].
RoboColosseum mantiene la idea de las comparaciones por pares en el mundo real y la amplía en tres ejes [1]:
- Más plataformas: SO-101, Franka en configuración DROID, Bimanual-YAM y el humanoide Unitree G1.
- Dos niveles: un Open Track (sin adaptación específica a la tarea) y un Fine-tune Track (con un presupuesto fijo de demostraciones).
- Escala operativa: el artículo informa de 5699 comparaciones por pares en el Open Track en 124 centros, además de evaluaciones de Fine-tune en 20 tareas (cinco por plataforma) [1].
Entre los colaboradores fundadores que cita la prepublicación figuran grupos de la NUS, Hugging Face, el Singapore Embodied AI Centre y BitRobot. El proyecto se compromete a ofrecer 10 000 horas de evaluación gratuita a sus socios académicos [1].
Los dos niveles, en pocas palabras
Open Track: generalización sin ajuste fino
Un evaluador idea una tarea factible con objetos disponibles en el lugar, redacta una instrucción en lenguaje natural y recibe dos modelos elegibles anonimizados. Ambos se ejecutan en el mismo robot y con la misma configuración. El evaluador registra una preferencia (gana A, gana B o empate), puntuaciones de progreso, comentarios libres y una valoración de la dificultad de 1 a 10 [1].
Como la dificultad de las tareas varía enormemente, las tasas de victoria en bruto serían engañosas. RoboColosseum clasifica los sistemas del Open Track con un modelo de Rasch calibrado por dificultad (DCR): cada política recibe una capacidad latente y cada tarea una dificultad latente, y las valoraciones humanas de dificultad actúan como distribución a priori sobre esa dificultad. Los resultados de los ensayos actualizan después ambas. Para la clasificación pública, las capacidades se trasladan a una escala de tipo Elo; la conversión es lineal y no altera el orden [1].
Un emparejamiento activo (inspirado en Chatbot Arena) concentra los nuevos ensayos en los pares de modelos cuyo orden sigue siendo incierto. Según el análisis de los autores, el emparejamiento activo alcanza alrededor de un 90 % de coincidencia con la clasificación basada en todos los datos tras unas 400 o 500 evaluaciones, frente a unas 1000 con un muestreo uniforme [1].
Fine-tune Track: adaptación con un presupuesto fijo de datos
Aquí la pregunta es otra: con las mismas 100 demostraciones teleoperadas por tarea, ¿hasta qué punto se adapta cada VLA? Cada política aplica su receta oficial de ajuste fino hasta la convergencia; los datos y el protocolo de evaluación se mantienen fijos, mientras que los detalles del entrenamiento pueden variar según la arquitectura [1]. Tras el ajuste fino, cada par política-tarea se somete a N = 25 ensayos de evaluación [1].
Las tareas abarcan coger y colocar, apilar, reorientar, objetos articulados, objetos deformables, verter líquidos, usar herramientas, coordinar dos brazos y la locomanipulación en el G1 [1].
Qué significa el «progreso parcial»
El criterio binario de éxito es implacable. Una política que cierra casi del todo un portátil y otra que ni siquiera toca la pantalla obtienen ambas un cero si se exige el cierre completo. Por eso RoboColosseum define criterios de progreso específicos para cada tarea, una lista de hitos intermedios [1].
En cada ejecución, sea K el número de criterios y s el número de criterios cumplidos (el orden no tiene por qué ser fijo). El progreso normalizado de la ejecución es s / K. La media de los N ensayos da la puntuación de progreso (PS). Por separado, la tasa de éxito (SR) es la proporción de ensayos que cumplen la definición completa de éxito [1]:
- La PS responde a la pregunta: ¿qué parte de la tarea completó la política de media?
- La SR responde a la pregunta: ¿con qué frecuencia la terminó?
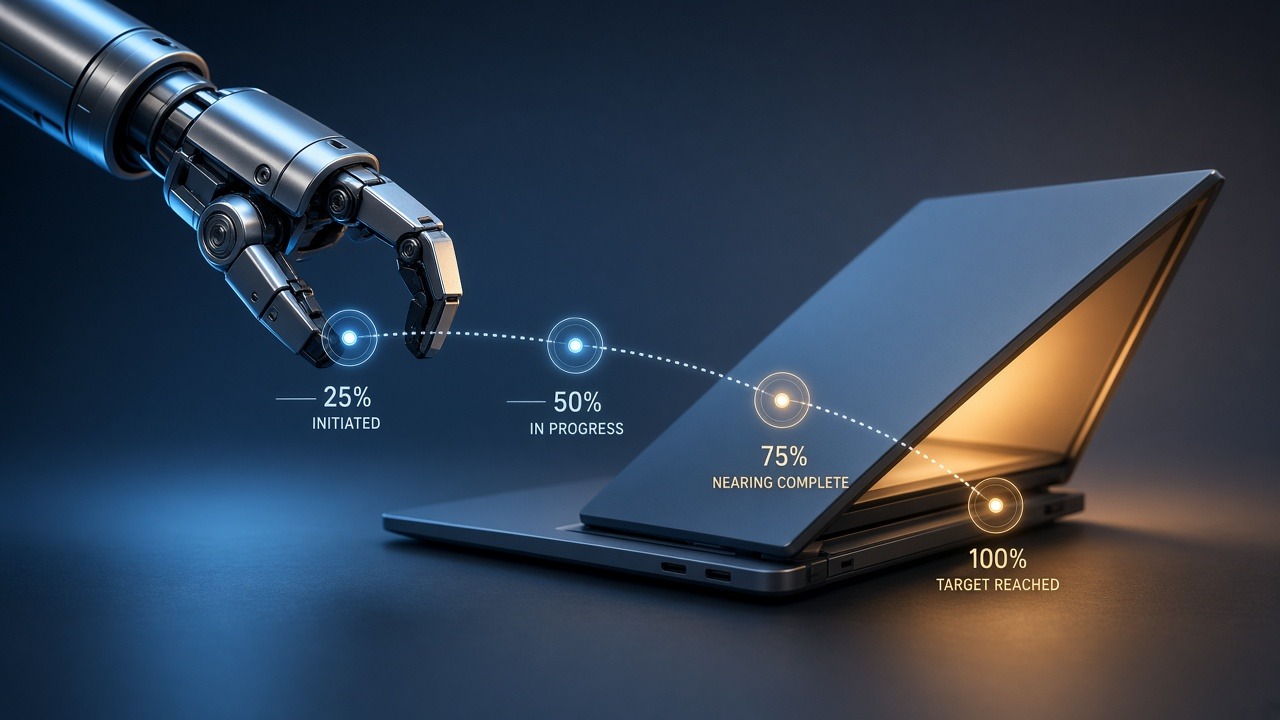
Esa distinción importa sobre todo en las plataformas difíciles. En el conjunto de tareas del Fine-tune Track para el Unitree G1, ninguna política evaluada completa ninguna de las cinco tareas (SR = 0 % en cada par modelo-tarea de la tabla publicada). Aun así, las puntuaciones medias de progreso las diferencian: aproximadamente del 13,3 % al 23,2 % en las cinco políticas [1]. El progreso parcial es la manera que tiene el banco de pruebas de decir que «nadie cruzó la meta, pero no todos fracasaron del mismo modo».
Qué significa la W de Kendall
Tras el ajuste fino, los autores se preguntan si las mismas políticas obtienen clasificaciones similares en los cuatro conjuntos de tareas específicos de cada plataforma. Informan de un coeficiente de concordancia de Kendall W = 0,24 [1].
Dicho de forma sencilla, la W de Kendall mide cuánto coinciden varias clasificaciones. Va de 0 (ninguna coincidencia: las clasificaciones parecen aleatorias entre sí) a 1 (coincidencia perfecta: todas las plataformas ordenan las políticas de la misma manera). Un valor de 0,24 indica una coincidencia débil. Saber qué política gana en SO-101 no permite predecir con fiabilidad cuál ganará en Franka, Bimanual-YAM o G1 con este protocolo de Fine-tune [1].
Algunos ejemplos concretos de las medias de Fine-tune de la prepublicación [1]:
- GR00T N1.7 lidera en SO-101 (PS media de alrededor del 89 % y SR de alrededor del 82 %), pero queda en la zona media en Franka y YAM.
- π0.5 lidera en DROID/Franka (PS de alrededor del 91 % y SR de alrededor del 84 %) y en Bimanual-YAM (PS de alrededor del 97 % y SR de alrededor del 94 %).
- Las clasificaciones también se invierten entre el Open Track y el Fine-tune Track en las plataformas comunes: la solidez en entornos abiertos no predice con fiabilidad la solidez tras la adaptación [1].
Para los equipos que compran o ajustan una política fundacional, esa es la conclusión práctica: la evaluación específica de cada plataforma y cada tarea sigue siendo imprescindible. Una única cifra en una clasificación no basta.
Leer con cuidado el resultado del Unitree G1
El Fine-tune Track evalúa cinco tareas de locomanipulación en un Unitree G1 configurado para este banco de pruebas (pinzas paralelas, teleoperación con Pico VR para las 100 demostraciones y especificaciones de observación y acción compartidas por todos los centros) [1]. Puntuaciones medias de progreso publicadas con ese protocolo [1]:
| Política (Fine-tune Track, media en G1) | Puntuación de progreso (PS) | Tasa de éxito (SR) |
|---|---|---|
| LingBot-VLA v2 | 23,2 % | 0 % |
| GR00T N1.7 | 22,7 % | 0 % |
| MolmoAct2 | 19,8 % | 0 % |
| π0.5 | 16,3 % | 0 % |
| G0.5 | 13,3 % | 0 % |
Estas cifras no son un veredicto general sobre el Unitree G1 como producto. Son resultados de puntos de control VLA concretos, ajustados para cinco tareas de RoboColosseum, con esta configuración de hardware, estas demostraciones, estos criterios de progreso y estas reglas de parada de seguridad [1]. Otra pila de control, una teleoperación de distinta calidad, otras tareas o la pila de autonomía propietaria de un fabricante podrían ofrecer resultados completamente distintos. La lectura honesta es más acotada: con este protocolo público de Fine-tune, los VLA generalistas actuales solo logran un progreso parcial modesto en estas tareas del G1 y no las completan.
Esa lectura sigue siendo útil. Muestra por qué la locomanipulación humanoide es una prueba de esfuerzo para los modelos fundacionales VLA y por qué las métricas de progreso deben figurar junto a las tasas de éxito cuando la meta rara vez se cruza.
Qué más muestra el Open Track
Algunas conclusiones generales del análisis del Open Track de la prepublicación, cada una limitada a las comparaciones recopiladas [1]:
- Los agentes de frontera pueden competir con los VLA especializados en progreso de manipulación en las comparaciones por pares, aunque la ventaja depende del agente y de la plataforma. En 901 evaluaciones emparejadas entre agentes y VLA, los agentes progresaron más en 394 comparaciones y los VLA en 265, con 242 empates [1].
- La fortaleza relativa no equivale a completar tareas de forma fiable. Incluso los sistemas mejor situados registran a menudo tasas de éxito absolutas bajas en las categorías de entorno abierto; el artículo indica que ningún sistema evaluado superó el 13 % de éxito en ninguna de sus seis categorías de manipulación en la parte del Open Track analizada [1].
- Las tareas más difíciles fallan antes. El éxito completo cae de alrededor del 30,7 % en las dificultades valoradas de 1 a 4 a alrededor del 0,4 % en las de 9 a 10, y el progreso normalizado medio baja de alrededor del 56,6 % a alrededor del 3,5 % en las mismas franjas [1].
Junto con los resultados de Fine-tune, el panorama coincide con lo que muchos laboratorios perciben a diario: las demostraciones impresionan, pero completar tareas de forma sistemática en entornos reales sigue siendo escaso, y por eso las herramientas de sim-to-real y las capas de RL posteriores a la imitación siguen atrayendo atención.
La fiabilidad de la clasificación también se mide
Un banco de pruebas distribuido solo es tan fiable como la coincidencia entre las distintas partes de su red. RoboColosseum lo comprueba dividiendo repetidamente los centros de evaluación en dos mitades disjuntas, ajustando el modelo DCR en cada una y midiendo con qué frecuencia coincide el orden de los pares de modelos [1]. En DROID/Franka y Bimanual-YAM, la coincidencia media de las clasificaciones por pares ronda el 85 % (ρ de Spearman medio de alrededor de 0,82). En SO-101 es menor, en torno al 59 % con un ρ de alrededor de 0,30, de modo que el orden del Open Track en esa plataforma es más sensible a los centros que contribuyen [1].
La escala ayuda. Subconjuntos aleatorios del Open Track alcanzan alrededor de un 90 % de coincidencia media con la clasificación completa de 5699 comparaciones en torno a las 1123 evaluaciones, y alrededor de un 95 % en torno a las 4755, aunque la franja de percentiles alrededor de esas medias sigue siendo amplia [1]. Dicho de otro modo: unos cientos de ensayos por pares bien elegidos ya recuperan de media buena parte de la clasificación, pero una estabilidad de alta confianza sigue exigiendo miles de comparaciones físicas.
Esa honestidad estadística forma parte de lo que distingue un programa de medición de una sesión de fotos publicitaria. También explica el compromiso del proyecto de ofrecer horas gratuitas de evaluación a los académicos: más diversidad de centros reduce la probabilidad de que la iluminación y el desorden de un único laboratorio definan el «estado del arte» [1].
Por qué importa este tipo de banco de pruebas
RoboColosseum no sustituirá a los estudios cuidadosos centrados en un solo factor. Los propios autores lo admiten: la cobertura sigue dependiendo de qué puntos de control y robots pueden participar, el Fine-tune Track utiliza por ahora cinco tareas por plataforma, y permitir la receta oficial de ajuste fino de cada modelo implica que este nivel mide la adaptación de extremo a extremo a partir de datos compartidos y no con un optimizador perfectamente idéntico [1]. La evaluación por pares en el mundo real también sacrifica control experimental a cambio de diversidad, la misma disyuntiva que asumió RoboArena [2].
Lo que sí ofrece es una regla de medir compartida y en crecimiento. La inteligencia física necesita algo así si el sector quiere distinguir los vídeos promocionales de los avances reproducibles. El progreso parcial conserva la señal cuando las tasas de éxito rozan el cero. La W de Kendall advierte contra generalizar en exceso una victoria obtenida con un solo brazo. Y presentar las cifras del Unitree G1 como resultados condicionados por el banco de pruebas, no como puntuaciones de producto, es la forma de que esa regla siga siendo honesta.
Conclusión
RoboColosseum es menos una clasificación única que un programa de medición: enfrentamientos por pares en entornos abiertos, carreras de ajuste fino controladas, listas de hitos de progreso y pruebas de concordancia entre plataformas. La primera instantánea (finales de 2026, en prepublicación) ya muestra a agentes de frontera disputando posiciones con los VLA, una coincidencia débil de las clasificaciones entre plataformas (W = 0,24) y una locomanipulación humanoide en la que existe progreso parcial pero no éxito completo con el protocolo indicado. Si cada cifra se trata como dependiente de los robots, las tareas y las reglas que la produjeron, el banco de pruebas resulta útil y no teatral.
Lecturas relacionadas
- Modelos visión-lenguaje-acción: la nueva capa base de los robots
- Sim-to-real en 2026: cerrar la brecha sin datos reales infinitos
- Después de la imitación: el aprendizaje por refuerzo residual y en el mundo real, nueva capa de las políticas robóticas
Referencias / fuentes
- Tan Sang Nguyen, Yi Ru Wang, Shailesh Shailesh et al. — «RoboColosseum: Evaluating Physical Intelligence at Scale In-The-Wild», arXiv:2611.02497 (prepublicación de arXiv, sin revisión por pares). Evaluaciones realizadas del 17 de septiembre al 28 de octubre de 2026. https://arxiv.org/abs/2611.02497
- Pranav Atreya, Karl Pertsch, Tony Lee et al. — «RoboArena: Distributed Real-World Evaluation of Generalist Robot Policies», arXiv:2506.18123 (prepublicación de arXiv). https://arxiv.org/abs/2506.18123 · https://robo-arena.github.io
- Lectura relacionada: AndBeyond.Tech — Modelos visión-lenguaje-acción: la nueva capa base de los robots.
- Lectura relacionada: AndBeyond.Tech — Sim-to-real en 2026: cerrar la brecha sin datos reales infinitos.
Imágenes: ilustraciones originales creadas para AndBeyond.Tech; no aparecen logotipos ni personas reales.