Después de la imitación: el aprendizaje por refuerzo residual y en el mundo real, nueva capa de las políticas robóticas
RL residual y RL en el mundo real sobre políticas VLA entrenadas por imitación en 2026: el residual simulado de Microsoft y la experiencia selectiva de Evo-RL.
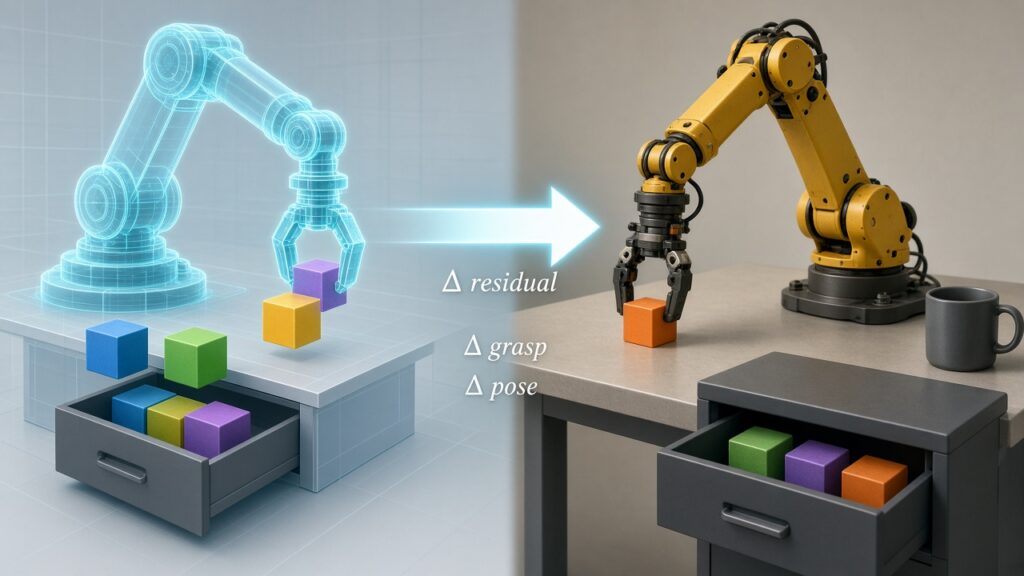
El aprendizaje por imitación sacó los modelos fundacionales robóticos del laboratorio y los llevó a hardware muy diverso. Los modelos visión-lenguaje-acción (VLA) ya pueden convertir imágenes de cámara e instrucciones en lenguaje natural en comandos motores para muchas tareas. Pero quien haya observado la ejecución de una tarea larga conoce su punto débil: los pequeños errores de ejecución se acumulan. Un agarre desviado un centímetro se convierte tres segundos después en una inserción fallida. Los datos de demostración rara vez cubren esos estados de recuperación, de modo que una política entrenada solo por imitación apenas sabe qué hacer a continuación.
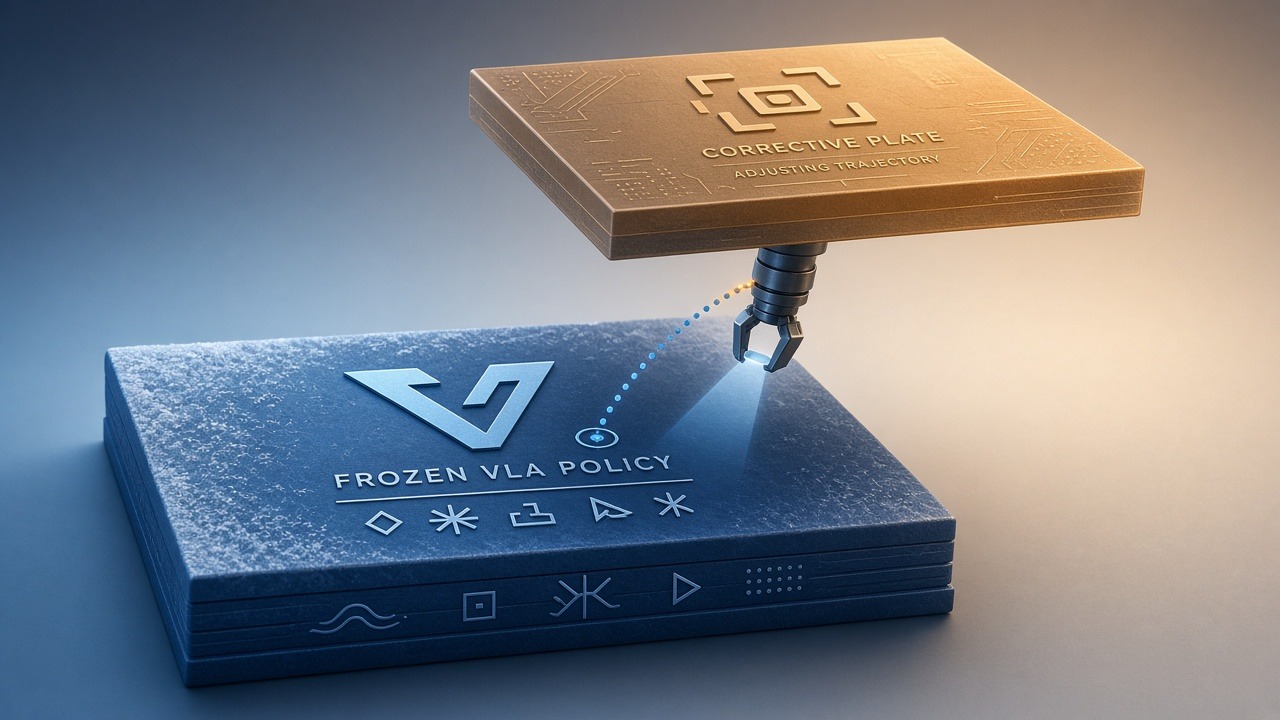
En 2026, un número creciente de trabajos aborda esa brecha como un problema de aprendizaje independiente. En lugar de sustituir el VLA, los investigadores añaden una nueva capa: un aprendizaje por refuerzo (RL) residual que corrige la política base, que permanece congelada, y bucles de RL en el mundo real que reutilizan de forma selectiva la experiencia del despliegue. Este artículo explica esas ideas vinculando cada cifra a los robots y las tareas que la produjeron, y las sitúa junto a las herramientas de sim-to-real que hacen viables los residuales entrenados en simulación.
Por qué la imitación por sí sola se estanca
Un VLA suele entrenarse mediante clonación de comportamiento o emparejamiento de flujos (flow matching) a partir de demostraciones teleoperadas. Así aprende el comportamiento exitoso medio del conjunto de datos, pero no se optimiza expresamente para recuperarse cuando el robot se aparta de la variedad de las demostraciones. La línea de trabajo RECAP de Physical Intelligence, y otros sistemas de RL en el mundo real, parten de esa observación: una vez desplegada la política, las intervenciones humanas y las ejecuciones autónomas se convierten en una nueva fuente de datos para mejorar la robustez y el rendimiento [4][5].
Han surgido dos estrategias complementarias:
- RL residual. El VLA se mantiene congelado. Se entrena una política correctora más pequeña que suma un incremento a la acción del VLA. El residual puede entrenarse en simulación si sus observaciones se trasladan sin problemas al mundo real.
- RL iterativo en el mundo real. Se despliega la política, se recogen las intervenciones y los episodios autónomos y, después, se actualiza la propia política con estimaciones de valor que favorecen un comportamiento eficiente y con pocas intervenciones.
Ambas se sitúan después de la imitación. Presuponen que ya existe un modelo base competente.
RL residual en simulación que se transfiere sin adaptación
El trabajo de Microsoft Research Object-Centric Residual RL for Zero-Shot Sim-to-Real VLA Enhancement, aceptado en la Conference on Robot Learning (CoRL) de 2026 en Austin, plantea una pregunta precisa: ¿puede una política de aprendizaje por refuerzo entrenada solo en simulación mejorar un VLA en el mundo real sin ningún RL en el robot [1][2]?
Los autores identifican un dilema conocido del sim-to-real aplicado a los residuales. Los residuales basados en un estado privilegiado necesitan destilarse antes de poder ejecutarse en el robot. Los basados en imágenes heredan la brecha visual con la realidad. El RL en el mundo real es caro e inseguro. Su respuesta es un residual centrado en objetos: la política correctora observa las poses de seis grados de libertad de los objetos relevantes para la tarea, el estado propioceptivo del robot y la acción actual del VLA base, no las imágenes en bruto de la cámara [1][2].
El proceso consta de tres etapas [1]:
- VLA emparejados en simulación y en la realidad. Se parte de un VLA entrenado con teleoperación real. Se reproducen las mismas acciones de teleoperación en simulación para entrenar un homólogo simulado, de modo que ambos VLA sigan alineados en el espacio de acciones aunque sus píxeles difieran.
- Entrenamiento del residual en simulación. El residual se entrena con inyección de ruido en las poses y eliminación aleatoria de poses para que tolere estimaciones imperfectas en el mundo real.
- Despliegue sin adaptación (zero-shot). En la prueba se sustituye el VLA por el real y se suma el mismo residual a cada acción, sin ningún ajuste fino del residual en el robot.
Resultados en un Franka Research 3
Todas las cifras con robot real que figuran a continuación proceden de cinco tareas de manipulación sobre mesa con un Franka Research 3 (FR3), con 20 ensayos por tarea [1][2]. El VLA base del artículo se apoya en una arquitectura de tipo GR00T-N1.5 [2]. Las tareas son: Cube Lift (levantar un cubo), Pick-and-Place (coger y colocar), Stack Cube (apilar un cubo), Close Drawer (cerrar un cajón) y Stand Cup Up (poner de pie un vaso).
| Tarea | Base real (éxitos sobre 20) | Real con residual |
|---|---|---|
| Cube Lift | 7 / 20 | 17 / 20 |
| Pick-and-Place | 9 / 20 | 16 / 20 |
| Stack Cube | 7 / 20 | 15 / 20 |
| Close Drawer | 14 / 20 | 20 / 20 |
| Stand Cup Up | 5 / 20 | 8 / 20 |
| Media | 8,4 / 20 (42 %) | 15,2 / 20 (76 %) |
El residual mejora todas las tareas sin adaptación. La tasa media de éxito con robot real sube del 42 % al 76 % sin aprendizaje por refuerzo en el mundo real ni ajuste fino de la política residual [1][2]. En los episodios exitosos, los autores también informan de tiempos de ejecución más cortos, con reducciones de entre el 9 % y el 22 % aproximadamente según la tarea [1].
Hay un segundo beneficio. Las ejecuciones corregidas por el residual pueden agregarse y utilizarse para reentrenar el VLA base, lo que convierte un módulo de corrección específico de una tarea en un bucle de automejora que no requiere teleoperación adicional [1][2]. El RL residual actúa así a la vez como parche en el momento de la inferencia y como generador de datos.
RL en el mundo real con experiencia selectiva: Evo-RL
Los residuales entrenados en simulación son una vía. La otra consiste en mejorar la política a partir de la experiencia obtenida con el robot real. Evo-RL (Ye, Jin, Luo et al., arXiv:2610.13345, octubre de 2026) es un método iterativo que combina intervenciones humanas con una selección de la experiencia guiada por la ventaja [3]. Este artículo es una prepublicación de arXiv que no había pasado la revisión por pares en el momento de redactar este texto.
Evo-RL parte de una política entrenada con demostraciones y basada en la arquitectura π0.5 (una base de visión y lenguaje PaliGemma más un experto de acción por emparejamiento de flujos) [3]. Durante el despliegue, un operador interviene cuando la política se atasca. A continuación, el método:
- Conserva solo las partes controladas por la persona de las trayectorias de intervención exitosas para un ajuste fino correctivo.
- Entrena un modelo de valor basado únicamente en la visión, con recompensas que penalizan tanto el tiempo como las tomas de control humanas.
- Estima las ventajas y selecciona los segmentos de mayor ventaja de las demostraciones y de las ejecuciones autónomas exitosas, en lugar de tratar todos los fotogramas por igual.
- Vuelve a desplegar la política actualizada para la siguiente ronda [3].
Los autores lo contraponen a RECAP, que condiciona el entrenamiento de la política a una etiqueta binaria de ventaja sobre la experiencia acumulada [3][5]. Evo-RL, en cambio, utiliza las ventajas estimadas para filtrar y reponderar la experiencia.
A qué corresponden las cifras
Evo-RL se evalúa en dos plataformas reales con un límite de cinco minutos por ensayo [3]:
AgileX PiperX: inserción de tornillos de alta precisión. Cinco pares de tornillo y casquillo se colocan sobre una mesa. Cualquiera de los dos brazos puede insertar un tornillo en un casquillo sostenido por el otro. La evaluación mide la tasa de éxito de los intentos (ASR) y el rendimiento en cinco unidades de inserción sucesivas, con un objetivo de N = 10 éxitos por unidad [3].
Con ese protocolo (tabla II de la prepublicación) [3]:
- Ajuste fino supervisado (SFT) solo con demostraciones: 22,73 % de ASR.
- SFT más una hora de intervenciones humanas: 78,72 % de ASR.
- RECAP: 57,78 % de ASR.
- Primera ronda de Evo-RL: 88,24 % de ASR y 60,61 etapas exitosas por hora.
- Segunda ronda de Evo-RL: 92,16 % de ASR y 67,14 etapas por hora.
La cifra destacada del resumen, según la cual la primera ronda de Evo-RL mejora la ASR en 30,46 puntos porcentuales frente a RECAP, es exactamente 88,24 − 57,78 con este protocolo de inserción en PiperX [3]. No es una afirmación aplicable a cualquier robot o tarea.
SO-101: plegado de camisetas. Cinco camisetas amontonadas sin orden; las unidades abarcan recoger, extender, doblar por la mitad, doblar las mangas y doblar desde el bajo hasta el cuello, con N = 20 por etapa [3]. La versión completa de Evo-RL eleva la ASR del 55,56 % (SFT) al 76,67 %, y el rendimiento de 75,78 a 90,00 etapas exitosas por hora [3].
Un elemento de apoyo es RW-RL-Dataset: más de 1000 horas de interacción real con cuatro plataformas (AgiBot G2, Galaxea R1Lite, AgileX PiperX y SO-101), con etiquetas a nivel de fotograma que indican si el control lo tenía la persona o la política [3]. El código y los puntos de control se publican junto con la prepublicación [3].
Cómo encajan las dos capas
El RL residual en simulación y el RL iterativo en el mundo real no son rivales. Atacan cuellos de botella distintos:
| Capa | Dónde aprende | Qué congela | Su punto fuerte |
|---|---|---|---|
| Residual centrado en objetos [1][2] | Solo en simulación | Los pesos del VLA base | Correcciones precisas cuando se dispone de las poses de los objetos; transferencia sin adaptación |
| Evo-RL [3] | Robot real y reutilización selectiva | Nada de forma permanente: la política se actualiza en cada ronda | Recuperarse de los fallos del despliegue con poca ayuda humana |
Los equipos industriales querrán a menudo ambos. Los residuales en simulación (y la pila de sim-to-real en general) sirven para elevar el suelo a bajo coste. Los bucles de RL en el mundo real permiten ir más allá en los fallos con mucho contacto físico o de cola larga que todavía escapan al gemelo digital. El VLA sigue siendo la base; las capas de RL son la forma de que esa base deje de ser frágil.
La propia CoRL 2026, que se celebra del 9 al 12 de noviembre en Austin (Texas), es un escenario natural para este cambio: el artículo sobre RL residual centrado en objetos figura en el programa de la conferencia, mientras que los conjuntos de datos y los métodos iterativos de RL en el mundo real siguen llegando como prepublicaciones que la comunidad pondrá a prueba en los próximos meses [6][1][3].
Qué deben extraer los equipos industriales
Para los pilotos en fábricas y almacenes, el resultado del residual es aplicable de inmediato, porque no obliga a los operadores a ejecutar un RL arriesgado en el robot. Si se pueden estimar las poses de los objetos en las habilidades que importan (cajones, vasos, cubos, objetivos de coger y colocar), un residual entrenado en simulación puede elevar el éxito de un VLA de tipo GR00T congelado con el protocolo FR3 descrito [1][2]. El bucle de automejora convierte después las ejecuciones corregidas en nuevos datos supervisados, algo muy atractivo cuando los teleoperadores son el recurso escaso.
El mensaje de Evo-RL es distinto y complementario. En la inserción de tornillos con PiperX, combinar intervenciones con una reutilización guiada por la ventaja superó tanto a las intervenciones por sí solas como a RECAP según las métricas de ASR y rendimiento de los autores [3]. En el plegado con SO-101, el mismo bucle redujo los intentos repetidos en la etapa de extender la prenda y elevó la ASR global [3]. Esa pauta importa para la robótica industrial con IA: dedicar el tiempo de las personas a los modos de fallo que la política actual sufre de verdad y dejar que las estimaciones de valor decidan qué fotogramas autónomos merecen más peso.
Ninguno de los dos artículos sostiene que el RL residual o en el mundo real sustituya a mejores modelos base, a datos sintéticos más ricos o a una identificación cuidadosa del sistema. Afirman algo más acotado y útil: una vez que se dispone de un VLA, existe una capa siguiente medible.
Límites que conviene no perder de vista
- Dependencia de las poses. Los residuales centrados en objetos necesitan estimaciones fiables de seis grados de libertad de los objetos adecuados. Las escenas abarrotadas y la selección autónoma de objetos siguen siendo problemas abiertos que los autores de Microsoft señalan para trabajos futuros [1].
- Coste humano. Evo-RL sigue necesitando operadores para las intervenciones, aunque las correcciones específicas superen a las demostraciones adicionales con el mismo presupuesto [3].
- Alcance de las afirmaciones. El resultado del residual, del 42 % al 76 %, corresponde a cinco tareas con FR3 y 20 ensayos cada una [1][2]. La ganancia de 30,46 puntos de Evo-RL frente a RECAP corresponde a la inserción de tornillos en PiperX con el protocolo de ASR de la prepublicación [3]. Ninguno de los dos es una clasificación universal de robots.
- Condición de prepublicación. Las cifras de Evo-RL proceden de una prepublicación de arXiv que no ha completado la revisión por pares [3].
Conclusión
La imitación dio lugar a las primeras políticas robóticas generalistas realmente útiles. La siguiente capa consiste en aprender de los errores, ya sea entrenando en simulación un residual corrector que se apoya en un VLA congelado, ya sea iterando sobre despliegues reales con experiencia selectiva. En ambos casos el planteamiento es el mismo: conservar el modelo fundacional y enseñarle a no fallar en el último centímetro.
Lecturas relacionadas
- Modelos visión-lenguaje-acción: la nueva capa base de los robots
- Sim-to-real en 2026: cerrar la brecha sin datos reales infinitos
- RoboColosseum y la carrera por medir la inteligencia física en el mundo real
Referencias / fuentes
- Kinam Kim, Namiko Saito, Heecheol Kim, Katsushi Ikeuchi, Jaegul Choo, Yasuyuki Matsushita — «Object-Centric Residual RL for Zero-Shot Sim-to-Real VLA Enhancement», artículo de Microsoft Research (17 de junio de 2026); Conference on Robot Learning (CoRL) 2026. https://www.microsoft.com/en-us/research/articles/object-centric-residual-rl/ · https://www.microsoft.com/en-us/research/publication/object-centric-residual-rl-for-zero-shot-sim-to-real-vla-enhancement/
- El mismo trabajo como prepublicación: arXiv:2606.18953 (junio de 2026). Publicación revisada por pares: CoRL 2026. https://arxiv.org/abs/2606.18953
- Kai Ye, Yifan Jin, Qianhang Luo et al. — «Evo-RL: Iterative Robot Reinforcement Learning from Selective Experience», arXiv:2610.13345 (prepublicación de arXiv, sin revisión por pares). https://arxiv.org/abs/2610.13345
- Physical Intelligence et al. — «π*0.6: a VLA that learns from experience» (RECAP), según lo cita Evo-RL; véanse también las novedades de investigación de Physical Intelligence. https://www.pi.website/
- Contexto sobre los fundamentos de los VLA y las mejoras de tipo RECAP: AndBeyond.Tech — Modelos visión-lenguaje-acción: la nueva capa base de los robots.
- Conference on Robot Learning 2026 — web de la conferencia (Austin, Texas, del 9 al 12 de noviembre de 2026). https://2026.corl.org/
- Lectura relacionada: AndBeyond.Tech — Sim-to-real en 2026: cerrar la brecha sin datos reales infinitos.
Imágenes: ilustraciones originales creadas para AndBeyond.Tech; no aparecen logotipos ni personas reales.