Mercado de aceleradores de IA: GPU, ASIC a medida y quién gana la inferencia
GPU vs ASIC a medida en el mercado de aceleradores de IA: NVIDIA, AMD, TPU de Google, Trainium, Maia, MTIA, Groq, Cerebras — y quién gana la inferencia.
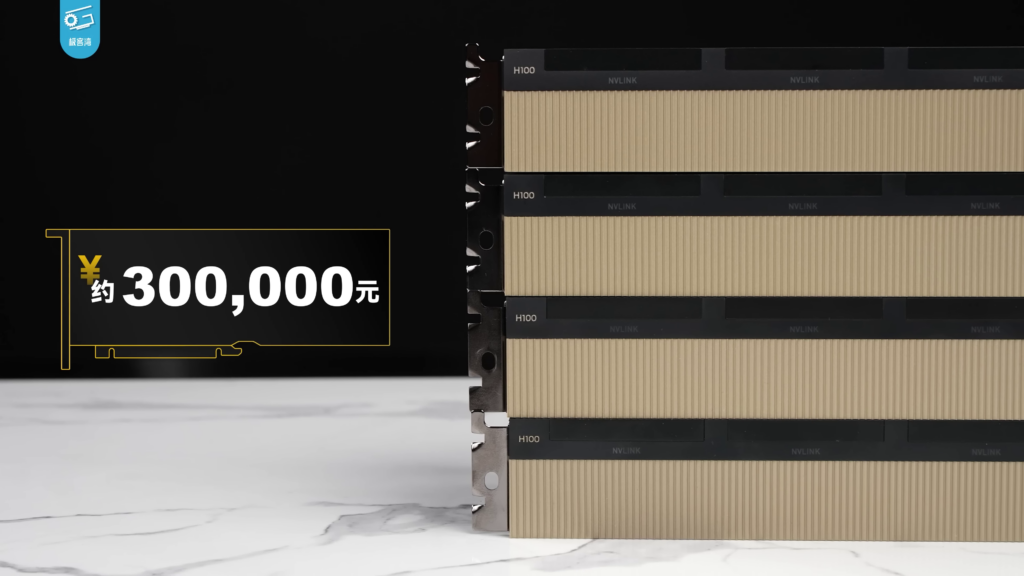
Los aceleradores de IA durante mucho tiempo significaron una sola cosa: una GPU NVIDIA. Hoy el campo está lleno. Los hiperescaladores fabrican sus propios chips, AMD ha cerrado un cliente de varios gigavatios y startups pensadas solo para inferencia firman con los mayores laboratorios. Esta guía mapea quién construye qué, dónde encaja cada familia de silicio entre entrenamiento e inferencia, y por qué el debate GPU vs ASIC se centra ya en servir tokens más que en entrenar modelos.
Por qué cambió el mapa de aceleradores
Durante la mayor parte de la era del deep learning, el mercado de aceleradores de IA giraba sobre un solo volante. Las GPU NVIDIA más el ecosistema software CUDA eran el valor por defecto tanto para entrenar modelos como para ejecutarlos. Ese valor por defecto sigue vigente en muchos sitios. Lo que ha cambiado es la forma de la demanda. Laboratorios de frontera y proveedores cloud hacen correr modelos para un número enorme de usuarios las 24 horas. El coste de producir cada token, y la energía que esa producción consume, se ha convertido en un problema de negocio de primer orden.
Los proveedores lo dicen abiertamente. Google presentó su TPU de séptima generación, Ironwood, como «the first Google TPU for the age of inference» [3]. Microsoft lanzó Maia 200 como «the AI accelerator built for inference», construido «to dramatically improve the economics of AI token generation» [6]. En sus propias palabras, la estrategia de computación de OpenAI busca «to build a resilient portfolio that matches the right systems to the right cargas de trabajo» [11]. La frase right systems to the right cargas de trabajo resume el mercado en 2026: ningún chip tiene que ganarlo todo, y los compradores mezclan proveedores de forma activa.
El establecido: la escala de NVIDIA
Cualquier mapa de chips de inferencia de IA y silicio de entrenamiento empieza por NVIDIA, porque nadie más opera a su escala. En los resultados del segundo trimestre fiscal 2027, publicados el 26 de agosto de 2026, NVIDIA anunció unos ingresos totales de 96.200 millones de dólares, un 106 % más interanual. Los ingresos de Data Center fueron 89.000 millones, un 117 % más [1]. El comentario del CFO presentado ante la SEC desglosa más. Los clientes hiperescala aportaron 48.700 millones. La categoría «AI Clouds, Industrial, & Enterprise» aportó 40.300 millones y creció un 138 % interanual [2]. El comentario atribuye el crecimiento a «the ramp of our Blackwell Ultra infrastructure» [2].
Los anuncios del mismo comunicado muestran cómo NVIDIA defiende su posición. La plataforma Vera Rubin está «ramping into full production», con racks en CoreWeave, Google Cloud, Microsoft Azure, Oracle Cloud Infrastructure y Nebius [1]. También indica que «NVIDIA Groq 3 LPX, the interactive AI inference accelerator, is now in full production» [1]. Es notable: el mayor vendedor de GPU del mundo comercializa ya una línea basada en tecnología licenciada de una startup ASIC de inferencia (más abajo).
La lista de clientes también muestra cómo se cubren los laboratorios. En noviembre de 2025 la compañía anunció una asociación con OpenAI para desplegar «at least 10 gigawatts of NVIDIA systems». También dijo que «for the first time, Anthropic will run and scale on NVIDIA infrastructure, initially adopting 1 gigawatt of cómputo capacity» [12]. Anthropic es además uno de los clientes estrella de Trainium en AWS [8][9]. Comprar a varios proveedores es ya lo normal.
La otra GPU: la cabeza de puente multi-gigavatio de AMD
AMD es la principal alternativa GPU mercantil. Su gran avance llegó el 6 de octubre de 2025, cuando AMD y OpenAI anunciaron «a 6 gigawatt agreement to power OpenAI’s next-generation AI infrastructure across multiple generations of AMD Instinct GPUs». El primer despliegue de un gigavatio de GPU Instinct MI450 debe empezar en la segunda mitad de 2026 [4]. AMD describe una colaboración que «began with the MI300X and continued with the MI350X series». Emitió a favor de OpenAI un warrant de hasta 160 millones de acciones AMD que veste según hitos de despliegue y de cotización [4]. El CFO de AMD dijo que la asociación «expected to deliver tens of billions of dollars in revenue for AMD» [4].
El punto estratégico es claro. Un comprador de GPU que quiera apalancamiento y seguridad de suministro tiene ya una segunda fuente de GPU programable a escala frontera. En la cuestión GPU vs ASIC, AMD sigue en el lado GPU: procesadores paralelos flexibles y de propósito general, vendidos a quien los quiera, en lugar de chips diseñados en torno a las cargas de una sola casa.
Los ASIC de los hiperescaladores
Los circuitos integrados de aplicación específica (ASIC) cambian generalidad por eficiencia en un conjunto conocido de cargas. Cada una de las cuatro mayores empresas cloud y de plataforma tiene ya su propia línea.
Google TPU: del caballo de tiro de entrenamiento al buque insignia de inferencia
Google tiene el programa de acelerador a medida más longevo. Dice que «for more than a decade, TPUs have powered Google’s most demanding AI training and serving cargas de trabajo» [3]. Ironwood es la séptima generación. La documentación de Google Cloud lista el TPU7x (Ironwood) a 4.614 TFLOPs FP8 de pico por chip, 192 GiB de HBM a 7.380 GB/s por chip, y 9.216 chips por pod — frente a 918 TFLOPs FP8 y 32 GiB de la generación anterior v6e (Trillium) [5]. Google también reivindica para Ironwood un rendimiento por vatio 2× superior a Trillium [3].
Los detalles importan. Google comercializa Ironwood como pensado para inferencia, pero su documentación describe la generación como «designed for large-scale AI training and inference», incluido «pre-training, sampling and decode-heavy inference» [5]. Google también ha trabajado la portabilidad: un soporte TPU reforzado en vLLM permite a los desarrolladores «switch between GPUs and TPUs, or run both, with only a few minor configuration changes» [13]. El dependencia del proveedor de software ha sido durante mucho tiempo la mejor defensa de la GPU; bajar el coste de cambio importa tanto como los FLOPs brutos.
AWS Trainium (y la línea Inferentia)
La línea de Amazon lleva nombre de entrenamiento, pero AWS la vende ya para ambos usos. En re:Invent 2024, AWS dijo que las instancias Trn2 «offer 30-40% better relación precio-rendimiento than the current generation of GPU-based EC2 P5e and P5en instances» [7]. También anunció Project Rainier con Anthropic [7]. Amazon declaró después Project Rainier «fully operational» con «nearly half a million Trainium2 chips», y que Claude debía correr en «more than 1 million Trainium2 chips — for cargas de trabajo including training and inference — by the end of the year» [8].
La siguiente generación, Trainium3, es el primer chip de IA en 3 nm de AWS. Amazon indica que los Trn3 UltraServers escalan hasta 144 chips y entregan «up to 362 FP8 PFLOPs». Reivindica hasta 4,4× el rendimiento de cómputo y 4× la eficiencia energética de los UltraServers Trainium2, y dice que «Amazon Bedrock is already serving production cargas de trabajo on Trainium3» [9]. El nombre dice entrenamiento; el discurso cubre claramente también la inferencia.
Microsoft Maia 200: pensado para tokens
Maia 200, anunciado el 26 de enero de 2026, es el ejemplo más claro de un chip hiperescalador pensado para inferencia. Microsoft lo describe construido en el proceso 3 nm de TSMC con núcleos tensoriales nativos FP8/FP4, «216GB HBM3e at 7 TB/s and 272MB of on-chip SRAM». Entrega «over 10 petaFLOPS in 4-bit precision (FP4) and over 5 petaFLOPS of 8-bit (FP8) performance, all within a 750W SoC TDP envelope» [6]. Microsoft reivindica un 30 % mejor rendimiento por dólar que el hardware más reciente de su flota. Maia 200 debe servir modelos como GPT-5.2 de OpenAI para Microsoft Foundry y Microsoft 365 Copilot [6].
Dos decisiones de diseño delatan el foco en inferencia. La primera: la gran SRAM on-die, que mantiene los datos cerca del cómputo cuando el decodificado está limitado por el ancho de banda de memoria. La segunda: la red. Microsoft indica que Maia 200 usa «a novel, two-tier scale-up network design built on standard Ethernet», con clústeres de hasta 6.144 aceleradores, «without relying on proprietary fabrics» [6]. Es el contraste directo con los racks GPU basados en NVLink.
Meta MTIA: cuatro generaciones orientadas al serving
El programa MTIA de Meta empezó con la inferencia de recomendación. En 2023, Meta escribió que «GPUs were not always optimal for running Meta’s specific recommendation cargas de trabajo at the levels of efficiency required at our scale» [14]. En marzo de 2026, Meta dijo haber «deployed hundreds of thousands of MTIA chips in production», desarrollados «in close asociación with Broadcom» [10]. La hoja de ruta dice dónde Meta sitúa el cuello de botella. Meta afirma que «the bandwidth of high-bandwidth memory (HBM) is the most important factor affecting GenAI inference performance». Duplicó el ancho de banda HBM de MTIA 400 a MTIA 450, con despliegue masivo previsto a principios de 2027, y añadió otro 50 % para MTIA 500, anunciado para 2027 [10]. Meta insiste también en seguir «committed to a diverse silicon portfolio»: MTIA complementa las GPU, no las sustituye [10].
Los especialistas en inferencia: Groq y Cerebras
Las startups muestran con más claridad cuánto vale ya la inferencia rápida.
Groq diseñó su arquitectura LPU para inferencia de baja latencia. El 24 de diciembre de 2025, Groq anunció «a non-exclusive licensing agreement with Nvidia for Groq’s inference technology». Como parte del acuerdo, el fundador Jonathan Ross, el presidente Sunny Madra y otros miembros del equipo se unieron a NVIDIA, mientras Groq sigue como empresa independiente y GroqCloud sigue operando [15]. NVIDIA lista ya un acelerador de inferencia «NVIDIA Groq 3 LPX» en producción plena [1]. El establecido eligió licenciar la tecnología de un especialista en lugar de reconstruirla desde cero.
Cerebras construye procesadores a escala de wafer. OpenAI anunció el 14 de enero de 2026 una asociación con Cerebras «to add 750MW of ultra low-latency AI cómputo to our platform», con capacidad que llega «in multiple tranches through 2028» [11]. OpenAI dice que la velocidad de Cerebras «comes from putting massive cómputo, memory, and bandwidth together on a single giant chip», y presenta el acuerdo como la adición de «a dedicated low-latency inference solution» a su mix [11]. La prensa (Reuters, citando al Wall Street Journal) sitúa el acuerdo en torno a 10.000 millones de dólares [16]; el anuncio de OpenAI no indica un valor [11].
GPU vs ASIC: entrenamiento vs inferencia, cara a cara
| Actor | Tipo | Rol primario hoy (según el proveedor) | Hechos públicos destacados |
|---|---|---|---|
| NVIDIA (Blackwell Ultra, Vera Rubin) | GPU mercantil | Entrenamiento e inferencia | 89.000 M$ de ingresos Data Center en T2 FY27 [1] |
| AMD Instinct (MI350X → MI450) | GPU mercantil | Entrenamiento e inferencia | Acuerdo 6 GW con OpenAI, primer GW en 2S 2026 [4] |
| Google TPU7x (Ironwood) | ASIC hiperescalador | Inferencia primero, también entrenamiento | 9.216 chips por pod; 192 GiB HBM por chip [5] |
| AWS Trainium2 / Trainium3 | ASIC hiperescalador | Entrenamiento e inferencia | Trn3 UltraServer: 144 chips, hasta 362 PFLOPs FP8 [9] |
| Microsoft Maia 200 | ASIC hiperescalador | Inferencia | 216 GB HBM3e, >10 PFLOPS FP4, 750 W [6] |
| Meta MTIA (300–500) | ASIC interno | Entrenamiento/inferencia de recomendación, inferencia GenAI | Cientos de miles desplegados [10] |
| Groq (tecnología LPU) | ASIC de inferencia | Inferencia de baja latencia | Licencia no exclusiva a NVIDIA [15] |
| Cerebras (wafer-scale) | Sistemas orientados a inferencia | Inferencia de baja latencia | Acuerdo 750 MW OpenAI hasta 2028 [11] |
Se destaca un patrón. El entrenamiento en la frontera sigue dominado por grandes clústeres estrechamente acoplados. Las GPU mercantiles lideran, con las TPU de Google y Trainium de AWS como principales alternativas propietarias. La inferencia es donde se extiende la especialización. Microsoft y Meta construyeron chips con la inferencia como objetivo principal. Google dio a Ironwood una identidad inference-first. Dos startups con discurso solo de inferencia cerraron acuerdos mayores en pocas semanas.
Dinámicas de mercado: qué decide quién gana la inferencia
En lugar de predecir un único ganador, es más útil mirar las palancas que los propios proveedores subrayan.
1. Ancho de banda de memoria por encima de los FLOPs de pico. Meta lo dice abiertamente para la inferencia GenAI [10]. El diseño Maia de Microsoft combina gran SRAM on-die con HBM3e [6]. El discurso de Cerebras se apoya en poner memoria y cómputo en un mismo wafer [11]. Generar tokens uno a uno suele estar limitado por la velocidad a la que se mueven pesos y caché KV: los chips se diseñan ya en torno al movimiento de datos.
2. Rendimiento por dólar y por vatio. Casi cada anuncio de silicio a medida abre con economía más que con velocidad bruta. Ejemplos: la ganancia reivindicada del 30 % de rendimiento por dólar de Microsoft [6], el 30–40 % mejor precio-rendimiento de Trn2 frente a instancias GPU en AWS [7], y el 2× rendimiento por vatio de Ironwood frente a Trillium en Google [3]. Son claims de proveedor, no benchmarks independientes. Aun así, muestran lo que piden los compradores.
3. La potencia como unidad de compra. Los acuerdos se dimensionan ya en gigavatios y megavatios más que en número de chips: 10 GW para NVIDIA–OpenAI [12], 6 GW para AMD–OpenAI [4], 750 MW para Cerebras–OpenAI [11], y 1 GW para el compromiso NVIDIA inicial de Anthropic [12]. Cuando la potencia disponible es la restricción vinculante, la eficiencia por vatio decide directamente cuánta capacidad puede servir de verdad un comprador.
4. Portabilidad de software. El foso de CUDA es real, pero el campo ASIC lo ataca. Google impulsa el soporte vLLM en GPU y TPU [13]. Microsoft entrega un SDK Maia con integración PyTorch y compilador Triton para «easy model porting across heterogeneous hardware accelerators» [6]. Meta integra MTIA directamente en PyTorch [14]. Cuanto más fácil sea mover un modelo, menos cuesta elegir un ASIC.
5. Red de scale-up. Los grandes modelos se sirven ya a través de racks, no de un solo chip. NVIDIA vende plataformas rack integradas como Vera Rubin [1]. Microsoft apuesta por el scale-up Ethernet [6]. Google se apoya en su Inter-Chip Interconnect a través de pods de 9.216 chips [3]. El MTIA 400 de Meta presenta «a 72-accelerator scale-up domain» [10]. La interconexión forma cada vez más parte del producto.
Entonces, ¿quién gana la inferencia?
Con las pruebas disponibles hoy, la respuesta honesta es que la inferencia se está convirtiendo en un mercado de cartera más que en uno de ganador único. NVIDIA sigue siendo con mucho el mayor proveedor por ingresos [1], y ha absorbido tecnología especialista mediante la licencia Groq [1][15]. Los hiperescaladores mueven una parte creciente de su serving a silicio propio, sobre todo donde controlan modelo y plataforma: Microsoft con Copilot y Foundry [6], Meta con recomendaciones y GenAI [10], Google en sus servicios y Cloud [3], y AWS con Bedrock [9]. Los laboratorios de frontera se cubren con todos. OpenAI sola tiene acuerdos públicos con NVIDIA, AMD y Cerebras [12][4][11], y Anthropic corre tanto en Trainium como en NVIDIA [8][12].
Para quien sigue los aceleradores de IA, la lección práctica es vigilar las economías por token y por vatio que publica cada proveedor. Leerlas como claims, compararlas con benchmarks independientes cuando aparezcan, y seguir dónde colocan los grandes laboratorios su próximo gigavatio. Ahí es donde se decidirá el duelo GPU vs ASIC.
Lecturas relacionadas
- Entrenamiento multi-billones de parámetros: lo que debe entregar la próxima generación de silicio
- Carrera de capex: mapear el gasto en IA de los hiperescaladores y qué compra
- InfiniBand vs Ethernet para clústeres de IA: la guerra de fabrics dentro de la fábrica de IA
Referencias / Fuentes
- NVIDIA — «NVIDIA Announces Financial Results for Second Quarter Fiscal 2027» (Aug 26, 2026). https://investor.nvidia.com/news/press-release-details/2026/NVIDIA-Announces-Financial-Results-for-Second-Quarter-Fiscal-2027/default.aspx
- NVIDIA — CFO Commentary, Q2 FY27 (SEC filing). https://www.sec.gov/Archives/edgar/data/1045810/000104581026000073/q2fy27cfocommentary.htm
- Google — «Ironwood: The first Google TPU for the age of inference.» https://blog.google/innovation-and-ai/infrastructure-and-cloud/google-cloud/ironwood-tpu-age-of-inference/
- AMD — «AMD and OpenAI Announce Strategic Partnership to Deploy 6 Gigawatts of AMD GPUs» (Oct 6, 2025). https://ir.amd.com/news-events/press-releases/detail/1260/amd-and-openai-announce-strategic-partnership-to-deploy-6-gigawatts-of-amd-gpus
- Google Cloud Documentation — «TPU7x (Ironwood).» https://docs.cloud.google.com/tpu/docs/tpu7x
- Microsoft — «Maia 200: The AI accelerator built for inference» (Jan 26, 2026). https://blogs.microsoft.com/blog/2026/01/26/maia-200-the-ai-accelerator-built-for-inference/
- Amazon — «AWS Trainium2 Instances Now Generally Available» (Dec 2024). https://press.aboutamazon.com/2024/12/aws-trainium2-instances-now-generally-available
- Amazon — «AWS’s Project Rainier.» https://www.aboutamazon.com/news/aws/aws-project-rainier-ai-trainium-chips-compute-cluster
- Amazon — «Trainium3 UltraServers now available.» https://www.aboutamazon.com/news/aws/trainium-3-ultraserver-faster-ai-training-lower-cost
- Meta — «Four MTIA Chips in Two Years: Scaling AI Experiences for Billions» (Mar 11, 2026). https://ai.meta.com/blog/meta-mtia-scale-ai-chips-for-billions/
- OpenAI — «OpenAI partners with Cerebras» (Jan 14, 2026). https://openai.com/index/cerebras-partnership/
- NVIDIA — «NVIDIA Announces Financial Results for Third Quarter Fiscal 2026» (Nov 19, 2025). https://investor.nvidia.com/news/press-release-details/2025/NVIDIA-Announces-Financial-Results-for-Third-Quarter-Fiscal-2026/default.aspx
- Google Cloud Blog — «Ironwood TPUs and new Axion-based VMs for your AI workloads.» https://cloud.google.com/blog/products/compute/ironwood-tpus-and-new-axion-based-vms-for-your-ai-workloads
- Meta — «MTIA v1: Meta’s first-generation AI inference accelerator» (May 18, 2023). https://ai.meta.com/blog/meta-training-inference-accelerator-AI-MTIA/
- Groq — «Groq and Nvidia Enter Non-Exclusive Inference Technology Licensing Agreement» (Dec 24, 2025). https://groq.com/newsroom/groq-and-nvidia-enter-non-exclusive-inference-technology-licensing-agreement-to-accelerate-ai-inference-at-global-scale
- Reuters — «OpenAI signs $10 billion computing deal with Nvidia challenger Cerebras» (Jan 14, 2026). https://www.reuters.com/technology/openai-buy-compute-capacity-startup-cerebras-around-10-billion-wsj-reports-2026-01-14/
Imágenes: ilustraciones generadas para AndBeyond.Tech, salvo: Acelerador NVIDIA H100 — 极客湾Geekerwan, Wikimedia Commons, CC BY 3.0; Placa Google Tensor Processing Unit 3.0 — Zinskauf, Wikimedia Commons, CC BY-SA 4.0.