Quand les modèles vidéo deviennent ouverts : Praxis-1 de Runway et la vidéo du web comme pré-entraînement des robots
Les modèles vision-langage-action des robots ont surtout été entraînés sur des démonstrations collectées avec des robots : téléopération, outils tenus à la main, ou simulation. Les…
Les modèles vision-langage-action des robots ont surtout été entraînés sur des démonstrations collectées avec des robots : téléopération, outils tenus à la main, ou simulation. Les entreprises de la vidéo soutiennent depuis longtemps que l’internet public contient déjà un registre plus riche de la façon dont les objets se déplacent et dont les tâches se déroulent. Le 11 novembre 2026, Runway a versé au domaine ouvert une mise à l’épreuve de cette idée. Praxis-1, le « modèle d’action-monde » (world action model) de l’entreprise, est désormais disponible avec des poids ouverts, et Runway licencie les poids ainsi que le code d’inférence et d’affinage sous Apache 2.0, y compris pour un usage commercial [1][2][3].
Le présent article décrit ce qui a réellement été publié, attribue chaque score mis en avant à Runway et aux bancs d’essai qu’elle cite, et traite l’affirmation selon laquelle la vidéo du web peut tenir lieu de vidéo de robots téléopérés comme une question ouverte — et non comme un résultat acquis.
Ce qu’est Praxis-1
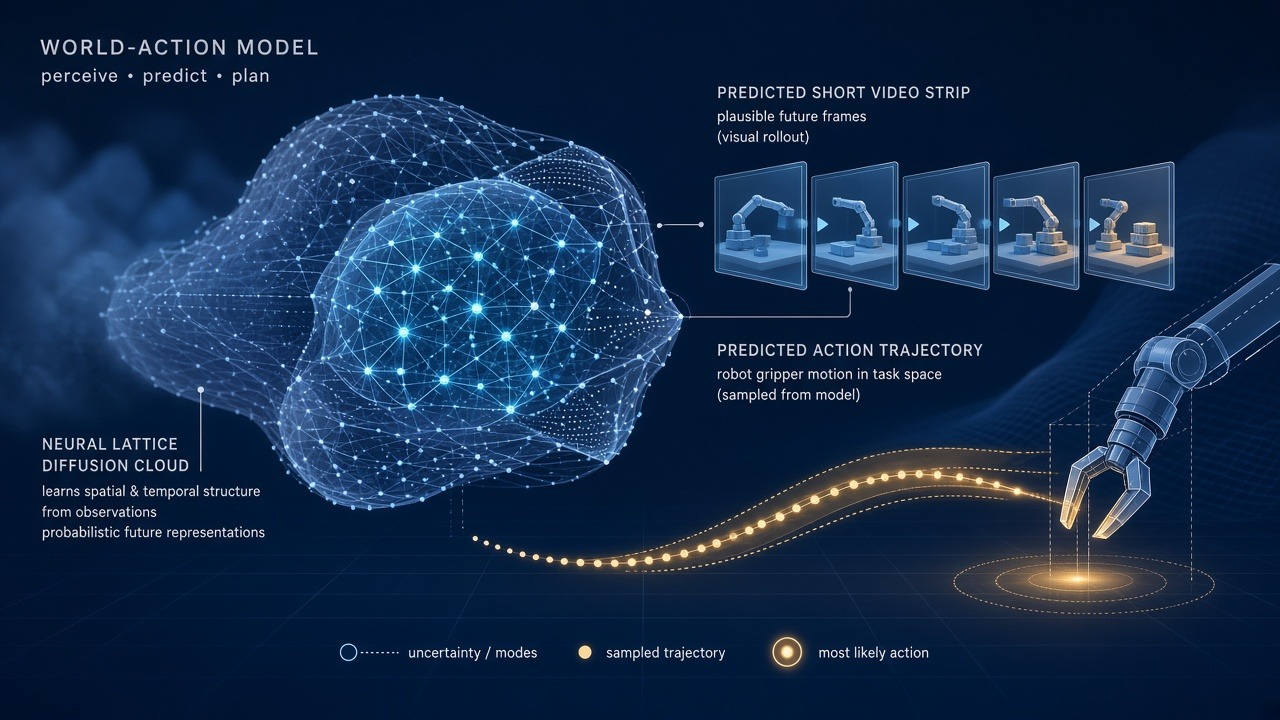
Runway a d’abord présenté Praxis-1 en septembre 2026 comme son premier modèle d’action-monde, bâti sur le même pré-entraînement vidéo à grande échelle que ses modèles de monde généraux [1]. Dans la publication de novembre, elle décrit le modèle comme un transformeur de diffusion en mélange d’experts de 27 milliards de paramètres, qui prédit conjointement la vidéo et les actions [1]. La fiche Hugging Face du point de contrôle de base est un peu plus précise : une politique de diffusion vidéo en mélange d’experts de 27,2 milliards de paramètres, avec un tronc à causalité par blocs et un expert d’action de 0,3 milliard de paramètres, fonctionnant à 15 Hz par paquets d’actions de 24 pas [3]. Cette fiche précise aussi que le point de contrôle de base n’a pas de têtes d’action propres à chaque incarnation et « ne s’exécute pas tel quel comme une politique » ; c’est le point de départ d’un affinage sur un nouveau montage robotique [3].
L’idée pratique est simple à énoncer et difficile à tenir. À partir d’observations de caméras, de l’état du robot et d’une consigne en langage, le modèle prédit une courte vidéo de ce qui se produit ensuite et les actions qui la produiraient. Le robot exécute alors le paquet d’actions [2]. Runway appelle cela un modèle d’action-monde plutôt qu’un VLA classique, parce que la prédiction vidéo fait partie de la politique, et non d’un modèle de monde distinct placé à ses côtés.
Des points de contrôle prêts à l’emploi couvrent plusieurs montages courants : une configuration DROID à un bras, une configuration YAM bimanuelle, et des bras SO-100 / SO-101, y compris des variantes quantifiées NVFP4 et des dispositions compatibles LeRobot [2][3]. Runway mentionne aussi une disponibilité dans vLLM-Omni, une inférence hébergée sur son service Reactor, et des tutoriels de post-entraînement avec NVIDIA NeMo Automodel [1]. Elle indique que le modèle s’exécute sur des GPU de data center NVIDIA (H100, B200), des GPU de station de travail (RTX 5090, RTX PRO 6000) et sur le Jetson Thor, à bord du robot lui-même [1].
Les partenaires de lancement nommés dans l’annonce — Noble Machines, Standard Bots et Ultra — ont, selon Runway, déjà fait tourner le modèle sur un humanoïde à jambes, un bras industriel à six axes et un robot d’entrepôt à deux bras [1]. Ces déploiements relèvent du récit de Runway sur l’usage de ses partenaires ; le présent article ne vérifie pas de façon indépendante leurs performances en atelier. Pour un résultat d’usine comparable, rapporté par un fournisseur, sur des humanoïdes, voir notre analyse de Gemini Robotics 2.5 à l’usine.
La licence, vérifiée sur le dépôt réel
L’annonce de Runway indique que tout ce qu’il faut pour faire tourner et adapter Praxis-1 est publié sous Apache 2.0, y compris pour un usage commercial, couvrant les poids ainsi que le code d’inférence et d’affinage, avec un soutien à la fois à l’affinage complet et au LoRA [1].
Nous avons examiné les dépôts principaux plutôt que de nous en tenir au seul billet :
- Le dépôt de code officiel, github.com/runwayml/praxis-1-oss, est enregistré sur GitHub sous Apache License 2.0 (
spdx_id: Apache-2.0). Le fichierLICENSEde la branchemainest le texte standard de la licence Apache, version 2.0, janvier 2004 [2]. - Les fiches de modèle Hugging Face de
runwayml/praxis-1-base,runwayml/praxis-1-droid,runwayml/praxis-1-yametrunwayml/praxis-1-so101indiquent toutes apache-2.0 [3].
Une réserve est inscrite sur la fiche du modèle de base et mérite d’être retenue : les dépendances figées, conditionnées séparément — l’autoencodeur variationnel Wan2.2 et l’encodeur de texte Qwen/Qwen3.5-2B — « sont distribuées séparément sous leurs propres licences » [3]. Apache 2.0 s’applique aux poids Praxis de Runway et au code de praxis-1-oss ; elle ne couvre pas automatiquement ces composants d’amont.
Les scores, avec leur source et leurs conditions
Tous les chiffres qui suivent sont ceux de Runway, rapportés dans son annonce du 11 novembre 2026, et proviennent de bancs d’essai que Runway elle-même cite. Ce ne sont pas des réplications indépendantes [1].
NVIDIA RoboLab-120, décrit par Runway comme un classement de modèles d’action-monde, le succès étant mesuré sur 1 200 épisodes et les chiffres « à la date de novembre 2026 » [1] :
| Modèle (tel que listé par Runway) | Succès RoboLab-120 |
|---|---|
| Praxis-1 | 46,2 % |
| FLUX 3 Action | 42,9 % |
| Cosmos3 Nano | 36,8 % |
| π0.5 | 28,0 % |
Runway indique que Praxis-1 est le modèle d’action-monde le plus performant de ce classement et qu’il surpasse tous les VLA à poids ouverts du même tableau [1]. Ces rangs doivent se lire comme la lecture par Runway de RoboLab-120 à cette date, selon le protocole officiel qu’emploie le banc d’essai — et non comme un classement général de toutes les politiques robotiques dans tous les contextes. Pour une idée de la fragilité des classements robotiques à un seul chiffre lorsque les incarnations et les tâches changent, voir notre examen antérieur de RoboColosseum.
SimplerEnv, après affinage sur le robot RT-1 de Google. Runway indique que l’incarnation RT-1 « n’est jamais apparue dans ses données d’entraînement », et qu’un Praxis-1 affiné atteint 80,0 % de succès sur SimplerEnv, contre 52,4 % pour la politique RT-1 d’origine [1]. Là encore, ce sont les chiffres rapportés par Runway sur cette suite d’évaluation simulée, après un affinage, et non un score de robot réel en zéro-shot, ni un audit d’un tiers.
Aucun de ces résultats, à lui seul, ne dit comment un point de contrôle se comportera sur une nouvelle cellule industrielle. Ils sont utiles comme toise propre à l’entreprise, clairement étiquetée.
La vidéo du web peut-elle remplacer la téléopération ? Une question ouverte
L’affirmation la plus intéressante se situe un cran en dessous du classement. Runway écrit que Praxis-1 « apprend le comportement des objets et le déroulement des tâches à partir de vidéo à grande échelle », ce qui lui donne « une longueur d’avance sur une nouvelle incarnation avant tout affinage sur un matériel ou des données propres à un domaine ». Elle indique ensuite que ses recherches « ont montré que la vidéo du web égale la vidéo de robots téléopérés comme données de pré-entraînement pour la performance d’une politique, ce qui déplace le goulot d’une politique capable vers la quantité de vidéo générale qu’un modèle peut apprendre » [1].
C’est une affirmation forte. C’est aussi, pour l’heure, une thèse à examiner, et non un résultat que le domaine a tranché.
Quelques raisons de la laisser ouverte :
- Le point de contrôle de base ouvert n’est pas « vidéo du web seulement ». La fiche Hugging Face de
praxis-1-basedécrit le point de contrôle de mi-entraînement comme « entraîné sur un mélange de vidéo de robots et de vidéo humaine, sur 18 incarnations » [3]. Si de la vidéo de robots reste dans le mélange, « la vidéo du web égale la téléopération » est un résultat de recherche que Runway attribue à ses propres études — et non la description d’une politique pré-entraînée uniquement sur l’internet, que quiconque pourrait télécharger et faire tourner. - Les scores publiés ne constituent pas un test d’échange contrôlé. RoboLab-120 et le chiffre SimplerEnv sur RT-1 comparent Praxis-1 à d’autres modèles, ou à la politique RT-1 d’origine après affinage. Ils ne montrent pas, dans l’annonce, une ablation tête-à-tête dans laquelle la même architecture serait pré-entraînée uniquement sur de la vidéo du web, ou uniquement sur de la téléopération, puis évaluée selon des protocoles identiques sur robot réel [1].
- L’adaptation reste dans la boucle. Le récit même de Runway sur les robots partenaires et sur le résultat RT-1 est celui d’un modèle pré-entraîné plus un affinage léger ou un LoRA sur le matériel cible [1]. Le pré-entraînement peut réduire la quantité de données robotiques dont on a besoin. Ce n’est pas la même chose que de retirer les données robotiques du pipeline.
- Le contact physique reste la partie difficile. Comme nous l’avons défendu dans nos articles sur le transfert sim-to-real et sur l’apprentissage par renforcement résiduel et en conditions réelles, la vidéo d’internet est riche en sémantique et pauvre en force, en jeu mécanique et en comportements de rattrapage qui font échouer l’insertion, le pliage et l’usage d’outils sur un bras réel. Un modèle peut « savoir » ce qu’est une tasse et malgré tout manquer le dernier centimètre.
Rien de tout cela ne rend l’hypothèse inintéressante. Si le pré-entraînement vidéo à grande échelle égale vraiment le pré-entraînement par téléopération pour la performance aval d’une politique, la stratégie de collecte de données pour les modèles de fondation des robots changerait : moins de téléopération de routine en amont, et un temps robot plus rare consacré à l’affinage, à l’évaluation et à la longue traîne. La position honnête, en novembre 2026, est que Runway a ouvert un modèle solide et formulé une affirmation testable. Des laboratoires indépendants peuvent désormais chercher à reproduire cette équivalence — ou montrer où elle se brise.
Pourquoi l’ouverture des poids compte
Les modèles de robotique fermés sont difficiles à inspecter, à adapter ou à faire tourner sous les règles de sécurité propres à une usine. Des poids et un code d’entraînement sous Apache 2.0 abaissent cette barrière, ce qui explique que Runway présente la publication comme un pari sur « l’interopérabilité et l’ouverture » de l’IA physique et rappelle son rôle de membre fondateur de la Cosmos Coalition de NVIDIA [1]. Pour les équipes industrielles, le test utile est plus étroit : peut-on prendre praxis-1-base, ajouter des têtes pour ses caméras et son espace d’action, l’adapter par LoRA sur un jeu de démonstrations modeste, et obtenir une politique suffisamment sûre et fiable pour l’évaluer sur une cellule réelle ?
La publication rend cette expérience moins coûteuse à mener. Elle ne l’achève pas. Les équipes auront toujours besoin d’une discipline sim-to-real, d’une évaluation soigneuse sur le robot, et, pour beaucoup de compétences riches en contact, d’une boucle d’amélioration après l’imitation [4]. Les poids ouverts sont une infrastructure, non un substitut à cette pile.
Des limites à garder en vue
- Les chiffres de banc d’essai de cet article sont ceux de Runway, issus de RoboLab-120 (1 200 épisodes, instantané de novembre 2026) et de SimplerEnv après un affinage RT-1 [1].
- Les mentions de matériel partenaire sont celles de Runway ; nous n’avons pas audité ces déploiements.
- Apache 2.0 est confirmée pour le dépôt GitHub officiel et les points de contrôle Praxis-1 listés sur Hugging Face ; les encodeurs et VAE distribués séparément conservent leurs propres licences [2][3].
- « La vidéo du web égale la téléopération » demeure l’affirmation de recherche de Runway, et le modèle de base public est documenté comme un mélange de vidéo de robots et de vidéo humaine [1][3].
En résumé
Praxis-1 est une véritable ouverture d’une grande politique vidéo-et-action : un modèle en mélange d’experts de 27 milliards de paramètres, un code et des poids sous Apache 2.0, et un chemin d’affinage public. Runway fait état de 46,2 % de succès sur RoboLab-120 et de 80,0 % contre 52,4 % sur SimplerEnv après un affinage RT-1 ; ces chiffres appartiennent à Runway et aux bancs d’essai qu’elle cite. L’idée plus profonde — que la vidéo du web peut remplacer la téléopération comme pré-entraînement — est désormais plus facile à tester, parce que les poids sont sortis. Ce n’est pas, sur les preuves publiées avec cette mise à disposition, une affaire classée.
À lire aussi
- Modèles vision-langage-action : la nouvelle couche de base des robots
- Sim-to-real en 2026 : combler l’écart sans données réelles à l’infini
- Après l’imitation : l’apprentissage par renforcement résiduel et en conditions réelles, nouvelle couche des politiques robotiques
- RoboColosseum et la course à la mesure de l’intelligence physique en conditions réelles
- Gemini Robotics 2.5 à l’usine
Références / Sources
- Runway — « Praxis-1 Is Now Available » (11 novembre 2026). https://runway.com/news/company-news/praxis-1-is-now-available
- Runway — official code repository
runwayml/praxis-1-oss, Apache License 2.0 (fichier LICENSE surmain; SPDX GitHub Apache-2.0). https://github.com/runwayml/praxis-1-oss - Runway — Hugging Face model card,
runwayml/praxis-1-base(Apache 2.0 ; notes des licences distinctes pour le VAE Wan2.2 et Qwen3.5-2B). Points de contrôle associés :praxis-1-droid,praxis-1-yam,praxis-1-so101. https://huggingface.co/runwayml/praxis-1-base · https://huggingface.co/collections/runwayml/praxis-1 - Lectures associées : AndBeyond.Tech — Modèles vision-langage-action : la nouvelle couche de base des robots ; Sim-to-real en 2026 ; Après l’imitation : l’apprentissage par renforcement résiduel et en conditions réelles ; RoboColosseum et la course à la mesure de l’intelligence physique ; Gemini Robotics 2.5 à l’usine.
Images : illustrations originales créées pour AndBeyond.Tech ; aucun logo ni aucune personne réelle n’y figurent.