Gemini Robotics 2.5 à l’usine : ce que le score de 96 % de DeepMind au kitting prouve — et ne prouve pas
Le 10 novembre 2026, Google DeepMind a présenté Gemini Robotics 2.5, qu’elle qualifie de son modèle vision-langage-action le plus capable à ce jour, et a…
Le 10 novembre 2026, Google DeepMind a présenté Gemini Robotics 2.5, qu’elle qualifie de son modèle vision-langage-action le plus capable à ce jour, et a placé un chiffre d’usine au centre de l’affirmation de fiabilité. Lors d’une « preuve de concept en conditions réelles », DeepMind indique que le modèle a aidé l’humanoïde Apollo 2 d’Apptronik à « prélever et emballer des pièces automobiles avec un taux de réussite de 96 % » (Google DeepMind, 10 nov. 2026).
Ce chiffre de 96 % est un résultat rapporté par DeepMind. Il n’est accompagné, dans le même billet, ni d’un nombre d’essais, ni d’une définition du « succès », ni d’un temps de cycle, ni d’une durée de poste, ni d’un taux d’intervention. DeepMind elle-même décrit le travail comme une preuve de concept, et non comme un déploiement commercial achevé. Le présent article s’en tient à la question d’usine : ce que l’annonce dit réellement du kitting humanoïde en usine, ce qu’elle laisse ouvert, et jusqu’où un seul pourcentage peut aller pour prouver qu’un modèle d’IA pour robot humanoïde est prêt à tenir un poste sur une ligne en activité.
Ce que DeepMind dit s’être passé sur la ligne
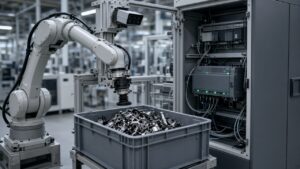
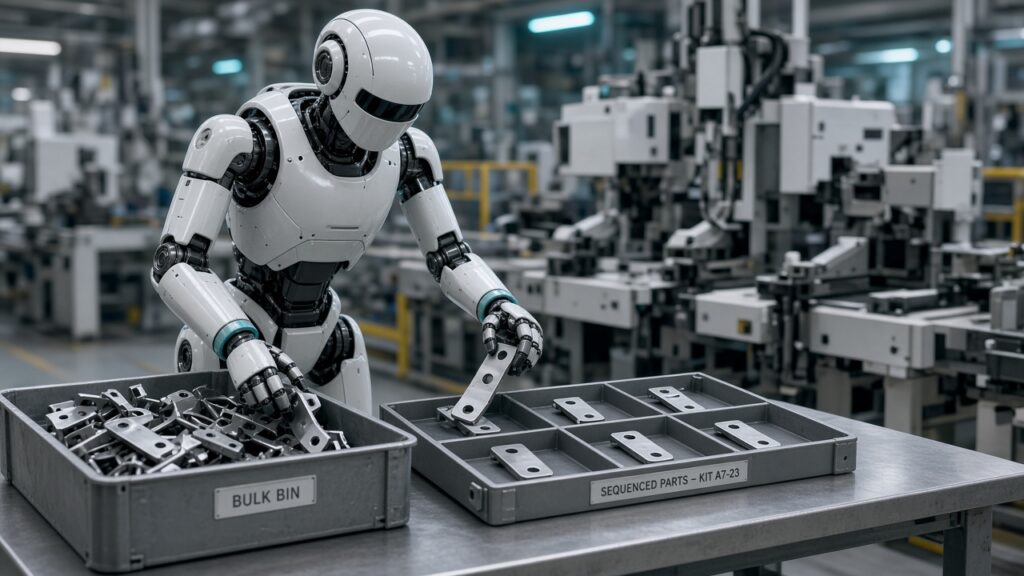
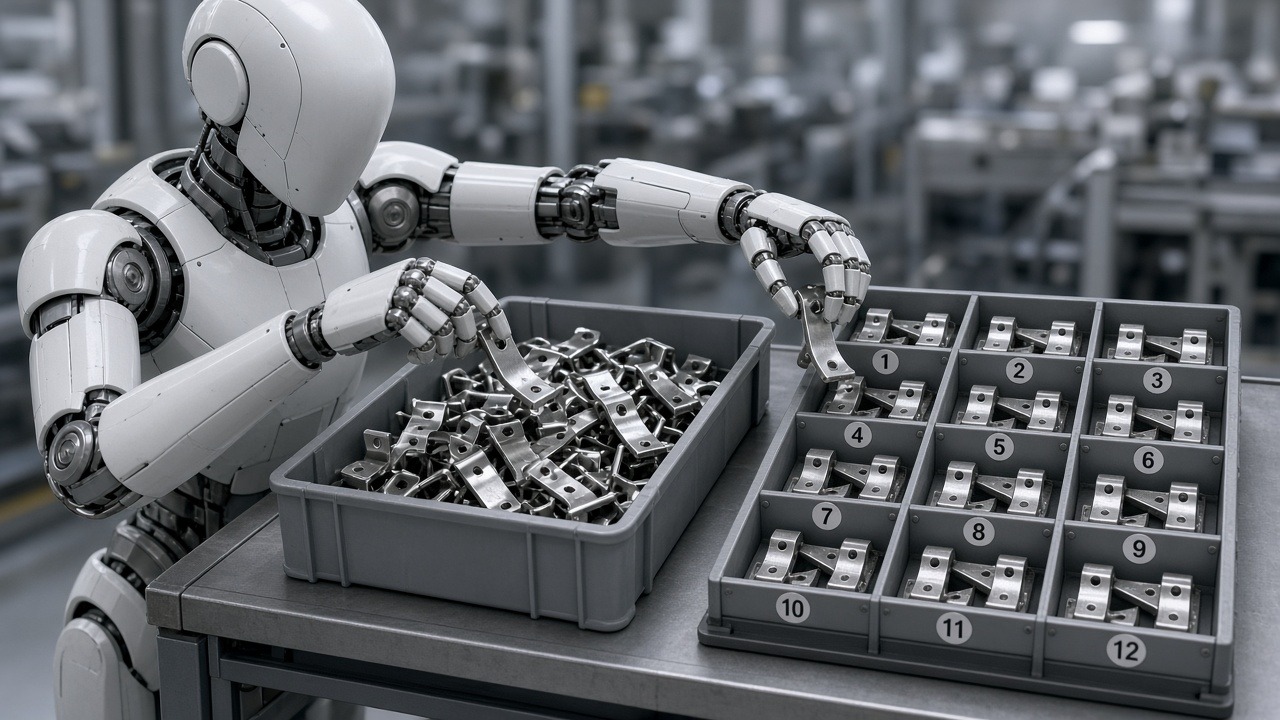
Dans une section intitulée « Tester la fiabilité en conditions réelles avec l’Apollo d’Apptronik et Mercedes-Benz », DeepMind écrit avoir « travaillé avec Apptronik et Mercedes-Benz pour utiliser des robots humanoïdes Apollo 2 sur des lignes de production automobile en activité à Kecskemét, en Hongrie, et à Sindelfingen, en Allemagne ». La tâche, telle que DeepMind la décrit, est le kitting automobile : trier des pièces individuelles depuis des bacs en vrac vers des plateaux organisés « dans l’ordre exact requis pour chaque véhicule sur la ligne ». Le robot, selon DeepMind, plonge dans les bacs d’approvisionnement, saisit des équerres métalliques automobiles et les place dans des contenants de séquençage, « en corrigeant d’éventuels manques », et atteint un taux de réussite de 96 % (Google DeepMind, 10 nov. 2026).
Ces noms d’usines et l’identification de Mercedes-Benz proviennent de la formulation de DeepMind. Au 16 novembre 2026, AndBeyond.Tech n’a pas trouvé de communiqué autonome de Mercedes-Benz, ni de communiqué autonome du service de presse d’Apptronik, qui reprendrait le chiffre de 96 % ou confirmerait indépendamment les précisions sur Kecskemét et Sindelfingen. Une citation de Jeff Cardenas, directeur général et cofondateur d’Apptronik, apparaît bien dans le billet de DeepMind. Il indique que les entreprises « ont vu les modèles s’améliorer de façon spectaculaire en seulement quelques semaines de post-entraînement, et se transposer à la production Mercedes-Benz avec une très faible dégradation » (Google DeepMind, 10 nov. 2026). C’est le directeur général d’Apptronik, publié par DeepMind, et non un communiqué distinct d’Apptronik ou de Mercedes-Benz.
L’accord commercial de 2024 par lequel Apptronik et Mercedes-Benz ont indiqué qu’elles piloteraient Apollo dans des usines Mercedes-Benz, y compris pour la livraison de kits vers la ligne, est un fait public établi par Apptronik (Apptronik, 15 mars 2024). Il établit qu’un partenariat existait. Il ne vérifie pas, à lui seul, le taux de réussite 2026 avancé par DeepMind.
Tant que Mercedes-Benz ou Apptronik n’aura pas publié son propre récit de cette preuve de concept, la lecture responsable est la suivante : DeepMind fait état d’un résultat de kitting de 96 % sur Apollo 2, dans des usines qu’elle nomme comme des sites Mercedes-Benz en Hongrie et en Allemagne.
Pourquoi le kitting est un test d’usine révélateur
Le kitting — parfois appelé séquençage lorsque les pièces doivent arriver dans l’ordre des véhicules — n’est pas une démonstration de dextérité choisie au hasard. Un emplacement manqué, interverti ou vide dans un plateau peut arrêter une ligne ou obliger une personne à rattraper l’erreur avant que le kit n’arrive au montage. Le cadrage de DeepMind elle-même est que le report de ce « travail préparatoire monotone aide à faire avancer la chaîne de montage, tout en libérant les techniciens pour des tâches de construction complexes » (Google DeepMind, 10 nov. 2026).
C’est précisément pourquoi le dénominateur manquant compte. Un taux de réussite de 96 % sonne précis. Sans savoir si DeepMind a compté des saisies individuelles, des plateaux achevés ou une autre unité, et sans savoir combien de tentatives se cachent derrière le pourcentage, un ingénieur d’usine ne peut dire si 96 % est un rendement sur un large échantillon ou un score sur un petit. Le billet ne dit pas non plus comment un échec a été traité : le robot a-t-il réessayé, a-t-il signalé le manque, ou une personne est-elle intervenue ? DeepMind affirme que le robot corrige les manques ; elle ne publie ni la fréquence de cette correction, ni le temps qu’elle a pris.
Rien de tout cela ne rend le 96 % dénué de sens. Une preuve de concept qui place un bipède sur une ligne en activité et renvoie un taux de réussite élevé, fût-il insuffisamment spécifié, reste plus instructive qu’une démonstration de laboratoire. Ce n’est pas encore le même standard de preuve qu’un relevé de poste sur plusieurs mois, à l’échelle d’une station. Pour ce test plus large de la démonstration face au poste, voir Les humanoïdes à l’usine.
Ce que l’annonce ne publie pas
Les lecteurs qui veulent juger le kitting humanoïde en usine comme un métier d’exploitation remarqueront ce qui manque dans le billet de DeepMind :
- Le nombre d’essais et la durée. Aucun chiffre n’indique combien de kits, combien d’heures ou combien de postes couvre le 96 %, ni aucune ventilation entre les deux usines nommées par DeepMind.
- La définition du succès. Il n’est pas précisé si un « succès » est une pièce correctement placée, un plateau correctement achevé, ou un épisode de tâche sous une limite de temps.
- Le taux d’intervention. Le texte ne dit pas à quelle fréquence un technicien a interrompu, réinitialisé ou secouru le robot.
- Le temps de cycle et le débit. Il n’y a ni comparaison avec le takt de la station, ni chiffre de pièces par heure.
- Les bornes de l’autonomie. « Effectue de manière autonome le kitting automobile » est la formule de DeepMind ; le billet ne décrit ni la supervision, ni la dépendance au réseau, ni ce qui se produit lorsqu’apparaît une équerre inédite ou un bac bloqué.
- Le coût. Aucun coût horaire, tarif de location ni comparaison avec un opérateur humain de kitting n’est proposé.
DeepMind qualifie le résultat de « progrès prometteur vers des applications industrielles étendues en conditions réelles ». C’est une description juste d’une preuve de concept. Ce n’est pas une affirmation, et il ne faut pas la réécrire comme telle, selon laquelle Apollo 2 tiendrait désormais un poste de production complet dans ces usines.
Comment le modèle est décrit — seulement autant que l’usine en a besoin
Gemini Robotics 2.5 est présenté comme un modèle vision-langage-action (VLA) : il prend en entrée ce que le robot voit et une consigne de tâche, et il produit des actions. Sur la cellule de kitting, DeepMind indique que deux pièces ont travaillé ensemble : Gemini Robotics ER, un modèle de « raisonnement incarné » (embodied reasoning), « pour suivre le flux de travail », et Gemini Robotics 2.5 « pour commander ses mains et ses bras » (Google DeepMind, 10 nov. 2026). Pour un lecteur d’usine, le point pertinent est cette répartition — un modèle qui surveille la séquence du travail, un autre qui meut les mains — et non l’architecture de recherche qui la sous-tend.
DeepMind indique aussi que le modèle « fonctionne nativement avec de nombreux types de robots différents », et nomme l’Apollo 2 d’Apptronik (équipé d’une main à cinq doigts qu’elle décrit comme ayant 22 degrés de liberté) ainsi qu’une plateforme Franka à deux bras munie de pinces à deux doigts. Gemini Robotics 2.5 est « en cours de déploiement auprès de nos partenaires en robotique ». Le billet ne donne ni date de disponibilité générale, ni prix, ni liste indiquant quels partenaires reçoivent quelles capacités (Google DeepMind, 10 nov. 2026).
Par ailleurs, DeepMind fait état d’évaluations de type laboratoire « sur plus de 200 tâches distinctes », avec un taux de réussite supérieur de 30 % à 100 % à celui des « baselines précédentes », selon le type de tâche, et des tâches achevées 20 % à 30 % plus rapidement. Ces chiffres sont aussi ceux de DeepMind. Ils ne doivent pas être confondus avec le 96 % d’usine. Le jeu de 200 tâches, tel qu’il est décrit, comprend des exemples comme servir des aliments avec des pinces, nouer un nœud et pipeter un liquide — utiles pour parler de dextérité, mais qui ne remplacent pas des données de kitting à l’échelle d’une station.
Les affirmations de sûreté, et ce qu’elles ne couvrent pas
DeepMind joint une section sûreté au même lancement. Elle indique que Gemini Robotics 2.5 recourt à un « guidage par raisonnement au moment de l’inférence pour contourner en temps réel les dangers physiques », et que, dans ses évaluations, cela « a fait progresser l’achèvement sûr des tâches de 33 % autour d’obstacles et de 43 % autour de personnes à proximité ». Elle présente aussi ASIMOV-Jailbreak, un banc d’essai en open source de prompts adverses, et rapporte que Gemini 4 Argon a atteint 99,5 % de « résistance aux jailbreaks », contre une baseline précédente de 82 % pour Gemini Robotics ER 2 (Google DeepMind, 10 nov. 2026).
Ce sont des résultats d’évaluation de DeepMind, et non des mesures publiées issues de la preuve de concept de kitting. Ils importent pour tout robot qui se tiendra près de personnes sur un atelier, mais ils ne disent pas à un ingénieur sûreté si les cellules de Kecskemét ou de Sindelfingen ont fonctionné derrière une clôture, selon quelles règles d’arrêt, ni au regard de quelle norme. Une usine a toujours besoin de son propre dossier de sûreté. Le chiffre de 96 % est une affirmation de réussite de tâche ; ce n’est pas une certification de sûreté.
La place de cette annonce parmi d’autres nouvelles d’humanoïdes industriels
Apptronik est aussi le fournisseur de la lettre d’intention de GXO Logistics du 12 novembre, portant sur des essais élargis en entrepôt et une trajectoire conditionnelle vers un maximum de 1 000 robots Apollo — une histoire d’intention commerciale, et non un rendement d’usine publié, traitée dans Jusqu’à 1 000 Apollo, si les essais se confirment. Les deux annonces sont tombées la même semaine et ne doivent pas être fusionnées. L’une est un score de kitting rapporté par DeepMind sur des lignes automobiles que DeepMind nomme ; l’autre est une lettre d’intention logistique dont le plafond d’unités est explicitement conditionné aux indicateurs de 2027.
La comparaison utile porte sur les preuves. La lettre d’intention de GXO demande si Apollo peut franchir des seuils d’entrepôt qui n’ont pas encore été mis à l’épreuve. Le billet de DeepMind demande aux lecteurs de tenir un score de preuve de concept de 96 % pour un « progrès prometteur » sur une ligne en activité. Les deux peuvent être vrais en même temps. Ni l’un ni l’autre, sur les documents publiés cette semaine, ne montre un humanoïde tenant un poste de production complet, décrit de façon indépendante, avec un taux d’intervention public.
Ce qui ferait du 96 % un chiffre de production
Un public d’usine n’a pas besoin d’un article de recherche. Il a besoin d’un court addendum que DeepMind, Apptronik ou le constructeur automobile pourraient encore publier :
- L’unité et l’échantillon. Qu’est-ce qui compte comme un succès, et combien de tentatives (ou de plateaux, ou d’heures) ont produit le 96 % — idéalement ventilé par usine.
- Les interventions. À quelle fréquence une personne a-t-elle touché à la cellule, et ces événements ont-ils été exclus du score.
- Le temps. Le temps de cycle au regard de l’exigence de la station, et si le résultat tient sur un poste complet, et non sur un segment enregistré.
- Les modes de défaillance. Mauvaise pièce, chute, erreur de séquence, saisie irrécupérable — et qui paie une erreur qui parvient jusqu’à la ligne.
- La déclaration propre du constructeur. Un communiqué de Mercedes-Benz ou d’Apptronik qui reprendrait, qualifierait ou corrigerait le récit de DeepMind ferait sortir le 96 % du « rapport d’une seule partie » pour l’inscrire dans un dossier partagé.
D’ici là, le titre responsable n’est pas que les humanoïdes d’usine ont atteint une fiabilité de 96 %. C’est que DeepMind a publié un taux de réussite de 96 % pour une preuve de concept de kitting sur Apollo 2, sur des lignes qu’elle identifie comme celles de Mercedes-Benz, sans les décomptes d’appui qu’un ingénieur de production exigerait habituellement.
En résumé
Gemini Robotics 2.5 est arrivé le 10 novembre 2026 avec une accroche d’usine : un taux de réussite de 96 % rapporté par DeepMind pour l’Apollo 2 d’Apptronik sur du kitting automobile, dans une preuve de concept que DeepMind dit avoir menée sur des lignes de production Mercedes-Benz à Kecskemét et Sindelfingen. Le pourcentage est réel en tant que chiffre rapporté par l’entreprise, et la tâche est sérieuse. Le billet ne publie ni le nombre d’essais, ni la définition du succès, ni le taux d’intervention, ni le temps de cycle, et AndBeyond.Tech n’a pas trouvé de communiqué autonome de Mercedes-Benz ou d’Apptronik confirmant ce 96 % (Google DeepMind, 10 nov. 2026). Pour les lecteurs qui suivent le kitting humanoïde en usine, c’est un véritable pas sur une ligne en activité — et encore une preuve de concept, non un relevé de poste achevé.
À lire aussi
- Les humanoïdes à l’usine : des vidéos de démo aux équipes complètes
- Jusqu’à 1 000 Apollo, si les essais se confirment
Références / Sources
- Google DeepMind — « Gemini Robotics 2.5 accelerates real-world general dexterity » (10 novembre 2026) : https://deepmind.google/blog/gemini-robotics-2-5-accelerates-real-world-physical-intelligence/
- Apptronik — « Apptronik and Mercedes-Benz Enter Commercial Agreement » (15 mars 2024) : https://apptronik.com/news-collection/apptronik-and-mercedes-benz-enter-commercial-agreement
Images : illustrations originales créées pour AndBeyond.Tech ; aucun logo ni aucune personne réelle n’y figurent.