Sans robot requis : AIRoA-0 et la montée en échelle de la manipulation à partir de pinces tenues à la main
La plupart des modèles de fondation pour robots continuent de monter en échelle avec le nombre de robots que l’on peut doter d’opérateurs, parce qu’il…
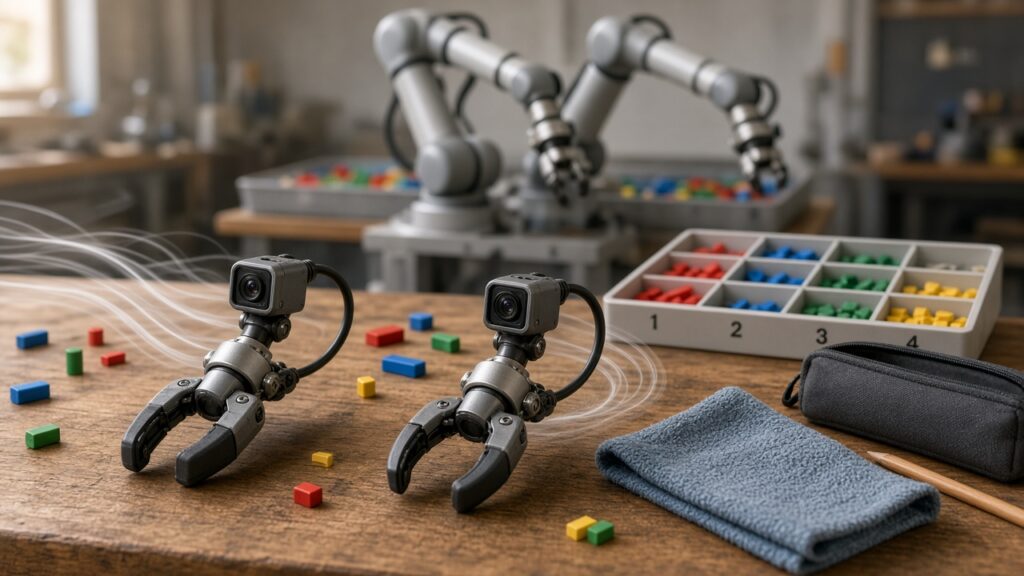
La plupart des modèles de fondation pour robots continuent de monter en échelle avec le nombre de robots que l’on peut doter d’opérateurs, parce qu’il faut quelqu’un pour les téléopérer afin de faire grandir le jeu de données. Un autre pari consiste à dire que le goulot devrait être les personnes, et non les bras : placer une caméra et un suiveur sur une pince tenue à la main, laisser quiconque enregistrer une tâche à une table de cuisine ou sur un établi, et n’installer la même pince sur un robot que plus tard.
Le 6 novembre 2026, l’AI Robot Association (AIRoA) du Japon a publié AIRoA-0 (A-0), un modèle vision-langage-action bimanuel entraîné de cette façon [1]. Le rapport technique qui l’accompagne, « AIRoA-0: Long-Horizon, Precise, Cross-Embodiment Manipulation from Handheld Data » (arXiv:2611.03815), est une prépublication arXiv et n’a pas été évalué par les pairs [2]. Le résultat mis en avant — 78 % de succès moyen contre 27 % pour le plus fort de quatre autres VLA post-entraînés sur les mêmes données de tâche — provient d’un protocole précis : dix tâches, quinze essais chacune, sur un Franka bimanuel, sur un site où aucune des données d’entraînement n’a été enregistrée, avec un crédit partiel pour les tâches inachevées [1][2][3].
Le présent article s’en tient à ces conditions, et indique clairement ce qui a été publié et ce qui ne l’a pas été.
L’idée : enregistrer avec ses mains, déployer sur tout bras qui accepte la pince
Le matériel est YUBI (Yielding Universal Bidigital Interface), une pince tenue à la main, en open source. Une personne tient une pince dans chaque main et exécute la tâche. Chaque pince porte une caméra au poignet et est suivie en six degrés de liberté ; l’enregistrement stocke les deux vues de poignet, la trajectoire de chaque pince, et le degré d’ouverture de chaque mâchoire [1][2]. La conception matérielle vient du Frontier Research Center de Toyota Motor Corporation ; le logiciel de collecte vient d’AIRoA ; les deux, indique AIRoA, sont déjà publiquement disponibles [1]. L’approche s’inscrit dans la lignée des outils de démonstration tenus à la main de type UMI [2][3].
Parce que la même pince se monte ensuite sur un robot comme effecteur terminal, les images et les actions restent dans un cadre partagé : ce que le démonstrateur voyait au poignet est proche de ce que le robot verra, et la politique produit des poses de pince (position et orientation), et non des angles d’articulation propres au robot. Le contrôleur de chaque plateforme convertit ensuite ces poses en mouvement de bras [1][2]. En principe, tout robot capable de porter YUBI peut exécuter les mêmes poids.
C’est aussi une contrainte. A-0 ne voit pas de caméra de tête ou de scène — seulement les deux vues de poignet — et rien dans les données d’entraînement ne montre un robot en train d’agir, d’échouer ou de se rattraper [2][3]. Un déploiement sur un site que les enregistreurs n’ont jamais visité est, selon les auteurs, la condition ordinaire de cette méthode, et non une épreuve de stress particulière [2].
Ce qui a été entraîné — et ce qui n’est pas encore public
AIRoA fait état de 16 151 heures de démonstrations YUBI bimanuelles, soit 10,65 millions de segments de sous-tâches (environ 5,5 secondes en moyenne) et 1,74 milliard de pas temporels à 30 Hz. Chaque segment porte une consigne de tâche et une consigne de sous-tâche. Le corpus couvre nettement plus d’une centaine de tâches, dont le prélèvement-placement, le tri, l’assemblage, l’insertion, le cheminement de câbles, l’ouverture et la fermeture, l’usage d’outils et les passations [2][3]. Partant des poids de base π0.5 publiés par Physical Intelligence, AIRoA indique n’avoir utilisé que ces données tenues à la main : ni téléopération, ni apprentissage par renforcement, ni corrections sur le robot [1][2].
Le système a quatre parties conçues ensemble : le traitement des données (filtrage, détection d’aberrations, recalage temporel), le pré-entraînement sur le corpus complet, le post-entraînement qui ajoute une prédiction de l’étape atteinte par la tâche et une mémoire du mouvement récent, et un harnais d’inférence qui lisse l’étape prédite et décode les actions en flux [2][3]. AIRoA indique qu’une nouvelle tâche peut être post-entraînée en moins de quatre heures sur un seul nœud de huit GPU H200 [3].
Le jeu de données de 16 151 heures lui-même n’a été qu’annoncé, et non publié. La prépublication et la page du projet indiquent que les auteurs « mettent à disposition » le corpus [2][3]. La mise à jour officielle d’AIRoA du 6 novembre est plus précise : l’organisation « prévoit de publier le jeu de données utilisé pour l’entraînement », et « les détails, y compris le calendrier de publication, le périmètre et les instructions d’usage, seront annoncés sur le site d’AIRoA une fois finalisés » [1]. À l’heure où nous écrivons, le corpus d’entraînement n’apparaît pas comme un jeu de données publié aux côtés des poids. Ce qui est sorti, selon la mise à jour officielle, ce sont des poids de modèles pré-entraînés et post-entraînés sur Hugging Face, ainsi que le code de collecte, de post-entraînement et d’inférence sur GitHub, proposés pour la recherche et le développement [1].
Tant que le jeu de données n’est pas effectivement livré, des groupes extérieurs peuvent affiner A-0 sur leurs propres enregistrements YUBI, mais ils ne peuvent ni relancer de façon indépendante le pré-entraînement à l’échelle rapportée, ni auditer les 16 151 heures.
Le résultat 78 % contre 27 %, avec son protocole
Tous les chiffres de comparaison ci-dessous proviennent de l’évaluation d’AIRoA, telle qu’elle est rapportée dans la mise à jour officielle, la page du projet et la prépublication [1][2][3]. Ce n’est pas une réévaluation indépendante.
Protocole [1][2][3] :
- Incarnation pour la comparaison principale : un Franka bimanuel.
- Site : distinct de tous les sites d’enregistrement — aucune des données d’entraînement n’y a été collectée.
- Tâches : 10 tâches bimanuelles, chacune spécifiée par une unique consigne donnée une fois au départ.
- Essais : 15 par tâche.
- Notation : taux de succès moyen sur ces essais, avec un crédit partiel lorsqu’une tâche n’est que partiellement achevée.
- A-0 : une même recette de post-entraînement sur chaque tâche.
- Baselines : quatre autres VLA — π0.5, Xiaomi-Robotics-1 (XR-1), GR00T N1.7 et MolmoAct2 — chacun partant de son point de contrôle pré-entraîné public, post-entraîné sur les mêmes démonstrations de tâche, l’article rapportant, pour chaque baseline, le meilleur résultat d’une recherche sur les horizons d’action, les fréquences d’action et le nombre de mises à jour [2].
| Tâche (heures de démos tenues à la main pour le post-entraînement) | A-0 | π0.5 | XR-1 | GR00T N1.7 | MolmoAct2 |
|---|---|---|---|---|---|
| Pliage de serviette (3,3 h) | 73 | 22 | 21 | 0 | 8 |
| Cubes-lettres (3,4 h) | 84 | 13 | 0 | 24 | 0 |
| Pyramide d’oranges (3,4 h) | 90 | 2 | 52 | 13 | 28 |
| Kitting de pièces (4,0 h) | 83 | 30 | 13 | 7 | 12 |
| Tri par couleurs (4,1 h) | 97 | 45 | 39 | 20 | 19 |
| Aspirateur robot (5,3 h) | 73 | 1 | 14 | 1 | 3 |
| Support de carburant (6,3 h) | 93 | 34 | 33 | 47 | 11 |
| Trousse (8,8 h) | 73 | 36 | 31 | 15 | 23 |
| Pyramide de tasses (17,9 h) | 80 | 71 | 11 | 23 | 36 |
| Écouteurs (25,8 h) | 30 | 13 | 18 | 10 | 3 |
| Moyenne | 78 | 27 | 23 | 16 | 14 |
Taux de succès en pourcentage ; chaque cellule est une moyenne sur 15 essais, avec crédit partiel. Source : tableau 1 de la prépublication AIRoA-0 [2].
Le chiffre de 27 % est donc la moyenne de π0.5 sous ce protocole — le plus fort des quatre baselines — et non un score générique « des autres modèles ». A-0 a aussi le taux de succès rapporté le plus élevé sur chaque tâche individuelle du tableau [2]. La dispersion à l’intérieur du tableau compte : le tri par couleurs atteint 97 %, tandis que les écouteurs restent à 30 % même pour A-0, de sorte que la moyenne ne signifie pas que chaque tâche précise de long horizon est résolue.
Plusieurs tâches durent des minutes. La prépublication décrit une séquence autonome d’entretien d’aspirateur d’environ deux minutes, dans laquelle la politique retire deux tampons de lavage usagés, en fixe deux neufs et extrait la brosse, le tout à partir de l’unique consigne donnée au départ [2]. Les autres compétences évaluées comprennent le tri de plus d’une douzaine de petites pièces dans des cases numérotées, le dézippage d’une trousse, son remplissage et sa fermeture, le pliage d’une serviette, l’empilement de tasses ou d’oranges, et le remplacement de pièces d’un aspirateur robot [1][2].
Les mêmes poids sur d’autres bras — et une perturbation en cours de tâche
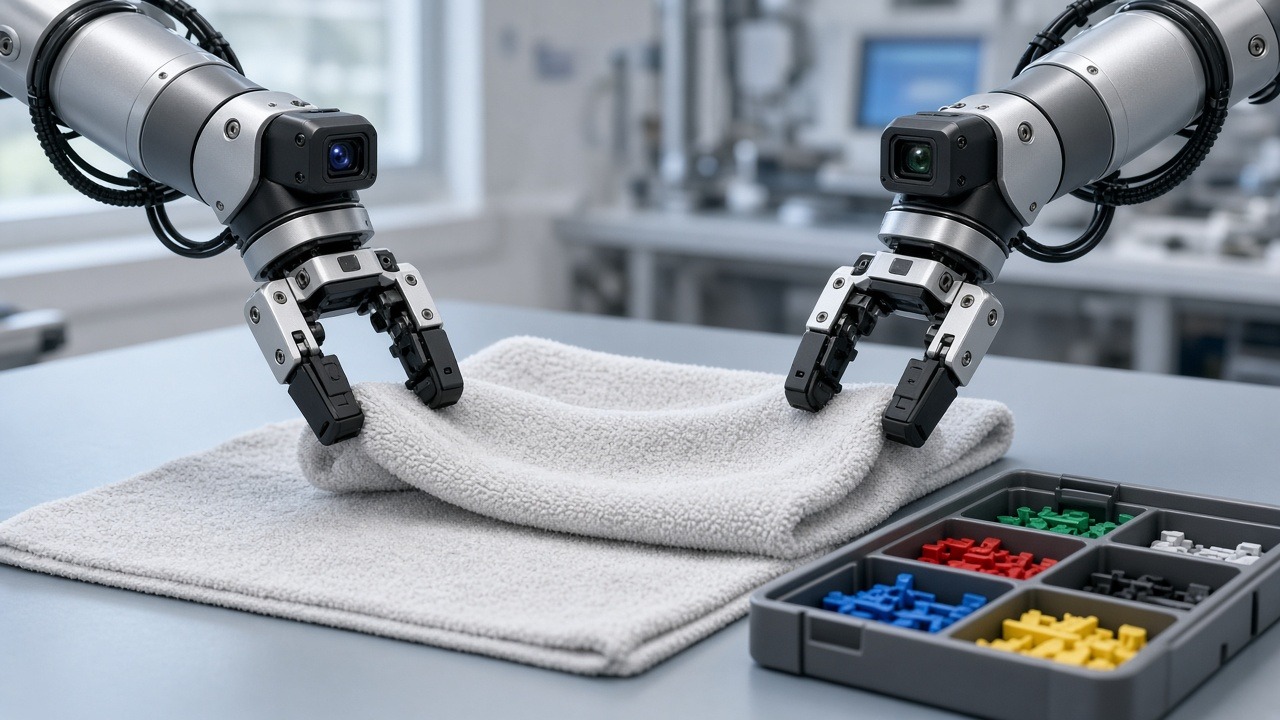
Parce que les actions vivent dans l’espace des poses de pince, AIRoA indique que les mêmes poids s’exécutent aussi, sans aucun réentraînement propre au corps, sur trois autres plateformes à deux bras qui montent YUBI : TX-G2 (décrit comme un humanoïde / semi-humanoïde), OpenArm, et une paire de bras industriels UR [1][2][3]. L’article décrit un sous-ensemble des dix tâches sur ces robots — par exemple les pyramides de tasses et d’oranges, la trousse et le tri par couleurs sur TX-G2 — et note à nouveau qu’aucune des données d’entraînement n’a été enregistrée sur ces plateformes [2]. Ces transferts qualitatifs étayent l’affirmation d’une conception « indépendante de l’incarnation » ; le tableau 78 % contre 27 % lui-même est le protocole Franka, 10 × 15, décrit plus haut.
Les auteurs rapportent aussi un test de perturbation sur le tri par couleurs : une personne déplace les bacs pendant que le robot place une pièce, et les bras se redirigent vers le bon bac en un mouvement continu, alors qu’aucun épisode d’entraînement n’avait montré un robot confronté à ce type d’interruption [1][2]. C’est une preuve d’existence utile que la politique ne rejoue pas une trajectoire mémorisée, mais il s’agit d’une expérience qualitative, et non d’un banc d’essai de robustesse noté.
Ce que cela change — et ce que cela ne change pas
La collecte tenue à la main s’attaque à un vrai goulot de l’apprentissage robotique : la téléopération est lente, et les flottes de robots sont coûteuses. Si 16 151 heures peuvent être rassemblées sans robot dans la boucle, la courbe de coût ressemble davantage à celle du recrutement de démonstrateurs qu’à celle de l’achat et de l’entretien de bras. Les courbes d’échelle d’AIRoA, sur la page du projet et dans la prépublication, soutiennent que davantage de données de pré-entraînement continue de réduire la perte d’action après post-entraînement, selon une tendance en loi de puissance sur des démonstrations tenues à l’écart [2][3].
Les limites sont tout aussi structurelles :
- Le robot doit toujours porter YUBI. Ce n’est pas une politique générale « prêt à l’emploi » pour des pinces et des montages de caméras arbitraires.
- Il n’y a pas de robot dans les données. Les comportements de rattrapage, les dynamiques de contact et les modes de défaillance qui n’apparaissent que sur le matériel manquent — c’est pourquoi les méthodes sim-to-real et l’apprentissage par renforcement résiduel ou en conditions réelles restent complémentaires, et non obsolètes.
- L’évaluation est celle des auteurs, sur dix tâches, sur un site Franka non vu, avec crédit partiel. Elle est plus solide qu’une bobine de démonstration, et plus faible qu’un banc d’essai multi-sites, mené par un tiers, tel que RoboColosseum.
- Le jeu de données de pré-entraînement n’est pas encore sorti, de sorte que l’affirmation d’échelle ne peut être ni réentraînée ni auditée de façon indépendante [1].
- Le rapport technique est une prépublication, et non un article évalué par les pairs [2].
AIRoA a présenté des travaux connexes à CoRL 2026 à Austin (9-12 novembre) et a publié les poids et les recettes afin que d’autres puissent post-entraîner de nouvelles tâches [1]. Le prochain test est de savoir si des groupes extérieurs au projet peuvent enregistrer avec YUBI, adapter A-0, et observer des gains similaires sous des protocoles qu’ils maîtrisent — surtout une fois que le jeu de données annoncé sera effectivement paru.
En résumé
AIRoA-0 est une tentative sérieuse de faire monter en échelle la manipulation bimanuelle sans collecter de données robotiques : 16 151 heures de démonstrations YUBI tenues à la main, un modèle qui produit des poses de pince, et une moyenne rapportée de 78 % contre 27 % sur dix tâches et quinze essais, sur un Franka, sur un site non utilisé pour l’enregistrement, avec crédit partiel, face au meilleur de quatre VLA post-entraînés sur les mêmes démonstrations de tâche. Ces chiffres appartiennent à AIRoA et à ce protocole. Le jeu de données d’entraînement est annoncé, non publié, et l’article est une prépublication non relue par les pairs. Les données tenues à la main sont peut-être bien la bonne manière d’élargir la couverture. Elles ne retirent pas, à elles seules, le robot de l’évaluation, de l’adaptation ni des derniers points de fiabilité.
À lire aussi
- Modèles vision-langage-action : la nouvelle couche de base des robots
- Sim-to-real en 2026 : combler l’écart sans données réelles à l’infini
- Après l’imitation : l’apprentissage par renforcement résiduel et en conditions réelles, nouvelle couche des politiques robotiques
- RoboColosseum et la course à la mesure de l’intelligence physique en conditions réelles
Références / Sources
- AIRoA — « AIRoA Releases “AIRoA-0” Robot Foundation Model » (6 novembre 2026). https://airoa.org/updates/20261106/832/
- Yueh-Hua (Kris) Wu, Kei Ota, Hanlong Li et al. — « AIRoA-0: Long-Horizon, Precise, Cross-Embodiment Manipulation from Handheld Data », arXiv:2611.03815, novembre 2026 (prépublication arXiv, non évaluée par les pairs). https://arxiv.org/abs/2611.03815
- AIRoA — page du projet AIRoA-0. https://a-0.airoa.io
- Lectures associées : AndBeyond.Tech — Modèles vision-langage-action : la nouvelle couche de base des robots ; Sim-to-real en 2026 ; Après l’imitation : l’apprentissage par renforcement résiduel et en conditions réelles ; RoboColosseum et la course à la mesure de l’intelligence physique.
Images : illustrations originales créées pour AndBeyond.Tech ; aucun logo ni aucune personne réelle n’y figurent.